文章
RL 基础
本文目录 9
背景
Markov
马尔可夫链和马尔可夫决策过程
markov决策过程是,
典型的场景有:
- 游戏决策
- 机器人控制
- 自动驾驶
而这些问题的共同特征都是当前动作会在影响下一个动作的同时,也会影响更远的未来;所以RL的出现原本是为了能够学习这种连续决策的能力
RL的过程
简单来说就是有一个state ,在某个environment中选择了action 之后,得到了一个新的state ;这个过程会被环境评分得到一个reward 。而RL的目标就是通过这个奖励的值,回去更新决策的模型
一些二级定义:
-
: 在s的情况下,选择了a的动作,最终将带来的reward
-
: 一条经过多个步骤的trajectory
-
: 从t时刻之后的长期的收益,,是折扣因子,因为越远的奖励对当前的决策的影响越小
RL的三大分类
对于想要从强化学习中得到什么,主要分为三大类:
- Value-based
- Policy-based
- Actor-Critic
Value-based
训练的是一个评分的模型,也就是输入s和a之后能得到Q的模型;这个奖励的过程是一个有意思的bootstrap 自举
流程如下:
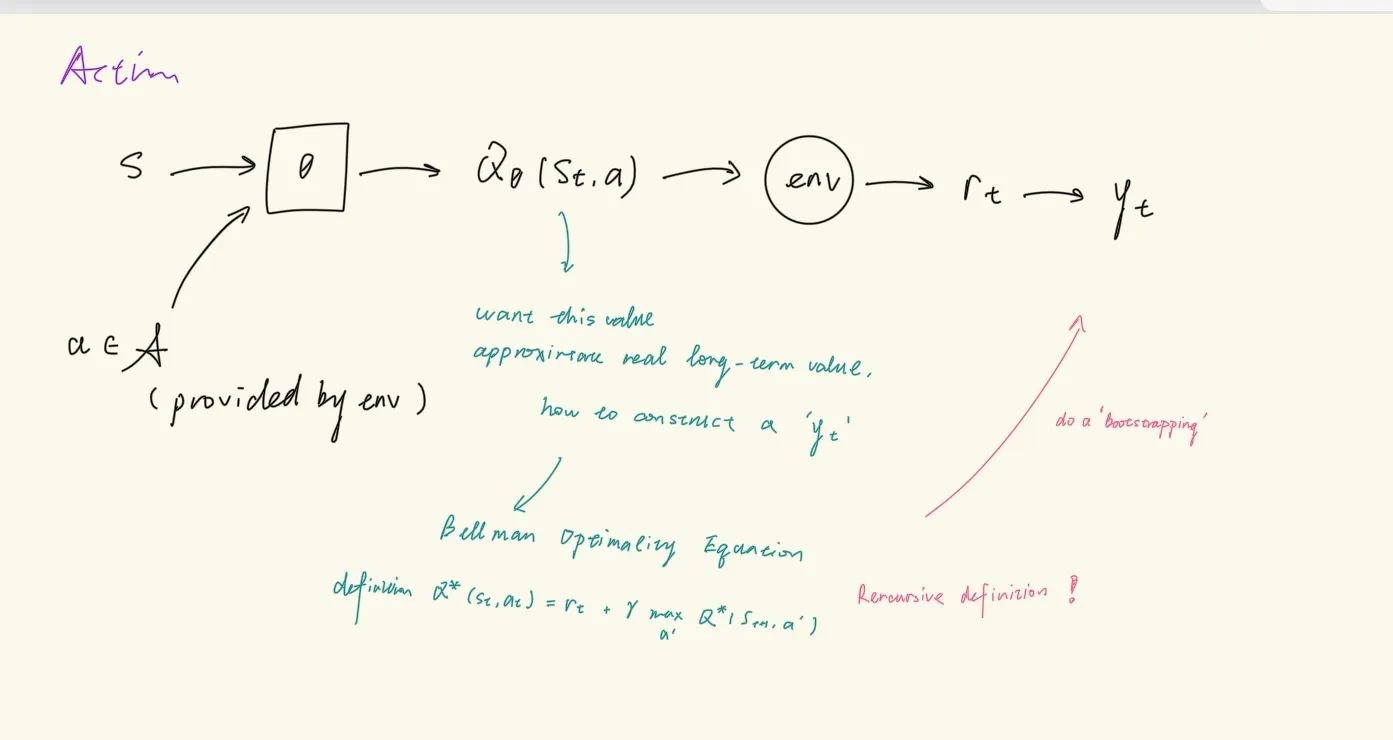
比如我这里对s_t情况下,发生动作a_t进行了了一个长期reward的评估
所以它监督的信号也是一个长期reward;这里的目标值使用的是
也就是长期累计的reward等于当前的reward(由环境决定,是决定正确的)加上估计的未来的累计reward(由Q模型自己估计)
所以这里是一个自举的训练,或者说是“从后向前”的训练,因为最后一步的就是
Policy-based
学习是一个策略的模型
最经典的算法是Policy Gradient,目标是增加输出“好”的action的概率,流程图如下
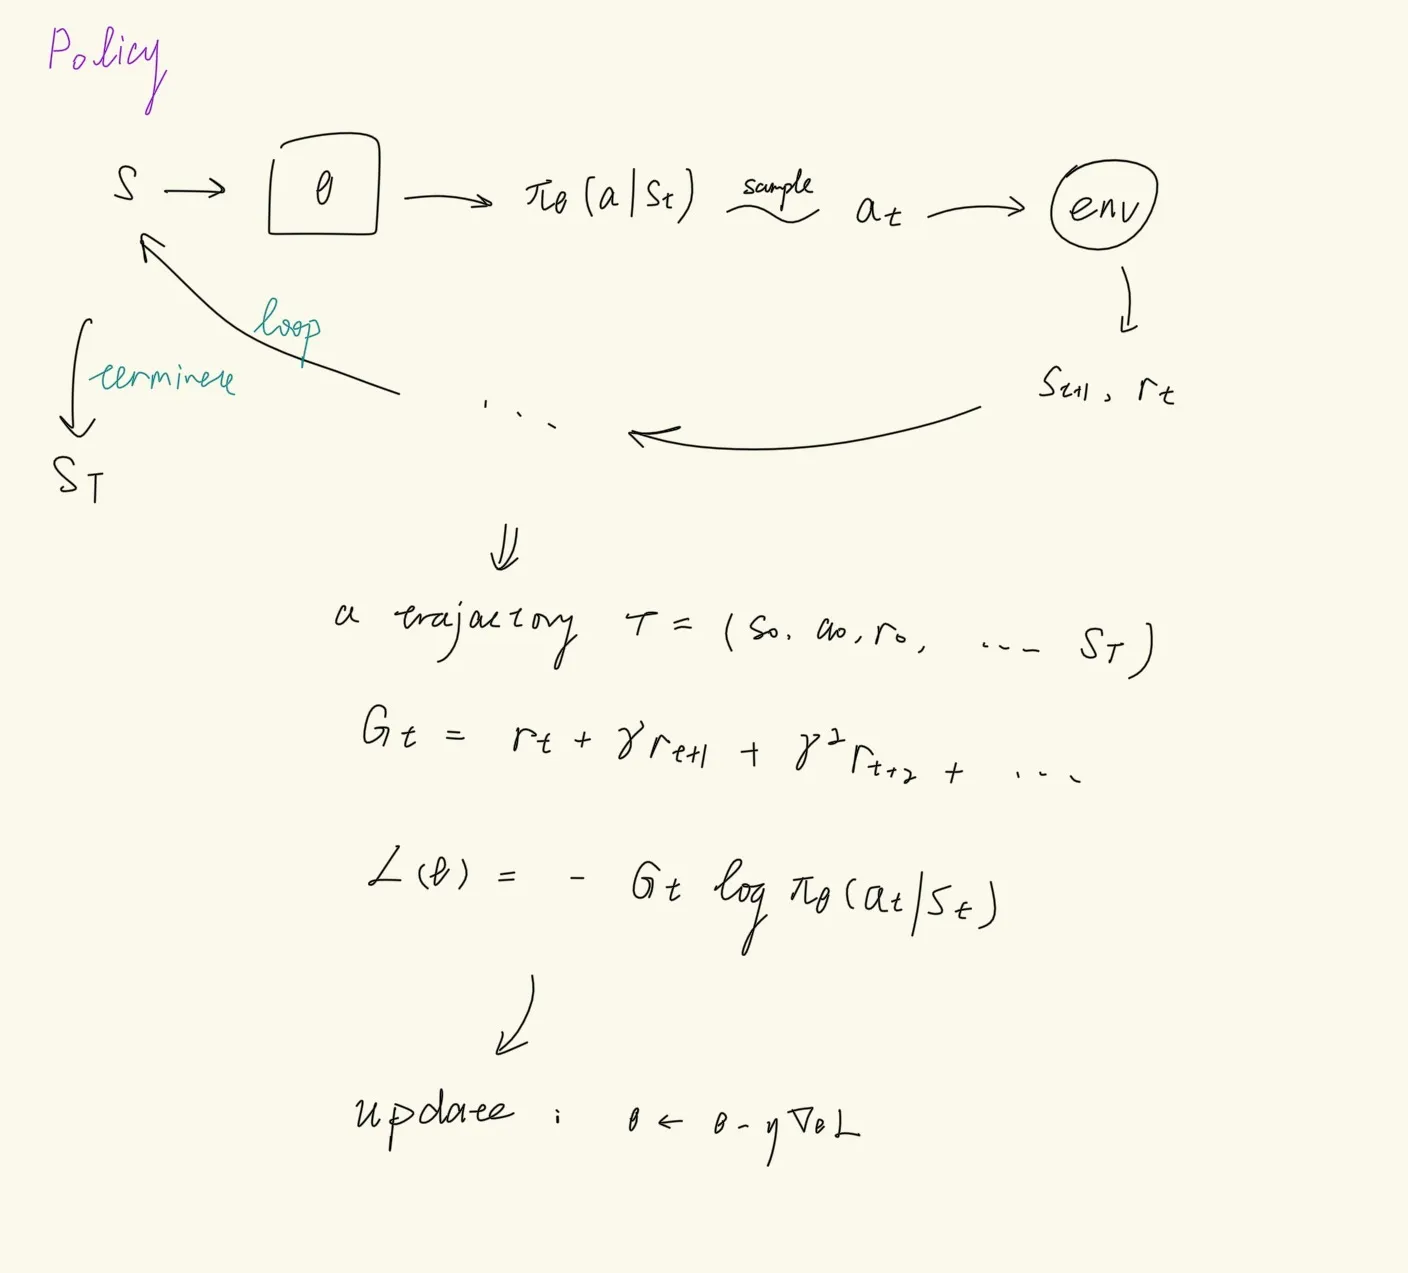
在跑完一个trajectory之后,根据这条路径得到的结果去更新策略
这里比较tricky的就是这个更新的过程,我们的目标是,是跑多条路径之后得到的奖励期望
我们的目标始终是:
其中:
- :policy 参数
- :当前 policy 产生轨迹 的概率
- :这条轨迹最终得到的 Return(累计回报)
如果直接展开期望,得到
问题在于期望的定义是对所有的情况做精确的加权求和,在训练里显然无法覆盖无穷无尽的情况,所以需要做一个sampling
这里选取Monte Carlo Estimation来逼近期望,他的公式是,随着N的增加,他的误差按下降
这个近似之所以没有概率的存在,是因为采样的频率,也就是样本出现的次数,充当了这个概率权重的作用
把这个带入到里,得到的是,这是很坏的。因为G是由环境打出来的分数,他不是连续的计算,和模型之间是没有梯度的,求导的结果永远是0,也就无法更新参数
所以为了在做近似的同时,能够保护这个概率,需要用到一个trick,就是。如果能先做梯度的计算,就能把里面变成的形式,这样在P被采样消耗掉之后,还能保留logP的梯度,避免了梯度的消失
也就是
因为G关于不可导,把拿到求和里面之后,得到
\nabla_\theta J(\theta) = \sum_{y} G(y) \nabla_\theta P_\theta(y)\tag{1}
利用梯度的等式,
\nabla_\theta J(\theta) = \sum_{y} G(y) \cdot P_\theta(y) \nabla_\theta \log P_\theta(y) \tag{3}
这时候再应用一下采样,得到最终的梯度
总结一下就是:
不能先把期望通过 sampling 化成单纯的 reward 平均再求导;而是先对期望求导,把参数化概率分布的梯度显式提取出来,再对这个梯度期望进行 Monte Carlo 估计
我们再带入
得到多轮rollout之后N条trajectory的梯度就是:
注:
这里使用的是整条轨迹后更新,是trajectory-level的;REINFORCE通常是这种方式
另外一种更新方式是step-wise的,下面在Actor-Critic里会介绍到
Actor-Critic
              state
                │
       ┌────────┴────────┐
       ↓                 ↓
     Actor             Critic
       ↓                 ↓
   选择 action         评价局势
       │                 │
       └──────┬──────────┘
              ↓
         更新 Actor
策略梯度的问题是会不稳定;同时因为它使用的是总分R,可能会让某些已经表现的比较好的trajectory获得更多的训练,同时它因环境的变化可能导致比较大的方差
因此使用一个相对的分数=实际奖励-期望奖励更好
于是引入了Value Function状态价值函数,这个就是critic model的职责
然后得到一个Advantage,
当我们有了value function之后,就可以像最开始的Value-based一样,通过一个bootstrap的估计来进行一个自举,只不过这里要得到的对象是,把他替换成
于是也得到了一个Advantage的估计,给他一个新的名字TD Error,Temporal-Difference Error,时序差分误差
这样,我们在第t步的时候就能得到这个TD error ,无需等待轨迹结束便可进行反向传播,每一步都执行更新
同理,也可以参照Q-learning的方法,继续构造来更新Critic的权重
critic 相当于生成评分的模型,actor相当于生成policy的模型
RL和LLM的结合
有人说语言也是具有markov性质的一串字符,而LLM本身天然就是一个Policy,它做的事情就是
所以二者可以直接对应
RL                         LLM

state s             =     当前上下文
action a            =     下一个 token
policy π(a|s)       =     LLM 的 next-token distribution
trajectory          =     一整段生成文本
当我们对LLM的要求越来越高,我们希望它能:
- 解决更多的问题
- 更加安全
- 能推理出正确的答案
- 让代码通过测试
这些目标往往难以通过传统的监督学习达到一个很好的效果,这也是后来的RLHF的核心思想
PPO
Proximal Policy Optimization
基本上还是Actor-Critic,但是限制每次的policy不要更新太猛
他出现的原因就是普通的策略梯度容易在一步的更新中更新过头,所以有必要限制一下每次更新的幅度
定义一个ratio
再加一个clipping
最后的loss是
展开min里面的一个来看看,得到
可以看到和actor-critic也就差了一个系数,
GRPO
Group Relative Policy Optimization,用组内的相对值来替代Critic的输出
可以看成是PPO-style policy update + group-relative advantage - Critic
对于一组的rollout,他的一组的rollout的最终的Reward的平均值为,那么Advantage可以认为就是;
注意这里用的是最终的Reward,而不是G
如果用G的话,GRPO也能做,不过可能比较难算G