文章
pytorch框架
本文目录 7
Pytorch框架学习
用 Pytorch 的时候都是用 llm 生成的代码,只会往nn模块里加点功能层,调用它提供的 Loss
现在有空了多了解一点
Pytorch中重要的元素
1. Tensor
tensor,张量,是记录一个多维空间里的点或向量的容器
它可以是 标量->向量->矩阵->张量
2.Autograd N Dynamic Computation Graph
Pytorch 最特色的就是它的自动求导,他会在执行前向传播的时候记录下一个动态图,相当于实时构建与销毁一个 DAG
只需要在初始化 Tensor 的时候传入requires_grad = true
动态计算图的优点有:
- 更加灵活,更适用于条件判断或递归
- 方便调试和修改,能直接查看中间结果
3. nn.Module
neural network模块是对复杂运算的封装,同时兼容与优化器torch.optim一起使用
相当于一个大的黑盒子(整个 ResNet)里面可以装着很多中等的黑盒子(Residual Block),中等的里面装着小的黑盒子(Conv2d / ReLU等等)
要想定义一个 model,有两张方法:使用 自定义类 或者是用 Sequential
| 特性 | 自定义类 (继承 nn.Module) | nn.Sequential |
|---|---|---|
| forward 定义 | 必须手动定义 | 自动按顺序执行 |
| 灵活性 | 高(可以有任何复杂逻辑) | 低(只能是简单顺序结构) |
| 适用场景 | 复杂网络、多分支、跳跃连接 | 简单顺序网络、快速原型 |
Sequential
无需定义新的类,只用按顺序组合层
model = nn.Sequential(
    nn.Conv2d(3, 32, 3),
    nn.ReLU(),
    nn.Conv2d(32, 64, 3),
    nn.ReLU(),
    nn.Flatten(),
    nn.Linear(64 * 26 * 26, 10)
)
自定义
从 nn.module继承一个子类,需要在__init__的时候定义网络层,同时在forward中定义数据流动的顺序
流程
-
目标(Loss Function):定义一个“完美状态”与“当前状态”的距离
-
感知(Forward):系统根据现有参数对输入做出判断
-
反馈(Backward):系统发现判断错了,利用微积分算出梯度下降的方向
-
修正(Optimizer):根据反馈,微调参数
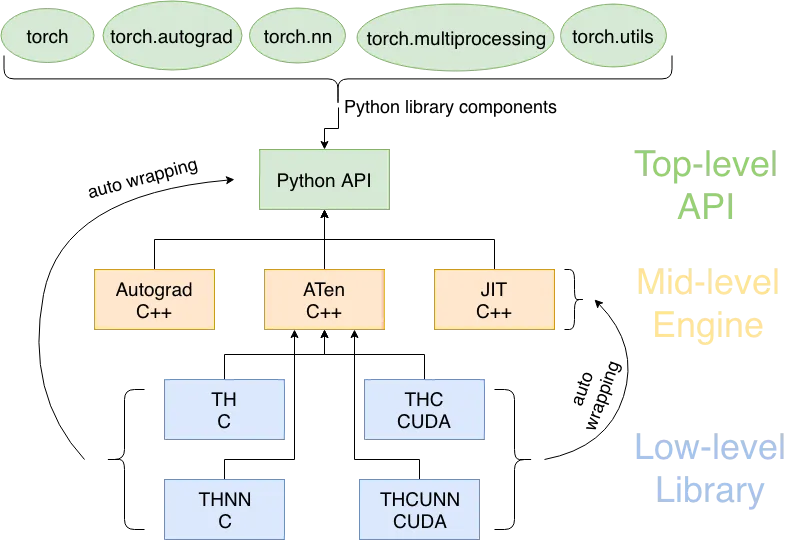
Pytorch架构
示意图如下
┌─────────────────────────────────────────────────────────────┐
│                    PyTorch 生态系统                          │
├─────────────────────────────────────────────────────────────┤
│  torchvision  │  torchtext  │  torchaudio  │  其他专业库     │
├─────────────────────────────────────────────────────────────┤
│                     PyTorch 核心                            │
├───────────────┬─────────────────┬───────────────────────────┤
│   torch.nn    │   torch.optim   │      torch.utils          │
│   (神经网络)   │   (优化器)      │      (工具函数)           │
├───────────────┼─────────────────┼───────────────────────────┤
│               │                 │   torch.utils.data        │
│  torch 核心   │  autograd       │   (数据加载)              │
│  (张量计算)    │  (自动微分)     │                           │
└───────────────┴─────────────────┴───────────────────────────┘