文章
PEARL
本文目录 4
PEARL 论文阅读
之前读 EAGLE 的时候就看到这位老哥在底下附上这篇 paper,最近要看 PD 分离有关的文字,正好看看这篇,记录一下
Core Idea
传统的 SD 基于这样的原则:在完成一个序列的 Draft token的输出之后才进行一次验证,也就是说验证和推理天然存在一个逻辑上的先后关系,验证的同时是没有推理的进行的,推理的同时也无法进行验证
为了能够让这两个过程并行起来,PEARL提出了两种验证的策略来帮助
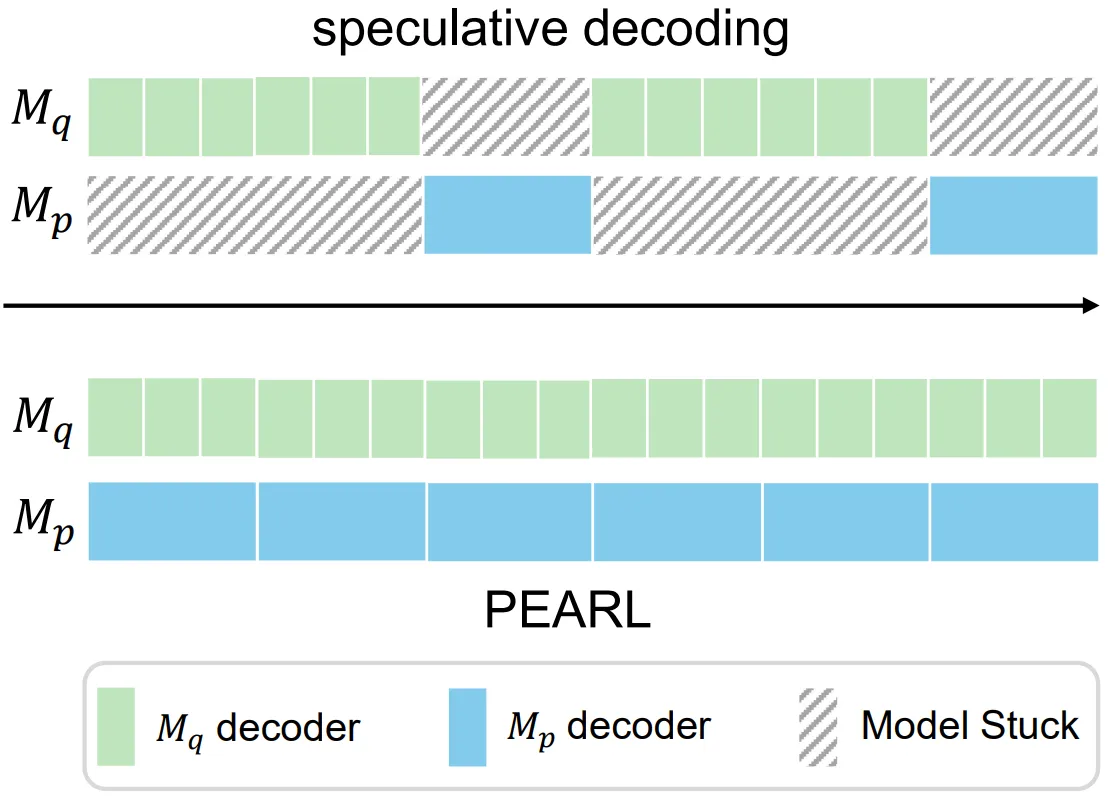
Core Concept
两种验证策略,pre-verify和post-verify:
pre:这个策略的目标就是为了打破验证要在完整推测之后发生的限制,对prefix,在第一个 Draft Token出现的同时就进行验证,如果第一个就不接受,后面的都不会接受;同时这个做法也没有打破逻辑上的先后关系,感觉所有的推理中其实都可以使用这种利用资源的办法post:这个 verify 旨在打破 vanilla Speculative Decoding 中 draft 的生成要等待 verify 结束来提供一个prefix,将多次 draft generation 之间的间隔合并;换句话说,假如一次的 draft token 生成中全对,那么就能继续接着生成,draft model 还有没发挥完的潜力,所以不需要 verify 生成的 prefix 去“打扰”现在健康的生成;而当错误的验证发生的时候,就要重回到 pre 的验证阶段
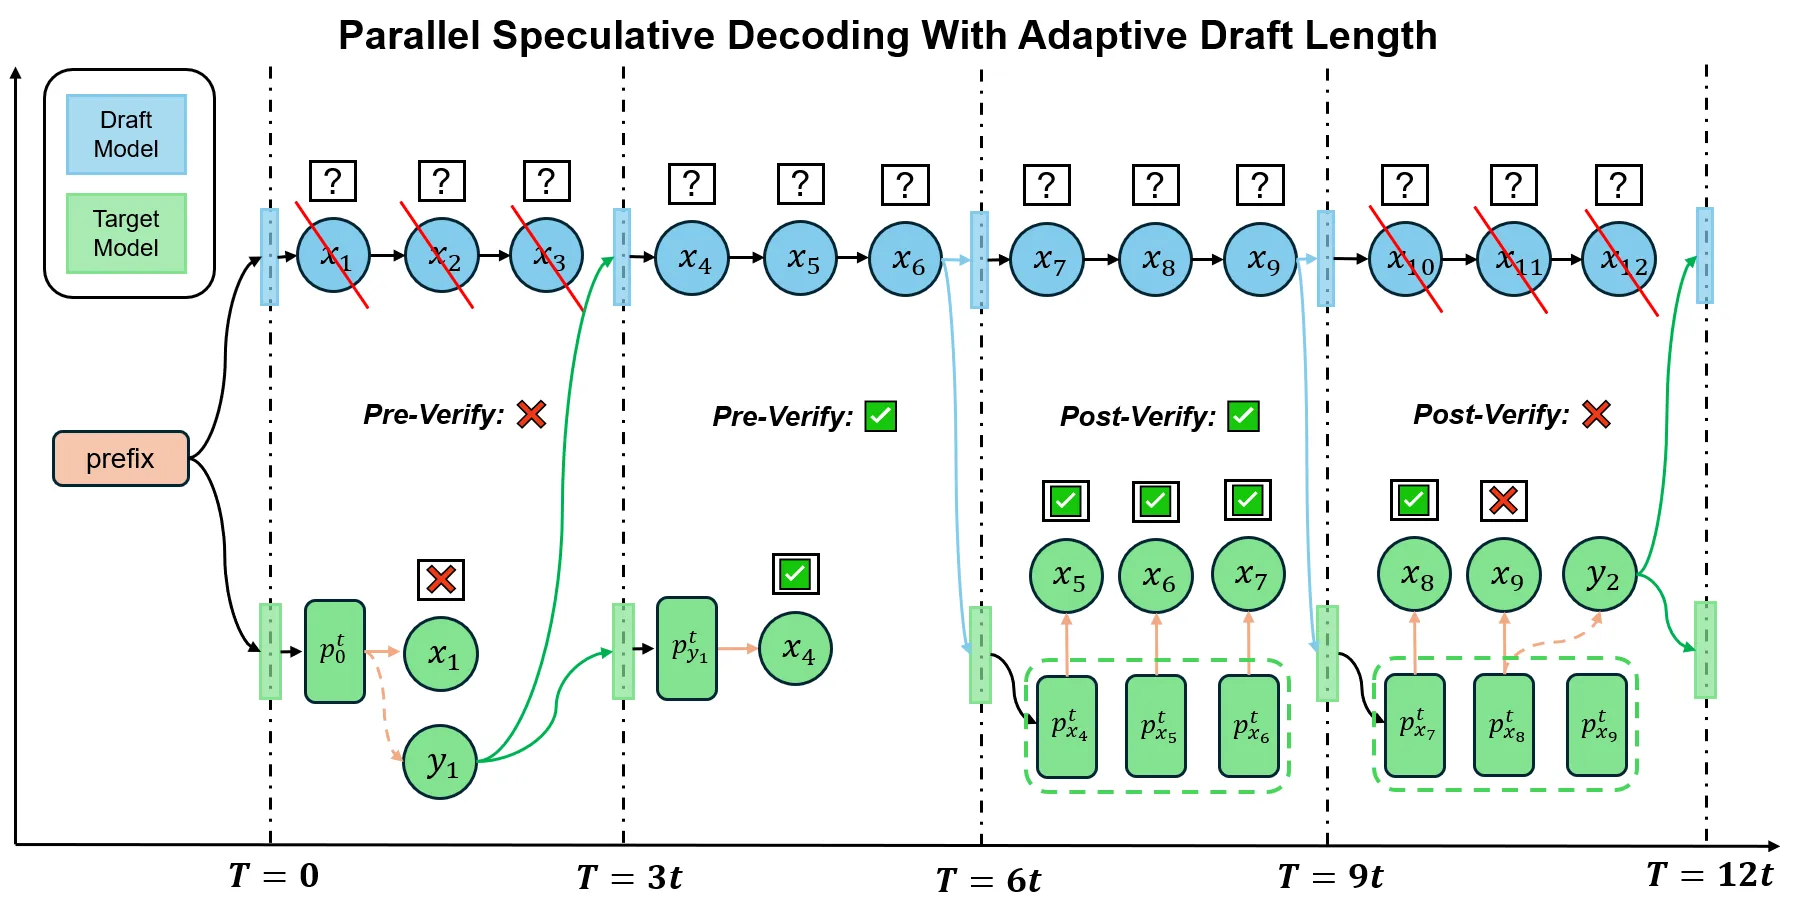
也就是说,vanilla实现是先draft生成个token,然后target进行验证,两者是交替进行的,这样会有两个空档期:
- candidate生成阶段,target model的空档
- verify阶段,draft model的空档
而对应这两个空档,这里就是在draft生成的时候,让target去多跑一次本不应该跑的verify;但是由于现在并没有candidate生成,所以“verify”是不成立的,这里的pre-verify实际上就是target去做了一次decoding,生成了一个新的token。只要这个过程比生成个candidate要慢,就能在真正的verify也就是post-verify之前做一次有收益的剪枝;
相应的,在post-verify的时候,draft model也在继续生成。最坏的情况是verify失败,这次生成的candidate都丢弃,但是这也并没用损失(不是服务情况下,应该不考虑算力的浪费);只要verify成功,则一定会带来不同程度的收益
Thinking
这个方法看起来挺natural的,但是就像pipeline里的分支预测那样,依赖于预测方向的可能性,也就是 draft 的接受率,
推导了一个计算公式,假设
- generate time
- verify time
- 一次draft生成的最大长度
- 每个token的接受率
- 一个section的时间
从一次推理的开始出发,也就是从一次pre-verify出发,一共有两种可能:verify 成功 / 失败
失败的情况下,
而成功的情况下,有可能连续进行多次的post-verity,概率为
进行一下加权的计算,得到
而 vanilla SD的平均收益
简单取,= 4,得到了如下的图像,可以看到接受率高的时候是有显著的收益的
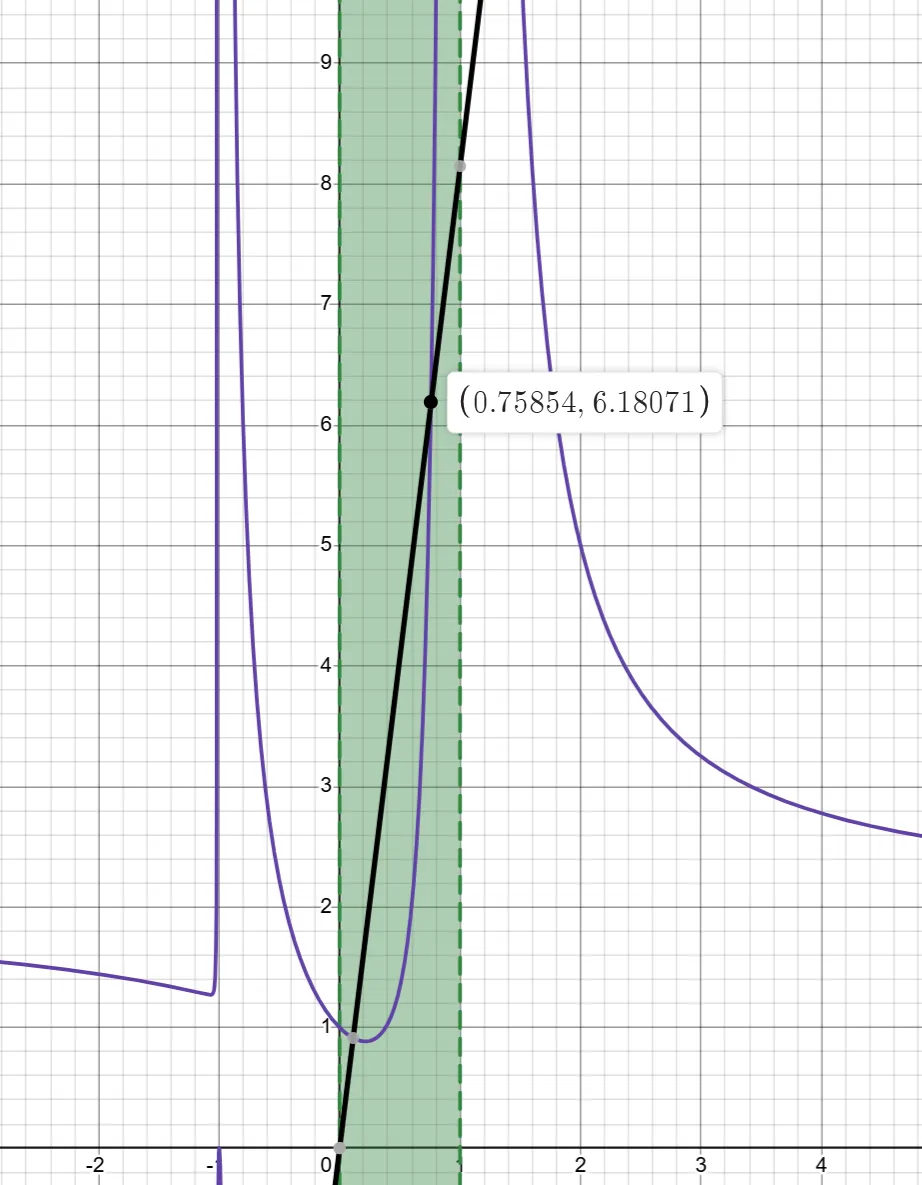
而且随着接受序列的边长,接受率是会下降的,也就是说真实的情况下不是等比数列,效果还要差一点