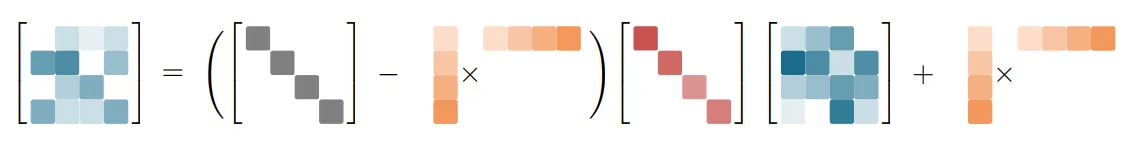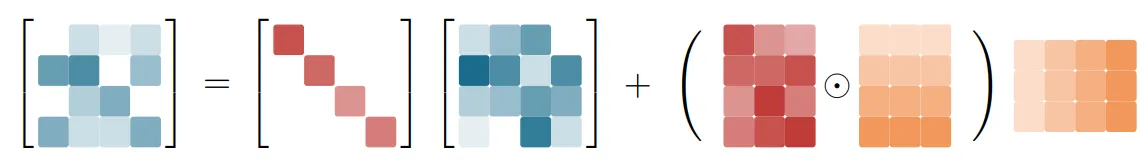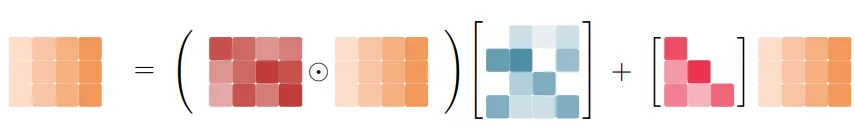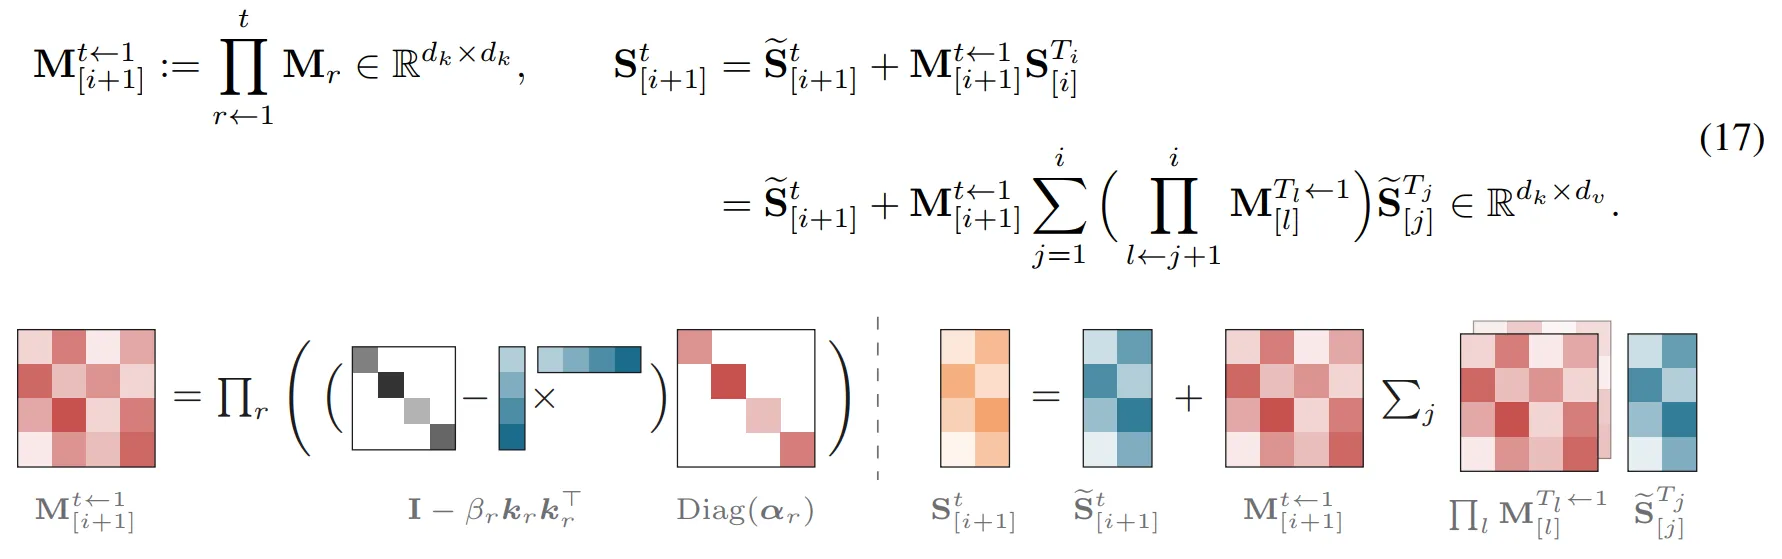Abstract
kimi在前天发布了k3的技术报告,跟进一下技术
施工中,飞书文档基本完成了,等待整理之后迁移过来
Intro
Intro
Scaling Law 的两个维度:train-scale,test-time scale
train: scales information flow across sequence length, network depth, and model width
Model Architecture
原生多模态MoE,1M上下文
2.8T,104B激活参数,93层
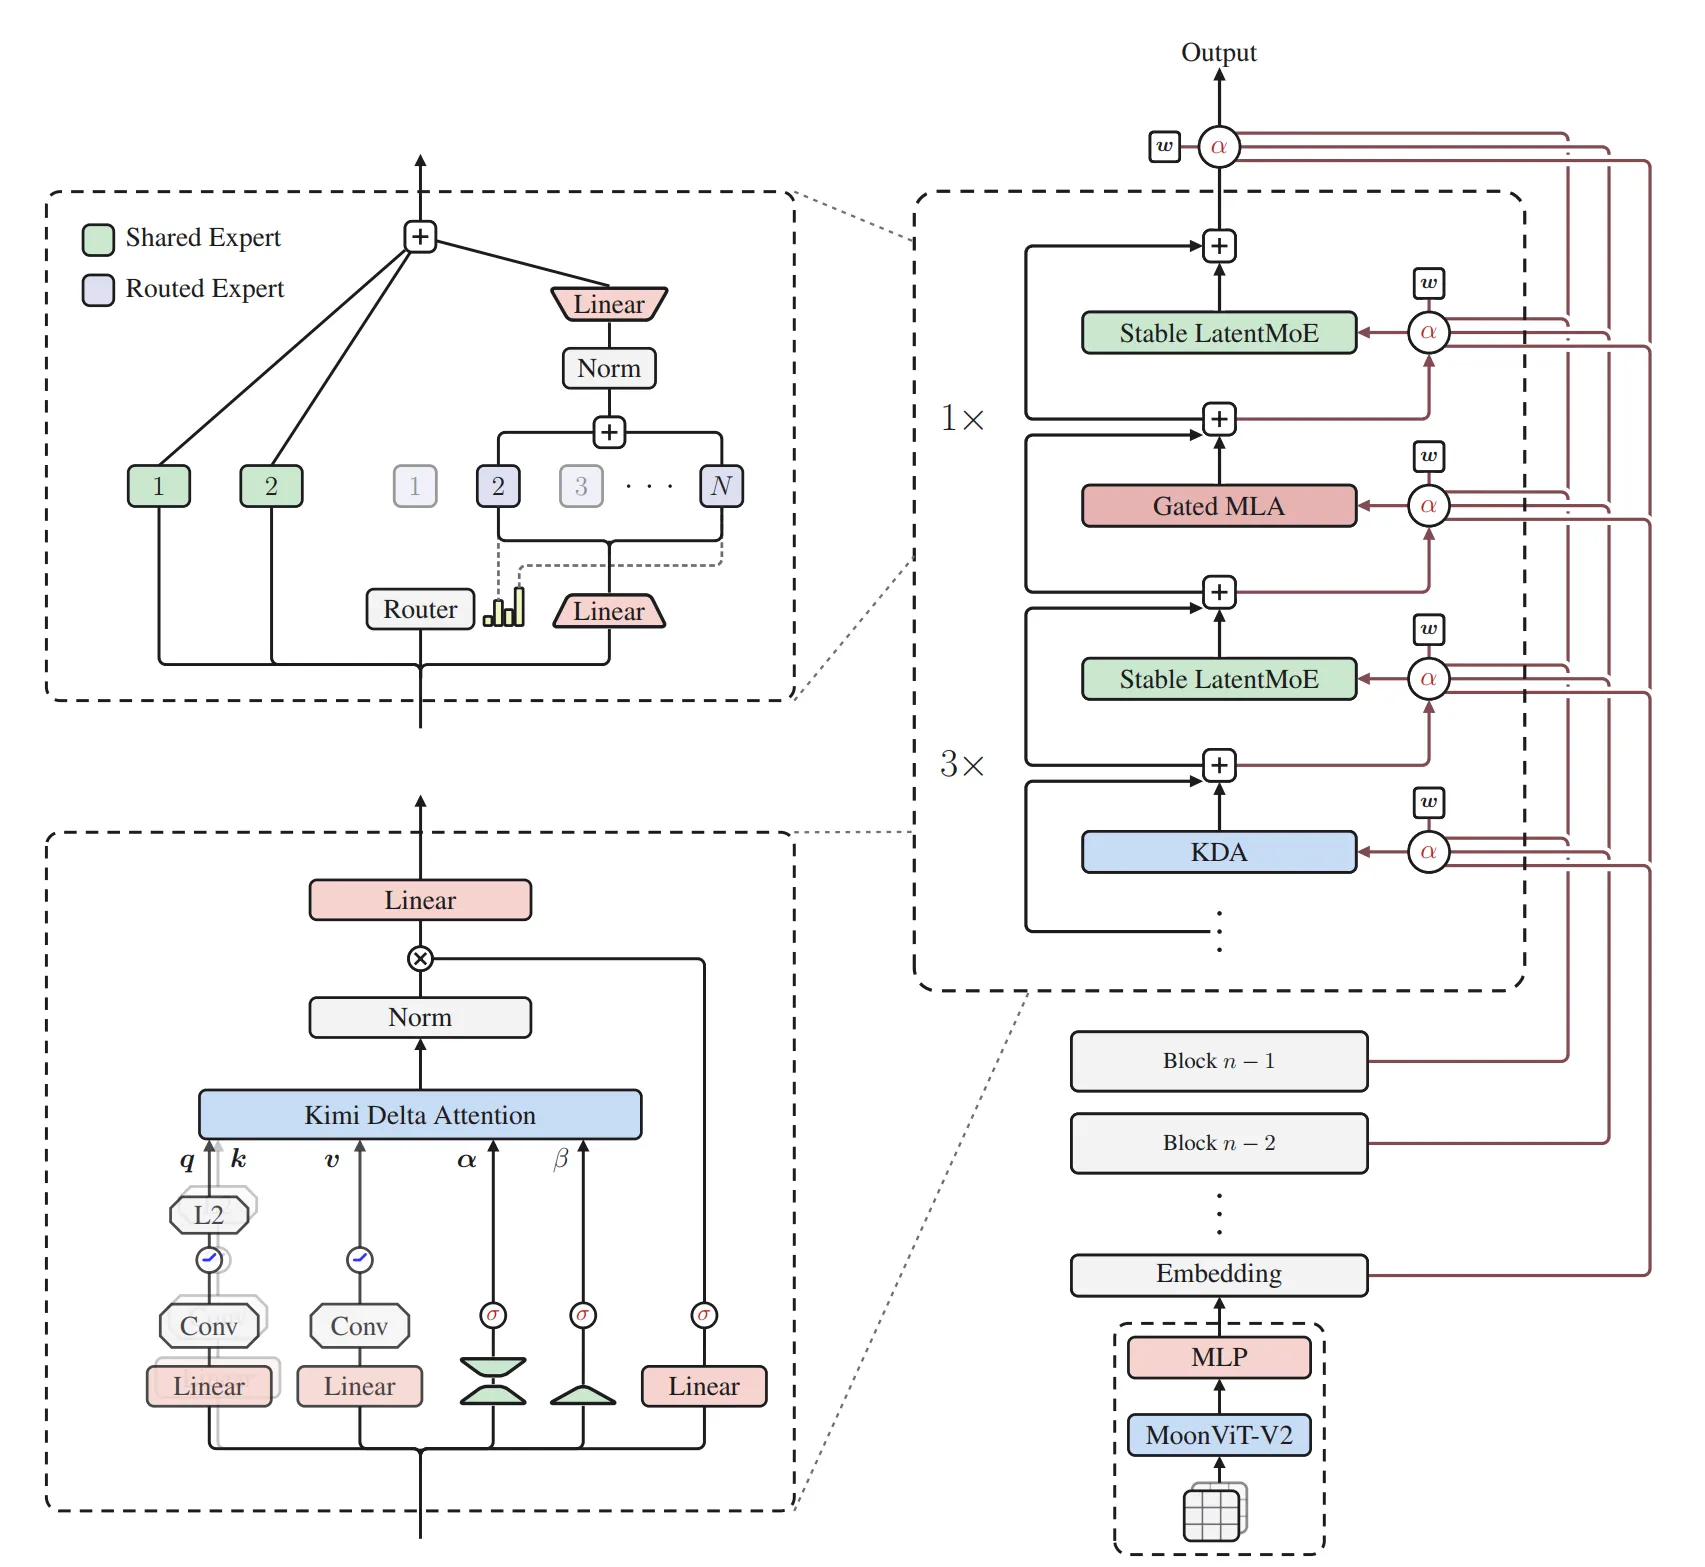
3*KDA+MoE
1*MLA+MoE(用的是NoPE 的MLA,并且在输出之后加了一个gate)
k3这里采用的是3层KDA+1层MLA的基础结构
vision
KDA
Kimi Delta Attention,一种线性注意力
背景
从 Standard Attention 的问题到linear attention
标准 Attention 的计算是:
O = softmax ( Q K ⊤ ) V \mathbf{O} = \text{softmax}\left(\mathbf{Q} \mathbf{K}^\top\right) \mathbf{V} O = softmax ( Q K ⊤ ) V 展开来看,对于第 (i) 个 query:
o i = ∑ j = 1 T exp ( q i ⊤ k j ) ∑ l = 1 T exp ( q i ⊤ k l ) ⋅ v j \mathbf{o}_i = \sum_{j=1}^{T} \frac{\exp\left(\mathbf{q}_i^\top \mathbf{k}_j\right)}{\sum_{l=1}^{T} \exp\left(\mathbf{q}_i^\top \mathbf{k}_l\right)} \cdot \mathbf{v}_j o i = j = 1 ∑ T ∑ l = 1 T exp ( q i ⊤ k l ) exp ( q i ⊤ k j ) ⋅ v j 复杂度问题 :
需要计算所有 (T \times T) 对 ( (\mathbf{q}_i, \mathbf{k}_j) ) 的点积。
计算复杂度是 (O(T^2))。
当 (T = 1,000,000) 时,(T^2 = 10^{12}),是一个非常夸张的数字
问题的根源在于softmax无法应用分配率分别分配到Q和K上进行计算,也就是说softmax 把 Q 和 K 耦合在一起了。
点积 q i ⊤ k j \mathbf{q}_i^\top \mathbf{k}_j q i ⊤ k j T 2 T^2 T 2 q i \mathbf{q}_i q i k j \mathbf{k}_j k j ∑ l exp ( q i ⊤ k l ) \sum_{l} \exp(\mathbf{q}_i^\top \mathbf{k}_l) ∑ l exp ( q i ⊤ k l ) q i \mathbf{q}_i q i
Linear Attention 的核心思路就在于把不可展开的 softmax 替换成成可以展开的核函数 ,利用矩阵乘法的结合律 ,把计算顺序从 ( Q K ⊤ ) V (\mathbf{Q} \mathbf{K}^\top) \mathbf{V} ( Q K ⊤ ) V Q ( K ⊤ V ) \mathbf{Q} (\mathbf{K}^\top \mathbf{V}) Q ( K ⊤ V )
Attention ( Q , K , V ) = ϕ ( Q ) ⋅ ( ϕ ( K ) ⊤ V ) \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \phi(\mathbf{Q}) \cdot \left( \phi(\mathbf{K})^\top \mathbf{V} \right) Attention ( Q , K , V ) = ϕ ( Q ) ⋅ ( ϕ ( K ) ⊤ V ) 这里 ϕ ( ⋅ ) \phi(\cdot) ϕ ( ⋅ ) 特征映射 ,把点积相似度替换成核函数:
exp ( q ⊤ k ) ≈ ϕ ( q ) ⊤ ϕ ( k ) \exp(\mathbf{q}^\top \mathbf{k}) \approx \phi(\mathbf{q})^\top \phi(\mathbf{k}) exp ( q ⊤ k ) ≈ ϕ ( q ) ⊤ ϕ ( k ) 为了支持自回归生成,我们把上面的矩阵形式写成递归形式 。
定义 记忆状态(Memory State) :
S t = ∑ i = 1 t k i v i ⊤ ∈ R d k × d v \mathbf{S}_t = \sum_{i=1}^{t} \mathbf{k}_i \mathbf{v}_i^\top \in \mathbb{R}^{d_k \times d_v} S t = i = 1 ∑ t k i v i ⊤ ∈ R d k × d v 这个 S t \mathbf{S}_t S t 所有历史 key-value 对的外积和 ,它把整个历史压缩成了一个固定大小的矩阵。
第 t t t
o t = S t ⊤ q t \mathbf{o}_t = \mathbf{S}_t^\top \mathbf{q}_t o t = S t ⊤ q t 更新记忆状态
S t = S t − 1 + k t v t ⊤ \mathbf{S}_t = \mathbf{S}_{t-1} + \mathbf{k}_t \mathbf{v}_t^\top S t = S t − 1 + k t v t ⊤ Linear attn :
移除无法应用结合律的softmax
记忆S是无限累积的键值外积和,永不遗忘
所有历史信息权重相等(无衰减)
简单高效,但长序列中旧信息会淹没新信息
S t = S t − 1 + K t ⊗ V t O t = S t @ Q t \begin{aligned}
S_t &= S_{t-1} + K_t \otimes V_t \\
O_t &= S_t @ Q_t
\end{aligned} S t O t = S t − 1 + K t ⊗ V t = S t @ Q t Delta Networks:
引入增量规则(Delta Rule),只记忆“预测不精准”的部分
记忆无衰减
S t = S t − 1 + ( V t − S t − 1 @ K t ) ⊗ K t O t = S t @ Q t \begin{aligned}
S_t &= S_{t-1} + (V_t - S_{t-1} @ K_t) \otimes K_t \\
O_t &= S_t @ Q_t
\end{aligned} S t O t = S t − 1 + ( V t − S t − 1 @ K t ) ⊗ K t = S t @ Q t Gated Delta Networks
引入遗忘门α \alpha α β \beta β
S t = α t ∗ S t − 1 + β t ∗ ( V t − S t − 1 @ K t ) ⊗ K t O t = S t @ Q t \begin{aligned}
S_t &= \alpha_t * S_{t-1} + \beta_t * (V_t - S_{t-1} @ K_t) \otimes K_t \\
O_t &= S_t @ Q_t
\end{aligned} S t O t = α t ∗ S t − 1 + β t ∗ ( V t − S t − 1 @ K t ) ⊗ K t = S t @ Q t Kimi Delta Attention
使用 fine-grained diagonal gateDiag ( α t ) \text{Diag}(\alpha_t) Diag ( α t )
S t = ( I − β t k t k t ⊤ ) D i a g ( α t ) S t − 1 + β t k t v t ⊤ S_t = \left( I - \beta_t k_t k_t^\top \right) \textcolor{red}{{Diag}(\alpha_t)} S_{t-1} + \beta_t k_t v_t^\top S t = ( I − β t k t k t ⊤ ) D ia g ( α t ) S t − 1 + β t k t v t ⊤
对比GDN的公式
S t = α t ( I − β t k t k t ⊤ ) S t − 1 + β t k t v t ⊤ S_t = \textcolor{red}{\alpha_t}\left( I - \beta_t k_t k_t^\top \right) S_{t-1} + \beta_t k_t v_t^\top S t = α t ( I − β t k t k t ⊤ ) S t − 1 + β t k t v t ⊤
遗忘门被放在了类householder变换进行之前,因此它可以精准控制记忆矩阵里不同通道 的衰减速度,而不是整个记忆矩阵都用一个标量
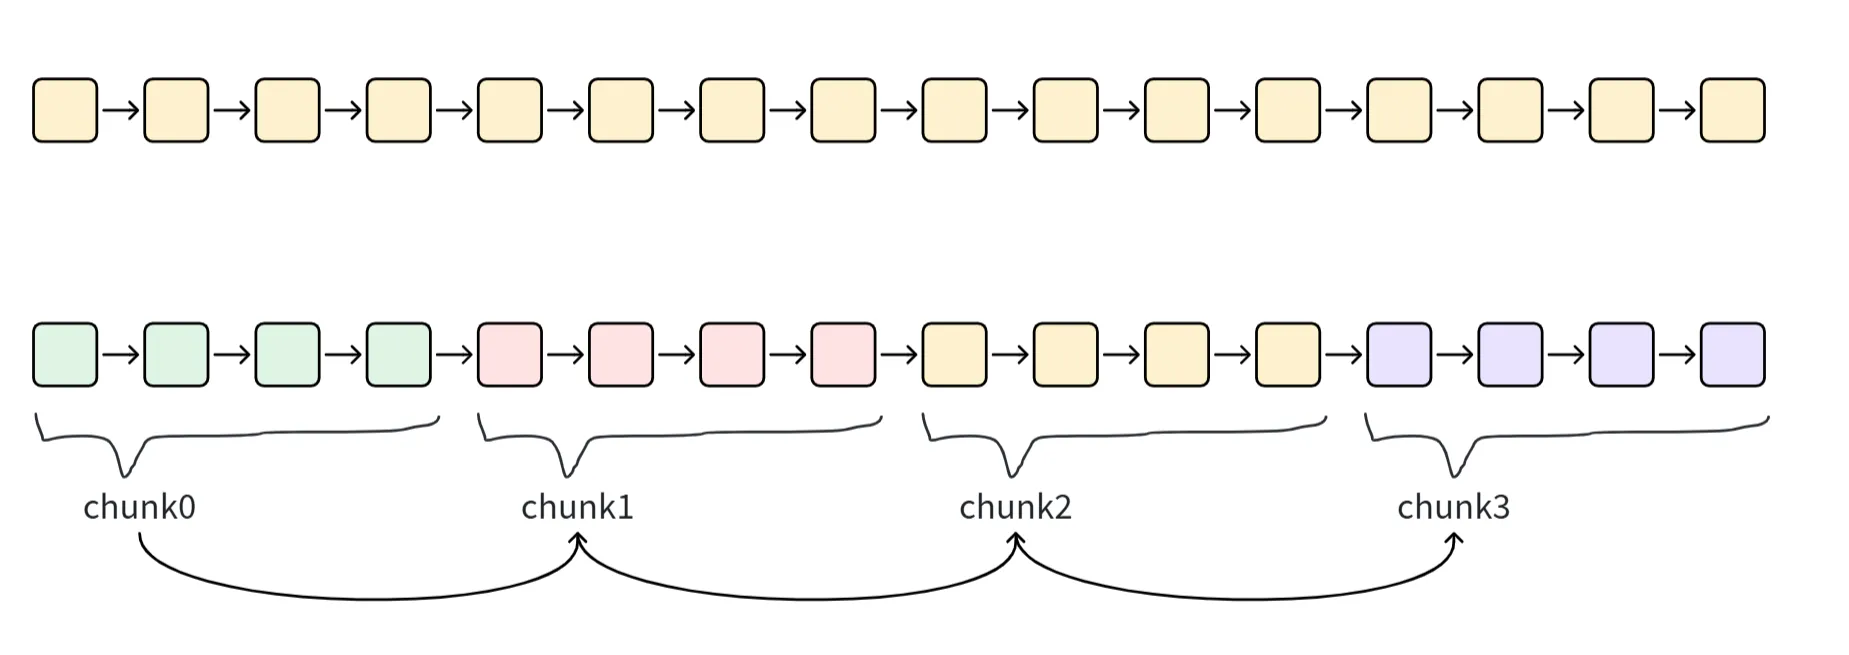
Chunkwise 形式linear attn引入gated之后,他的并行性就消失了
对于prefill 阶段,
黄色块代表了现在KDA的串行过程,这个过程的硬件利用率是很低的,为了改善,KDA还有一种chunk内“并行”,chunk间串行的形式
对于最原始的linear attn(无遗忘),全都是加法,因此由结合律,计算顺序是随意的,可以进行任意的并行;
但是加入遗忘门之后,运算就不只是简单的累积了,用递推公式表示记忆矩阵之间的关系:
S r [ t ] = ( ∏ i = 1 r ( I − β i [ t ] k i [ t ] k i [ t ] ⊤ ) D i a g ( α i [ t ] ) ) S 0 [ t ] + ∑ i = 1 r ( ∏ j = i + 1 r ( I − β j [ t ] k j [ t ] k j [ t ] ⊤ ) D i a g ( α j [ t ] ) ) β i [ t ] k i [ t ] v i [ t ] ⊤ S_r^{[t]} = \left( \prod_{i=1}^{r} \left( I - \beta_i^{[t]} k_i^{[t]} k_i^{[t]\top} \right) \mathrm{Diag}(\alpha_i^{[t]}) \right) S_0^{[t]} + \sum_{i=1}^{r} \left( \prod_{j=i+1}^{r} \left( I - \beta_j^{[t]} k_j^{[t]} k_j^{[t]\top} \right) \mathrm{Diag}(\alpha_j^{[t]}) \right) \beta_i^{[t]} k_i^{[t]} v_i^{[t]\top} S r [ t ] = ( ∏ i = 1 r ( I − β i [ t ] k i [ t ] k i [ t ] ⊤ ) Diag ( α i [ t ] ) ) S 0 [ t ] + ∑ i = 1 r ( ∏ j = i + 1 r ( I − β j [ t ] k j [ t ] k j [ t ] ⊤ ) Diag ( α j [ t ] ) ) β i [ t ] k i [ t ] v i [ t ] ⊤
当然也存在着完全并行的方法,就是并行计算上面这个递推公式,他们当中的变量都是能直接算出来的(α \alpha α β \beta β
问题是这样伴随着的矩阵的累乘,他的计算量
TODO:paper里的WY表示+UT transform这里略去,不影响这里的讲解
这里的上标代表chunk的idx;而大写的字母代表的是把整个chunk所有的向量堆叠起来行程的矩阵;下面直接给出了论文最后给出的计算公式
M [ t ] = ( I + StrictTril ( Diag ( β [ t ] ) ( Γ 1 → C [ t ] ⊙ K [ t ] ) ( K [ t ] Γ 1 → C [ t ] ) ⊤ ) ) − 1 Diag ( β [ t ] ) M^{[t]} = \left( I + \text{StrictTril}\left( \text{Diag}(\beta^{[t]}) \left( \Gamma_{1\to C}^{[t]} \odot K^{[t]} \right) \left( \frac{K^{[t]}}{\Gamma_{1\to C}^{[t]}} \right)^\top \right) \right)^{-1} \text{Diag}(\beta^{[t]}) M [ t ] = ( I + StrictTril ( Diag ( β [ t ] ) ( Γ 1 → C [ t ] ⊙ K [ t ] ) ( Γ 1 → C [ t ] K [ t ] ) ⊤ ) ) − 1 Diag ( β [ t ] )
W [ t ] = M [ t ] ( Γ 1 → C [ t ] ⊙ K [ t ] ) , U [ t ] = M [ t ] V [ t ] W^{[t]} = M^{[t]} \left( \Gamma_{1\to C}^{[t]} \odot K^{[t]} \right), \quad U^{[t]} = M^{[t]} V^{[t]} W [ t ] = M [ t ] ( Γ 1 → C [ t ] ⊙ K [ t ] ) , U [ t ] = M [ t ] V [ t ]
S [ t + 1 ] = Diag ( γ C [ t ] ) S [ t ] + ( Γ i → C [ t ] ⊙ K [ t ] ) ⊤ ( U [ t ] − W [ t ] S [ t ] ) ∈ R d k × d v S^{[t+1]} = \text{Diag}(\gamma_C^{[t]}) S^{[t]} + \left( \Gamma_{i\to C}^{[t]} \odot K^{[t]} \right)^\top \left( U^{[t]} - W^{[t]} S^{[t]} \right) \in \mathbb{R}^{d_k \times d_v} S [ t + 1 ] = Diag ( γ C [ t ] ) S [ t ] + ( Γ i → C [ t ] ⊙ K [ t ] ) ⊤ ( U [ t ] − W [ t ] S [ t ] ) ∈ R d k × d v
O [ t ] = ( Γ 1 → C [ t ] ⊙ Q [ t ] ) S [ t ] ⏟ inter chunk + Tril ( ( Γ 1 → C [ t ] ⊙ Q [ t ] ) ( K [ t ] Γ 1 → C [ t ] ) ⊤ ) ⏟ intra chunk ( U [ t ] − W [ t ] S [ t ] ) ⏟ "pseudo"-value term ∈ R C × d v O^{[t]} = \underbrace{\left( \Gamma_{1\to C}^{[t]} \odot Q^{[t]} \right) S^{[t]}}_{\text{inter chunk}} + \underbrace{\text{Tril}\left( \left( \Gamma_{1\to C}^{[t]} \odot Q^{[t]} \right) \left( \frac{K^{[t]}}{\Gamma_{1\to C}^{[t]}} \right)^\top \right)}_{\text{intra chunk}} \underbrace{\left( U^{[t]} - W^{[t]} S^{[t]} \right)}_{\text{"pseudo"-value term}} \in \mathbb{R}^{C \times d_v} O [ t ] = inter chunk ( Γ 1 → C [ t ] ⊙ Q [ t ] ) S [ t ] + intra chunk Tril ( Γ 1 → C [ t ] ⊙ Q [ t ] ) ( Γ 1 → C [ t ] K [ t ] ) ⊤ "pseudo"-value term ( U [ t ] − W [ t ] S [ t ] ) ∈ R C × d v
推导 这里推导里的U U U ( U [ t ] − W [ t ] S [ t ] ) ⏟ "pseudo"-value term \underbrace{\left( U^{[t]} - W^{[t]} S^{[t]} \right)}_{\text{"pseudo"-value term}} "pseudo"-value term ( U [ t ] − W [ t ] S [ t ] )
1. 带遗忘门的完整递推公式
S t = Diag ( α t ) ⋅ S t − 1 + u t ⊗ k t S_t = \text{Diag}(\alpha_t) \cdot S_{t-1} + u_t \otimes k_t S t = Diag ( α t ) ⋅ S t − 1 + u t ⊗ k t
u t = β t ⋅ ( v t − S t − 1 ⋅ k t ) u_t = \beta_t \cdot \big( v_t - S_{t-1} \cdot k_t \big) u t = β t ⋅ ( v t − S t − 1 ⋅ k t )
2. 展开状态:初始状态和每个历史写入的贡献
S r = Diag ( γ r ) ⋅ S 0 ⏟ 初始状态的贡献 + ∑ i = 1 r Diag ( γ r γ i ) ⋅ ( u i ⊗ k i ) ⏟ 第 i 步写入的贡献 S_r = \underbrace{\text{Diag}(\gamma_r) \cdot S_0}_{\text{初始状态的贡献}} + \sum_{i=1}^{r} \underbrace{\text{Diag}\left(\frac{\gamma_r}{\gamma_i}\right) \cdot (u_i \otimes k_i)}_{\text{第 } i \text{ 步写入的贡献}} S r = 初始状态的贡献 Diag ( γ r ) ⋅ S 0 + ∑ i = 1 r 第 i 步写入的贡献 Diag ( γ i γ r ) ⋅ ( u i ⊗ k i )
γ t = ∏ j = 1 t α j \gamma_t = \prod_{j=1}^{t} \alpha_j γ t = ∏ j = 1 t α j
3. 把展开式代入 u r u_r u r
S r − 1 = Diag ( γ r − 1 ) ⋅ S 0 + ∑ i = 1 r − 1 Diag ( γ r − 1 γ i ) ⋅ ( u i ⊗ k i ) S_{r-1} = \text{Diag}(\gamma_{r-1}) \cdot S_0 + \sum_{i=1}^{r-1} \text{Diag}\left(\frac{\gamma_{r-1}}{\gamma_i}\right) \cdot (u_i \otimes k_i) S r − 1 = Diag ( γ r − 1 ) ⋅ S 0 + ∑ i = 1 r − 1 Diag ( γ i γ r − 1 ) ⋅ ( u i ⊗ k i )
S r − 1 ⋅ k r = Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r + ∑ i = 1 r − 1 Diag ( γ r − 1 γ i ) ⋅ u i ⋅ ( k i T ⋅ k r ) S_{r-1} \cdot k_r = \text{Diag}(\gamma_{r-1}) \cdot S_0 \cdot k_r + \sum_{i=1}^{r-1} \text{Diag}\left(\frac{\gamma_{r-1}}{\gamma_i}\right) \cdot u_i \cdot (k_i^T \cdot k_r) S r − 1 ⋅ k r = Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r + ∑ i = 1 r − 1 Diag ( γ i γ r − 1 ) ⋅ u i ⋅ ( k i T ⋅ k r )
u r = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r ) − β r ⋅ ∑ i = 1 r − 1 Diag ( γ r − 1 γ i ) ⋅ u i ⋅ ( k i T ⋅ k r ) u_r = \beta_r \cdot \big( v_r - \text{Diag}(\gamma_{r-1}) \cdot S_0 \cdot k_r \big) - \beta_r \cdot \sum_{i=1}^{r-1} \text{Diag}\left(\frac{\gamma_{r-1}}{\gamma_i}\right) \cdot u_i \cdot (k_i^T \cdot k_r) u r = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r ) − β r ⋅ ∑ i = 1 r − 1 Diag ( γ i γ r − 1 ) ⋅ u i ⋅ ( k i T ⋅ k r )
4. 移项得到标准线性方程组 ( I + A ) U = (I + A)U = ( I + A ) U =
u r + β r ⋅ ∑ i = 1 r − 1 Diag ( γ r − 1 γ i ) ⋅ u i ⋅ ( k i T ⋅ k r ) = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r ) u_r + \beta_r \cdot \sum_{i=1}^{r-1} \text{Diag}\left(\frac{\gamma_{r-1}}{\gamma_i}\right) \cdot u_i \cdot (k_i^T \cdot k_r) = \beta_r \cdot \big( v_r - \text{Diag}(\gamma_{r-1}) \cdot S_0 \cdot k_r \big) u r + β r ⋅ ∑ i = 1 r − 1 Diag ( γ i γ r − 1 ) ⋅ u i ⋅ ( k i T ⋅ k r ) = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r )
( I + A ) ⋅ U = B (I + A) \cdot U = B ( I + A ) ⋅ U = B
B r = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r ) B_r = \beta_r \cdot \big( v_r - \text{Diag}(\gamma_{r-1}) \cdot S_0 \cdot k_r \big) B r = β r ⋅ ( v r − Diag ( γ r − 1 ) ⋅ S 0 ⋅ k r )
A r , i = β r ⋅ Diag ( γ r − 1 γ i ) ⋅ ( k i T ⋅ k r ) , i < r A_{r,i} = \beta_r \cdot \text{Diag}\left(\frac{\gamma_{r-1}}{\gamma_i}\right) \cdot (k_i^T \cdot k_r), \quad i < r A r , i = β r ⋅ Diag ( γ i γ r − 1 ) ⋅ ( k i T ⋅ k r ) , i < r
5. 输出 O r O_r O r
O r = Q r ⋅ S r = Q r ⋅ Diag ( γ r ) ⋅ S 0 + ∑ i = 1 r Q r ⋅ Diag ( γ r γ i ) ⋅ ( u i ⊗ k i ) O_r = Q_r \cdot S_r = Q_r \cdot \text{Diag}(\gamma_r) \cdot S_0 + \sum_{i=1}^{r} Q_r \cdot \text{Diag}\left(\frac{\gamma_r}{\gamma_i}\right) \cdot (u_i \otimes k_i) O r = Q r ⋅ S r = Q r ⋅ Diag ( γ r ) ⋅ S 0 + ∑ i = 1 r Q r ⋅ Diag ( γ i γ r ) ⋅ ( u i ⊗ k i )
O r = Q r ⋅ Diag ( γ r ) ⋅ S 0 + ∑ i = 1 r ( Q r ⋅ Diag ( γ r / γ i ) ⋅ k i ) ⋅ u i O_r = Q_r \cdot \text{Diag}(\gamma_r) \cdot S_0 + \sum_{i=1}^{r} \big( Q_r \cdot \text{Diag}(\gamma_r / \gamma_i) \cdot k_i \big) \cdot u_i O r = Q r ⋅ Diag ( γ r ) ⋅ S 0 + ∑ i = 1 r ( Q r ⋅ Diag ( γ r / γ i ) ⋅ k i ) ⋅ u i
O = ( Q ⊙ Γ ) ⋅ S 0 + Tril ( ( Q ⊙ Γ ) ⋅ ( K ⊘ Γ ) T ) ⋅ U O = (Q \odot \Gamma) \cdot S_0 + \text{Tril}\big( (Q \odot \Gamma) \cdot (K \oslash \Gamma)^T \big) \cdot U O = ( Q ⊙ Γ ) ⋅ S 0 + Tril ( ( Q ⊙ Γ ) ⋅ ( K ⊘ Γ ) T ) ⋅ U
6. 跨块状态更新
S C = Diag ( γ C ) ⋅ S 0 + ∑ i = 1 C Diag ( γ C γ i ) ⋅ ( u i ⊗ k i ) S_C = \text{Diag}(\gamma_C) \cdot S_0 + \sum_{i=1}^{C} \text{Diag}\left(\frac{\gamma_C}{\gamma_i}\right) \cdot (u_i \otimes k_i) S C = Diag ( γ C ) ⋅ S 0 + ∑ i = 1 C Diag ( γ i γ C ) ⋅ ( u i ⊗ k i )
S next = Diag ( γ C ) ⋅ ( S 0 + ∑ i = 1 C Diag ( 1 γ i ) ⋅ ( u i ⊗ k i ) ) S_{\text{next}} = \text{Diag}(\gamma_C) \cdot \left( S_0 + \sum_{i=1}^{C} \text{Diag}\left(\frac{1}{\gamma_i}\right) \cdot (u_i \otimes k_i) \right) S next = Diag ( γ C ) ⋅ ( S 0 + ∑ i = 1 C Diag ( γ i 1 ) ⋅ ( u i ⊗ k i ) )
S next = Diag ( γ C ) ⋅ ( S 0 + ( K ⊘ Γ ) T ⋅ U ) S_{\text{next}} = \text{Diag}(\gamma_C) \cdot \left( S_0 + (K \oslash \Gamma)^T \cdot U \right) S next = Diag ( γ C ) ⋅ ( S 0 + ( K ⊘ Γ ) T ⋅ U )
分析
原先的串行计算,等效计算的结果是 6 次 headdim x headdim
对于 head dim 128而言,这个在现代 GPU 上面是纯粹的 compute bound. 如果按这个写法来计算,KDA 很难在 Prefill打满 *访存带宽 ,被* cuda cores bound 住了,同时,由于 KDA同时拥有 deltarule 和 *遗忘门 ,这使得使用这个公式训练必须间隔存储 KDA的中间状态(类似于 KV* Cache **, 每个头大小是 128 x 128 的 FP32矩阵 )。这进一步加深了训练 深层网络 的显存压力和访存压力。初步估算 内存带宽 *的极限大概是 1T/s。
把原本超长的串行计算,变成了在解U的时候的
矩阵化,将秩1矩阵(向量)变成大矩阵
记忆矩阵的读写减少,在一个
串行延迟隐藏
Tensor core
Gated MLA
y t = W o [ Sigmoid ( W g x t ) ⊙ o ~ t ] y_t = W_o \left[ \text{Sigmoid}(W_g x_t) \odot \tilde{o}_t \right] y t = W o [ Sigmoid ( W g x t ) ⊙ o ~ t ]
其中o ~ t \tilde{o}_t o ~ t x t x_t x t
Attention Residuals
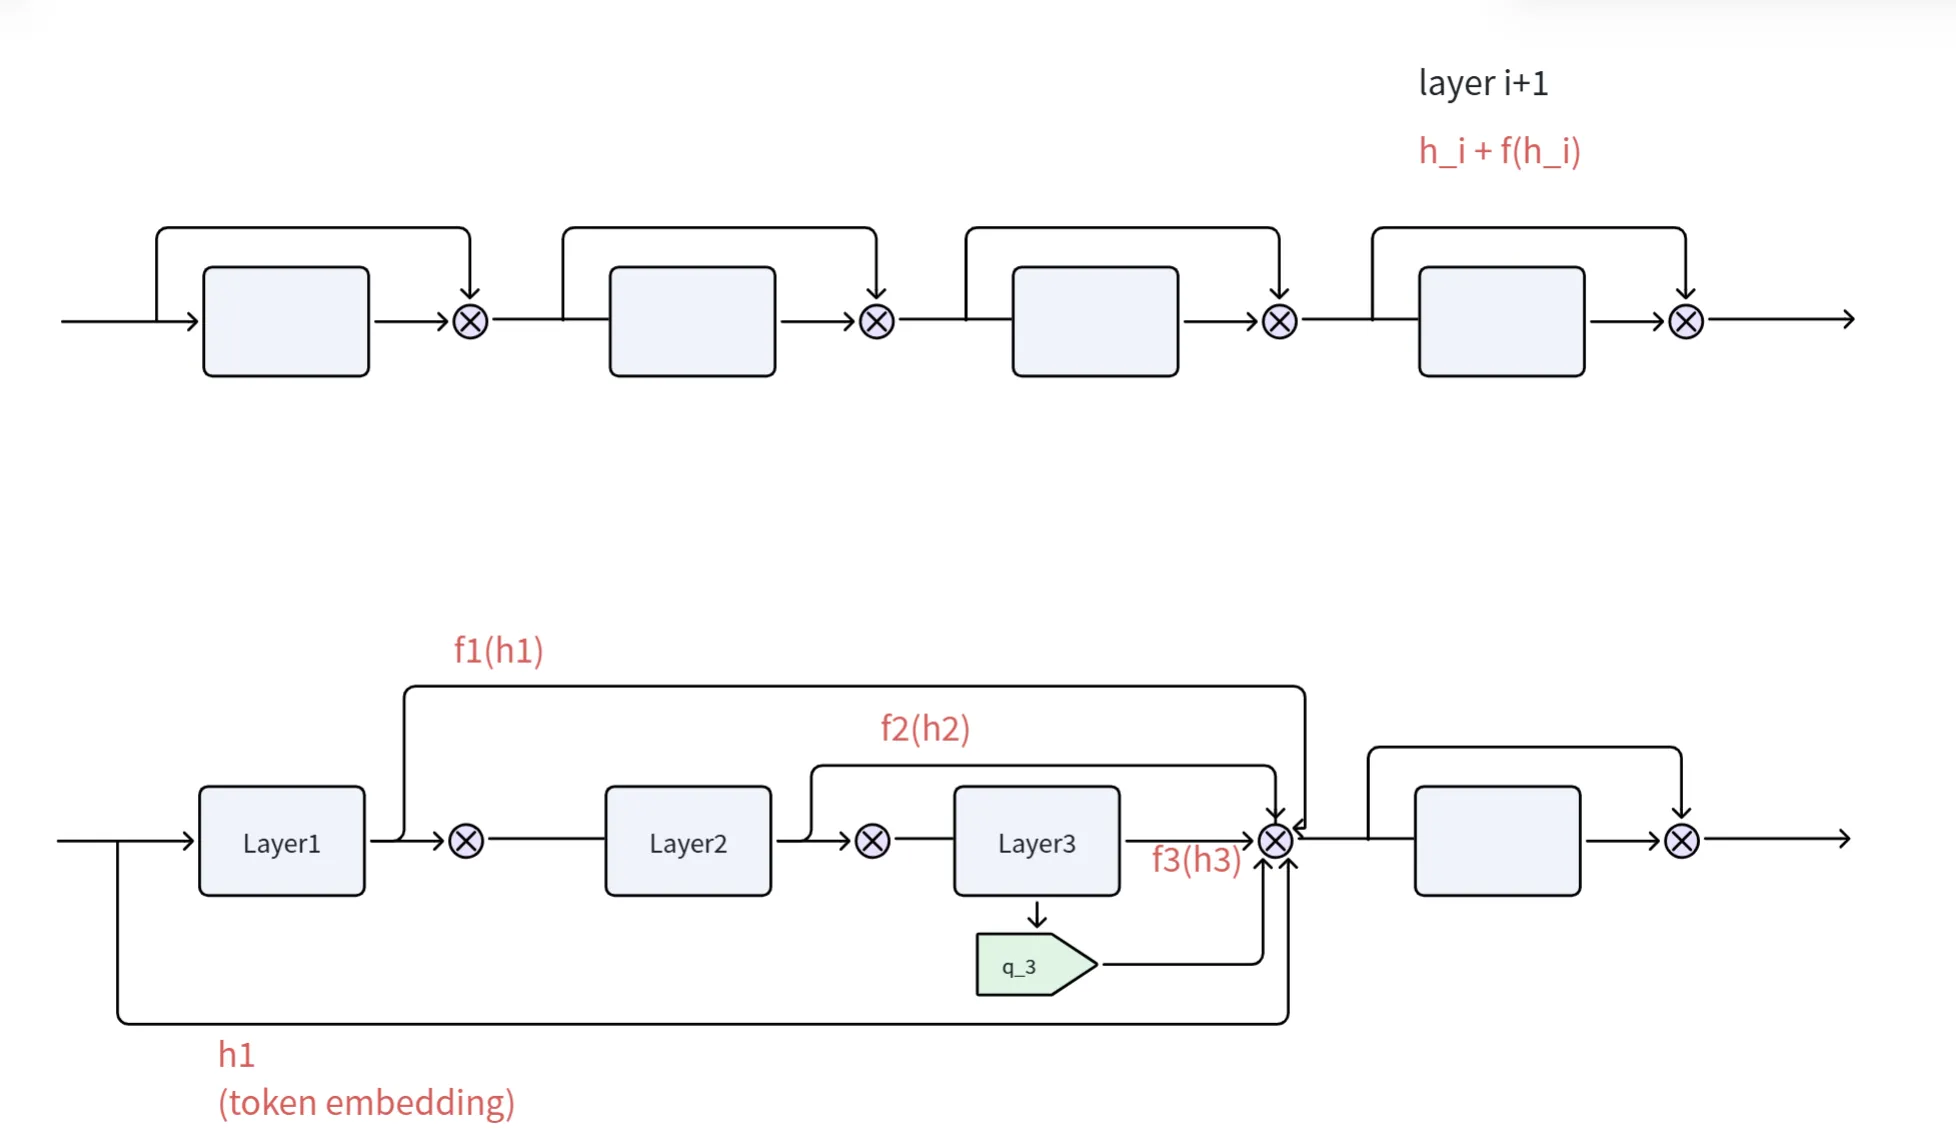
allows each layer to selectively attend to representations from all preceding layers
这里残差不再是线性的累计,而是运算的时候能看到先前所有层的表达
这里残差的计算公式类似于一个attention的计算,不同的是k i = v i = { h 1 , i = 0 f i ( h i ) , 1 ≤ i ≤ l − 1 k_i = v_i = \begin{cases} h_1, & i = 0 \\ f_i(h_i), & 1 \leq i \leq l-1 \end{cases} k i = v i = { h 1 , f i ( h i ) , i = 0 1 ≤ i ≤ l − 1 q l q_l q l
最终的 Attention Residual计算公式如下:
ϕ ( q l , k i ) = exp ( q l ⊤ RMSNorm ( k i ) ) \phi(q_l, k_i) = \exp\left( q_l^\top \, \text{RMSNorm}(k_i) \right) ϕ ( q l , k i ) = exp ( q l ⊤ RMSNorm ( k i ) )
α i → l = ϕ ( q l , k i ) ∑ j = 0 l − 1 ϕ ( q l , k j ) \alpha_{i \rightarrow l} = \frac{\phi(q_l, k_i)}{\sum_{j=0}^{l-1} \phi(q_l, k_j)} α i → l = ∑ j = 0 l − 1 ϕ ( q l , k j ) ϕ ( q l , k i )
h l = ∑ i = 0 l − 1 α i → l ⋅ v i h_l = \sum_{i=0}^{l-1} \alpha_{i \rightarrow l} \cdot v_i h l = ∑ i = 0 l − 1 α i → l ⋅ v i
Stable LatentMoE
expands the routed expert space to 896 experts, with 16 activated per token, while normalization, SiTU-GLU, and Quantile Balancing stabilize optimization at extreme sparsity.
Sparsity = 896/16 = 56
MoE的分布式部署,随着专家数量的增加和激活专家数量的增加,通信的负载会增大,包括hidden和专家权重的传输
另外vanilla的实现是下投影W↓ → swiGLU → 上投影W↑,相当于连续的四次矩阵乘法;技术报告里说这样的“病态”的运算,在2.8T的大模型下会产生爆炸的激活值;并且将近1k个专家会导致现有的auxiliary-loss-free bias失效
辅助loss free bias:
Auxiliary Loss 会在loss加一个penalty,鼓励平等的选择专家而不是偏爱某一个
L imp = α ⋅ ∑ j = 1 N f j ⋅ P j \mathcal{L}_{\text{imp}} = \alpha \cdot \sum_{j=1}^{N} f_j \cdot P_j L imp = α ⋅ ∑ j = 1 N f j ⋅ P j
f j = ( 1 / T ) ∗ Σ t 1 [ t o k e n t 选中最高的专家是 j ] f_j = (1/T) * \Sigma_t 1[token_t \text{选中最高的专家是 } j] f j = ( 1/ T ) ∗ Σ t 1 [ t o k e n t 选中最高的专家是 j ] j 被选中的频率
P j = ( 1 / T ) ∗ Σ t p t , j P_j = (1/T) * Σ_t p_{t,j} P j = ( 1/ T ) ∗ Σ t p t , j j 的平均路由概率 (softmax 后的值)
Aux-loss-free bias
不引入额外的梯度,在router的分数上加一个bias。同时按照固定的规则更新这个bias,但不参与反向传播
TopK ( s i + b ) \text{TopK}(s_i + b) TopK ( s i + b )
b j ( t + 1 ) = b j ( t ) + γ ⋅ sign ( ℓ ˉ − ℓ j ( t ) ) b_j^{(t+1)} = b_j^{(t)} + \gamma \cdot \text{sign}(\bar{\ell} - \ell_j^{(t)}) b j ( t + 1 ) = b j ( t ) + γ ⋅ sign ( ℓ ˉ − ℓ j ( t ) )
Stable Latent MoE用三个组件解决这些问题:
上投影之前的RMSNorm
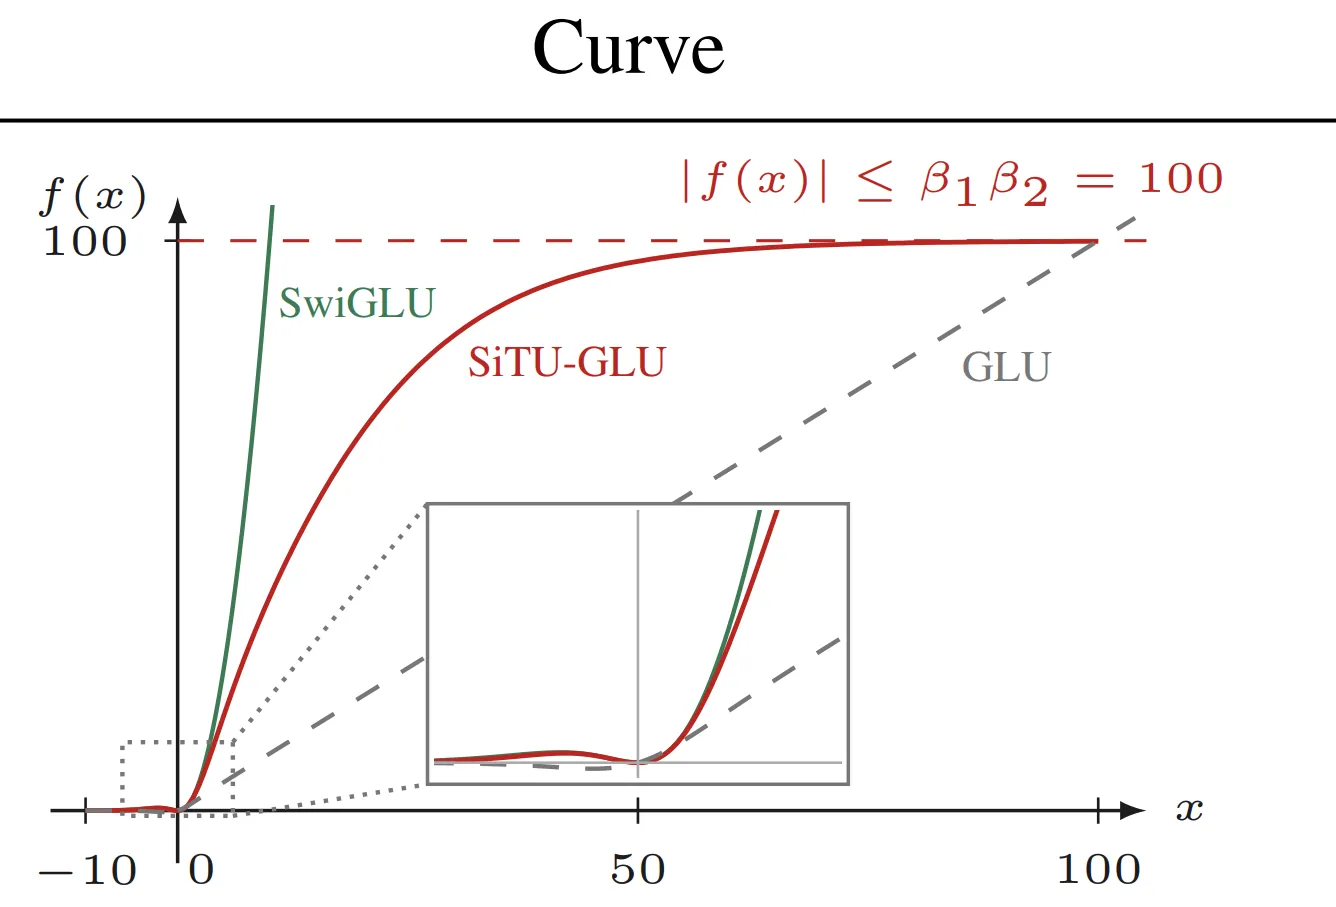
SiTU-GLU
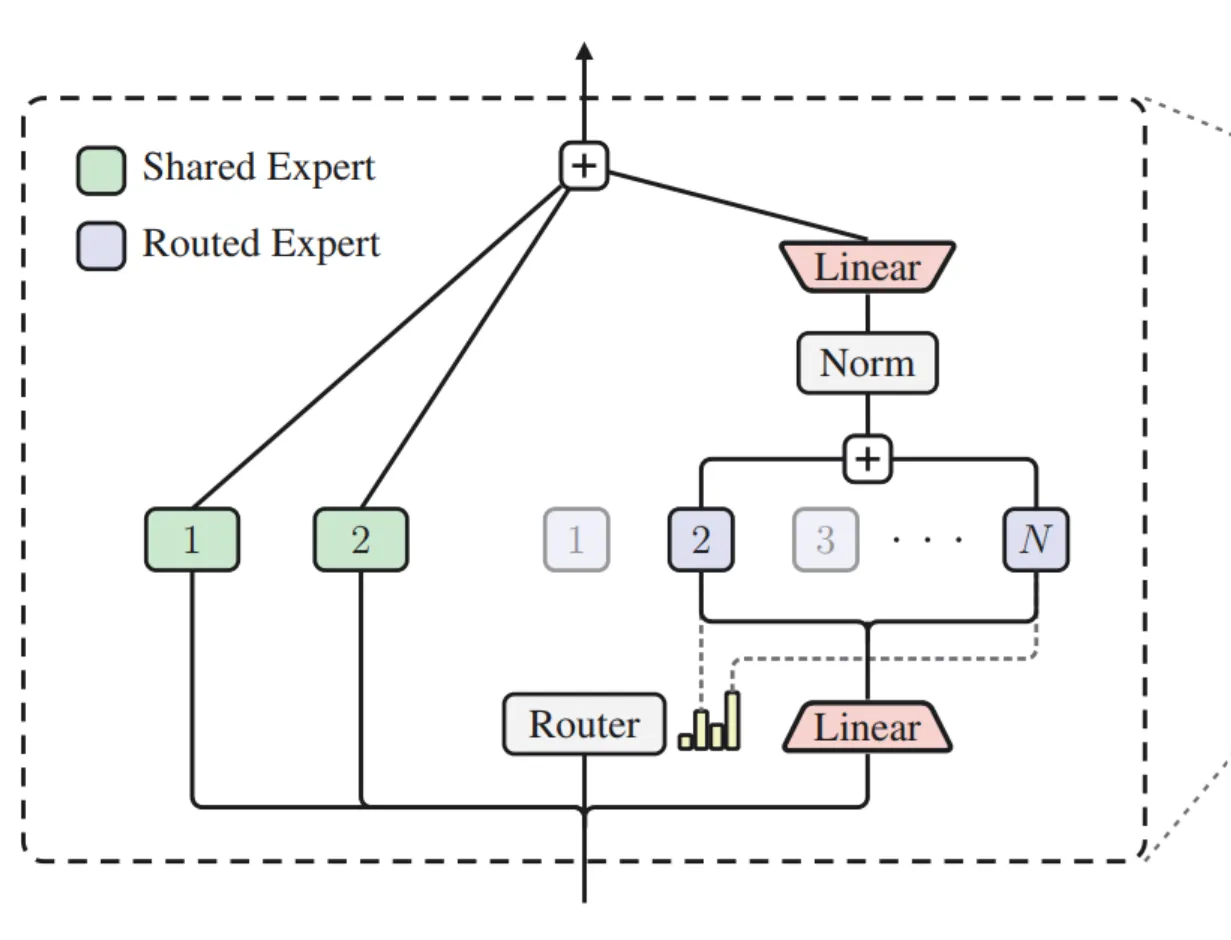
可以看到expert被分为了共享的和路由的
这里共享的expert是有两个,而路由expert则是会被激活16个(896个指的也是routed expert)
而ffn的部分
原始的GLU的两个因子中,gate是有界的,但是sigmoid在正区间不是线性增长的,表达能力下降
swiGlU使用x sigmoid(x),在正区间是线性的,但是gate和up都是无界的,容易产生大数值
Sigmoid Tanh Unit GLU (SiTU-GLU
SiTU-GLU ( x ) = [ β 1 tanh ( W g x β 1 ) ⊙ Sigmoid ( W g x ) ] ⊙ [ β 2 tanh ( W u x β 2 ) ] \text{SiTU-GLU}(x) = \left[ \beta_1 \tanh\left(\frac{W_g x}{\beta_1}\right) \odot \text{Sigmoid}(W_g x) \right] \odot \left[ \beta_2 \tanh\left(\frac{W_u x}{\beta_2}\right) \right] SiTU-GLU ( x ) = [ β 1 tanh ( β 1 W g x ) ⊙ Sigmoid ( W g x ) ] ⊙ [ β 2 tanh ( β 2 W u x ) ]
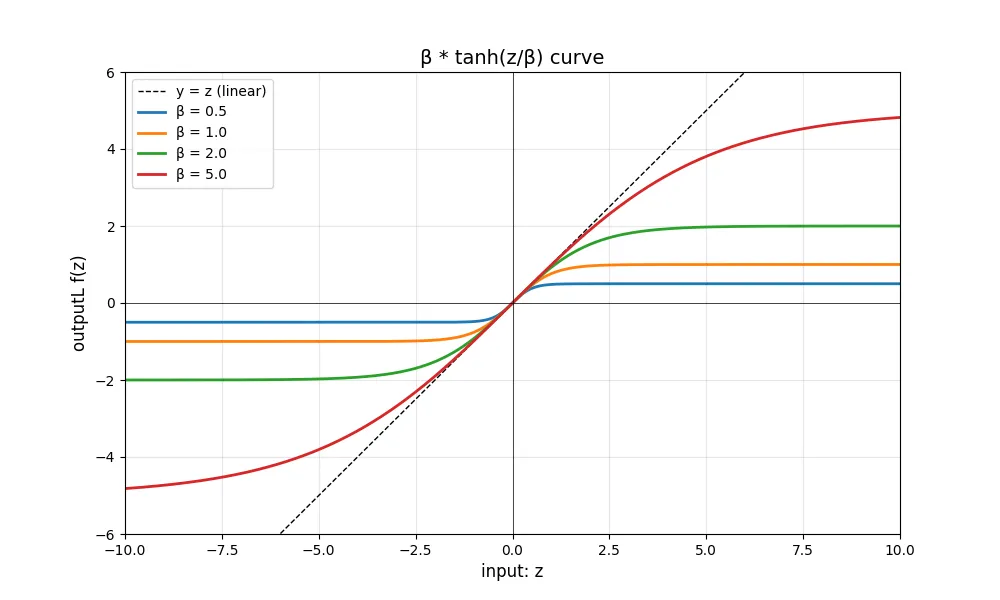
applies the smooth cap softcap(x, β ) = β tanh(x/β ) , to the linear factor of Swish Gate and up branch
For Kimi K3, we set the soft-cap hyperparameters to β 1 = 4 for the gate branch and β 2 = 25 for the up branch. The scaled tanh is approximately linear near the origin and bounded at large magnitude
Quantile Balancing
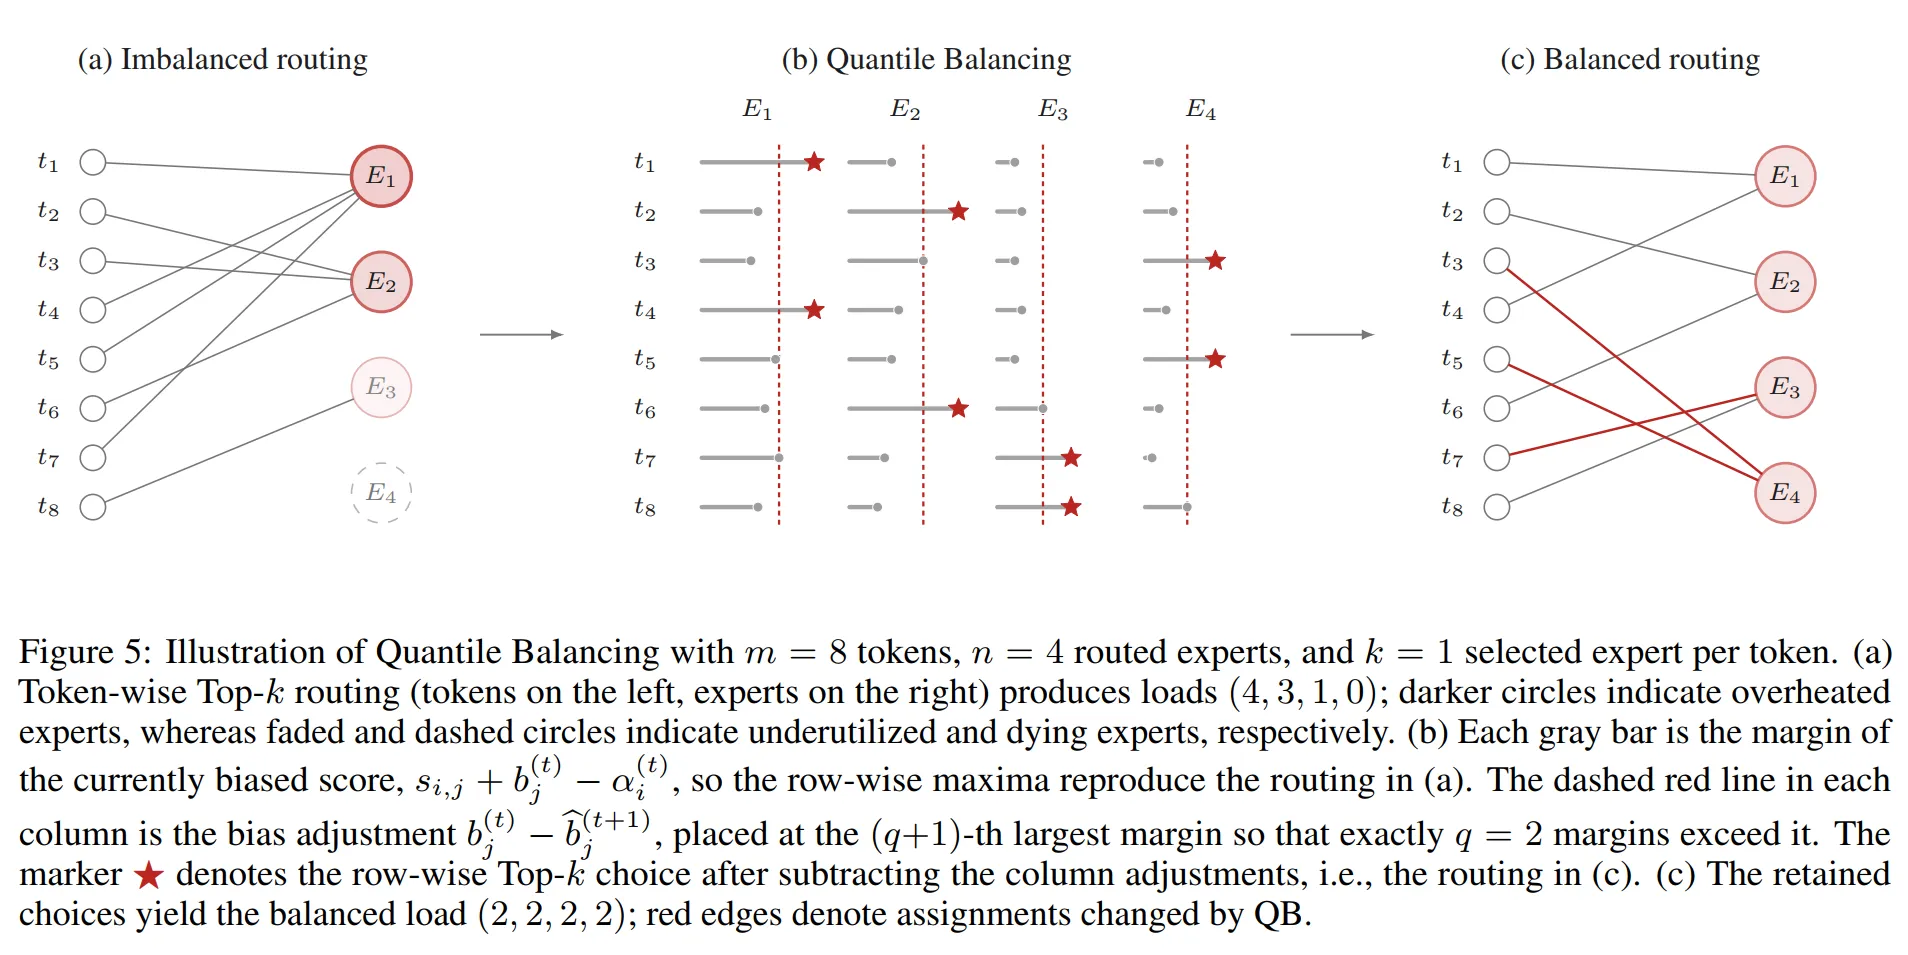
分位数均衡是kimi提出的无辅助损失的新方法
传统方法b j ( t + 1 ) = b j ( t ) + γ ⋅ sign ( ℓ ˉ − ℓ j ( t ) ) b_j^{(t+1)} = b_j^{(t)} + \gamma \cdot \text{sign}(\bar{\ell} - \ell_j^{(t)}) b j ( t + 1 ) = b j ( t ) + γ ⋅ sign ( ℓ ˉ − ℓ j ( t ) )
ℓ ˉ \bar \ell ℓ ˉ ℓ j ( t ) \ell_j^{(t)} ℓ j ( t )
在expert数量极大的情况下,位置一个平衡的负载更有挑战性
比起用正负关系来缓慢的用γ \gamma γ
对于一次topk的选择,转而选择topk+1的分数,并将这个第k+1个作为这一次选择的阈值α i ( t ) \alpha_i^{(t)} α i ( t )
对于专家j,它被分配的所有token数量是
∑ i = 1 m 1 [ s i , j + b ~ j ( t + 1 ) > α i ( t ) ] \sum_{i=1}^{m} \mathbf{1}\left[s_{i,j} + \tilde{b}_j^{(t+1)} > \alpha_i^{(t)}\right] ∑ i = 1 m 1 [ s i , j + b ~ j ( t + 1 ) > α i ( t ) ]
要使得上面那个式子等于负载的目标q=km/n;m是token数,k是每个token要选k个expert,n是expert总数
∑ i = 1 m 1 [ s i , j − α i ( t ) > − b ~ j ( t + 1 ) ] \sum_{i=1}^{m} \mathbf{1}\left[s_{i,j} - \alpha_i^{(t)} > - \tilde{b}_j^{(t+1)} \right] ∑ i = 1 m 1 [ s i , j − α i ( t ) > − b ~ j ( t + 1 ) ]
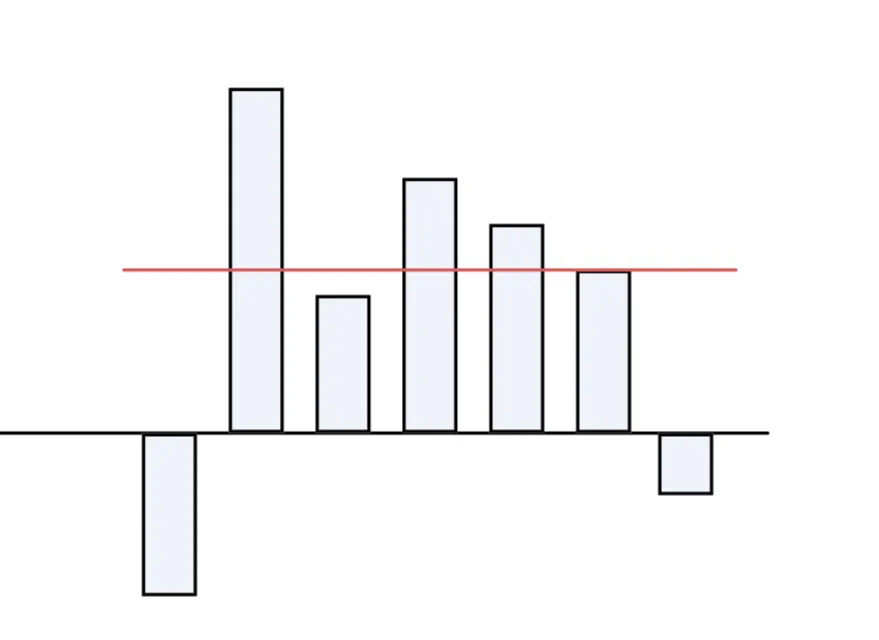
就是说− b ~ j ( t + 1 ) -\tilde{b}_j^{(t+1)} − b ~ j ( t + 1 ) 第q+1大的margin =s i , j − α i ( t ) s_{i,j} - \alpha_i^{(t)} s i , j − α i ( t )
而总共有m个token,q在这m个中的位置就是 1- q/m = 1-k/n 分位数,因此得到分位数的更新公式
b ~ j ( t + 1 ) ← − quantile 1 − k / n ( s : , j − α ( t ) ) \tilde{b}_j^{(t+1)} \leftarrow - \text{quantile}_{1-k/n}\left(s_{:,j} - \alpha^{(t)}\right) b ~ j ( t + 1 ) ← − quantile 1 − k / n ( s : , j − α ( t ) )
再减去一个公共偏移量来控制一下,同时也不会改变分数的排序
b ( t + 1 ) ← b ~ ( t + 1 ) − mean ( b ~ ( t + 1 ) ) ⋅ 1 (14) b^{(t+1)} \leftarrow \tilde{b}^{(t+1)} - \text{mean}(\tilde{b}^{(t+1)}) \cdot \mathbf{1} \tag{14} b ( t + 1 ) ← b ~ ( t + 1 ) − mean ( b ~ ( t + 1 ) ) ⋅ 1 ( 14 ) 下图是对margin的示意图,想要找到适合的bias就是要找到margin对应的分位数
下图为论文中的示例
Native vision
TODO 没有仔细看,总之是原生的视觉,在输入的时候就用一个视觉模块处理
Perhead Muon
有关Muon和其他optimizer的内容可能单开一篇记录一下
先前工作的Muon是将注意力头的 QKV 投影矩阵拼起来作为一个整体来做正交化更新,这里按照每个头做正交化
在更大规模下提升了训练稳定性。它还略微降低了优化器开销,因为在高的逐头块上进行 Newton–Schulz 迭代比在整个投影矩阵上更便宜
Post-training
einforcement learning across long-horizon coding, general agents, general reasoning and knowledge tasks, each spanning multiple reasoning-effort levels.
Domain- and effort-specialized policies are consolidated into a unified model through multi-teacher on-policy distillation
这部分论文里主要说了一些方法上的概念
SFT
量化感知训练
RL
通用任务
通用智能体
编码智能体
算法
Parital rollout的扩展
Reasoning effort
Agentic Generative Reward Model
MOPD 多教师在线策略蒸馏
先用RL训练出不同领域不同思考强度的模型,再蒸馏到一个通用的模型
TODO:这样做效果好的原因是什么?
Draft Model Fine-Tuning
将预训练的MTP层微调为EAGLE3风格
接受率∑ v min ( p ( x ) , q ( x ) ) \sum_v \text{min}(p(x),q(x)) ∑ v min ( p ( x ) , q ( x ))
优化LK损失,即接受率本身的负的对数
paper里说使用KL散度作为loss并不能最好的优化接受长度,而直接用预期接受率可以更好
统一白盒 RL 环境
开源了一个AgentEnv
Infra
Realizing this regime requires infrastructure that scales with architecture complexity, model size, and trajectory length
Infra4pre-training
Kimi K3 pre-training combines Pipeline Parallelism (PP) with virtual stages (VP) [48, 81], Expert Parallelism (EP) [66],
ZeRO-1 Data Parallelism [100], Pipeline ZeRO-2 gradient sharding [145], and Context Parallelism
MoonEP
provides perfectly balanced expert execution with static computation shapes and zero-copy communication, while memory efficient training and multimodal encoder optimizations sustain utilization within bounded memory
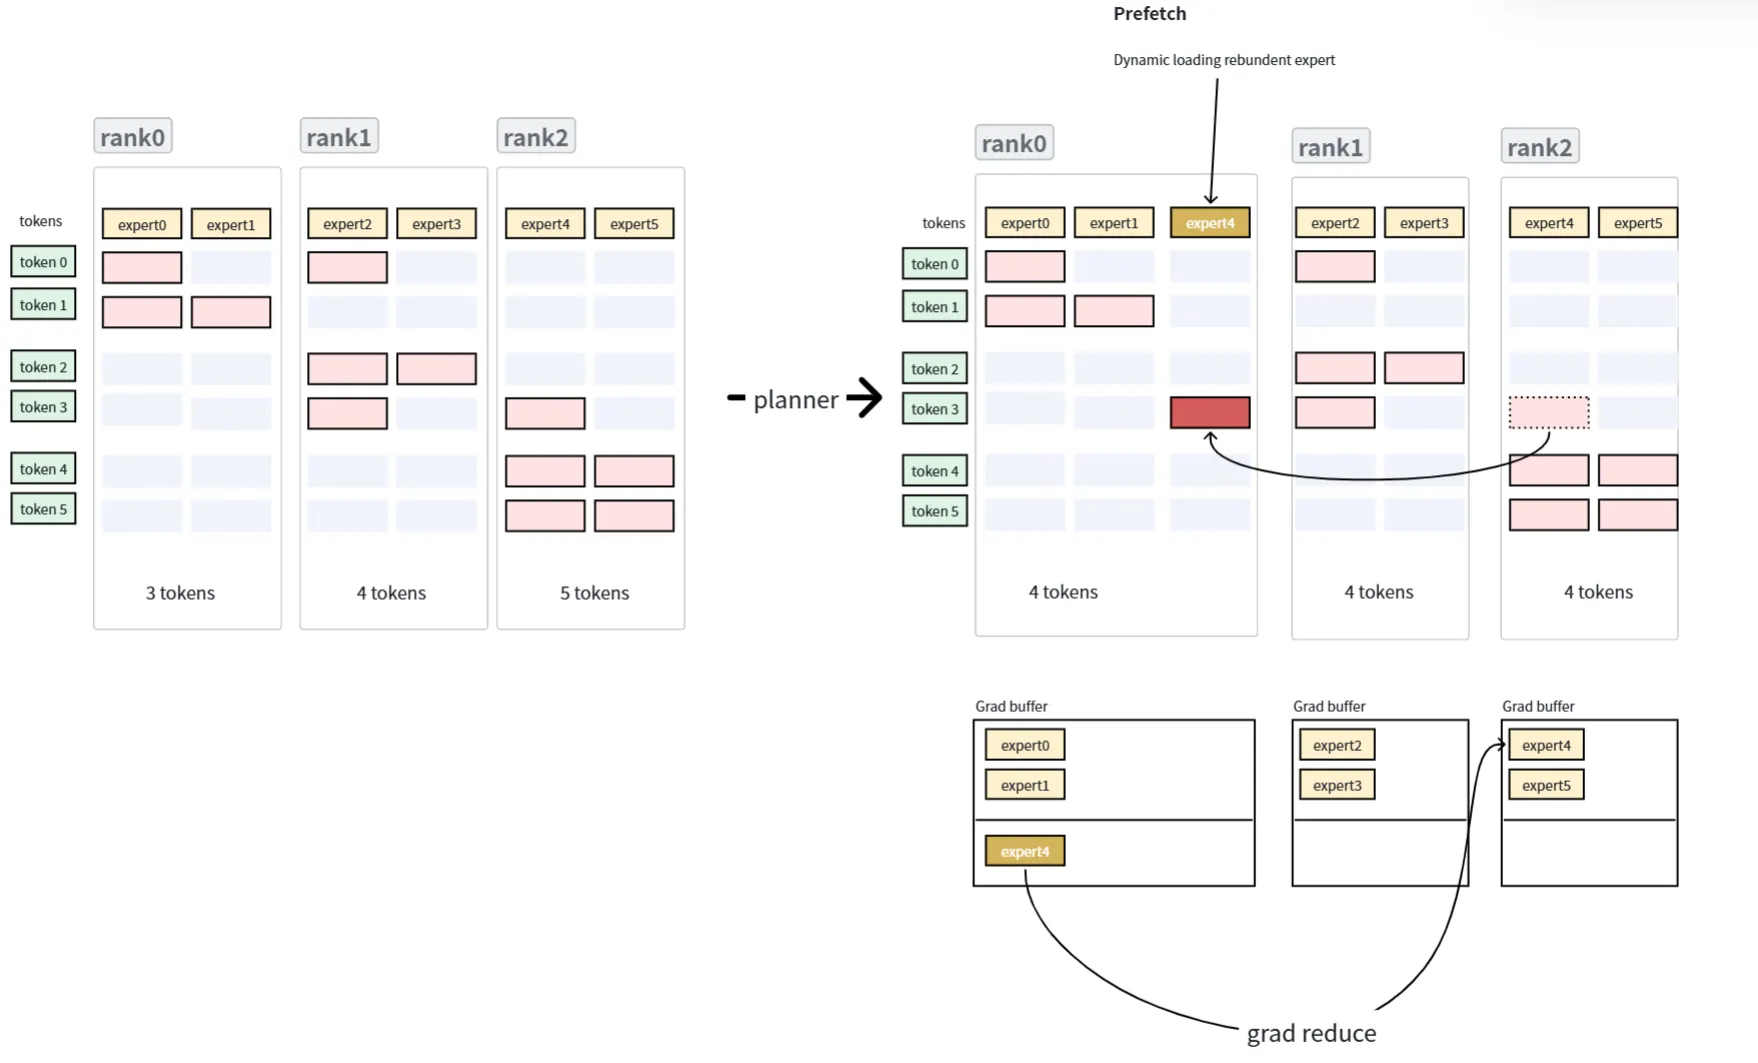
Perfect balance: every rank receives exactly S × K tokens, no matter how skewed the routing is. A small number of redundant experts is planned online from the current router outputs and prefetched before expert computation; their gradients are reduced back to their home ranks in the backward pass.
通过在线规划少量冗余专家,从理论上能证明可以保持每个rank收到的token量相同
Online planning: a near-optimal GPU planning kernel with negligible overhead
Zero copy and static shapes: fused permute/unpermute — tokens are sent directly to their expert-grouped positions on remote ranks and buffer views are returned to the computation. Only a fixed S × K buffer is needed, and statically known shapes eliminate per-layer MoE host synchronization.
FlashKDA
For systems co-design for KDA, we develop fused kernels, KDA Context Parallelism, and state-aware prefix caching to make KDA efficient within devices, across devices, and across requests
TODO:具体实现
K1以chunk为单位并行准备,优化目标是降低单个CTA的资源占用,让更多CTA并发执行。每个CTA负责一个(chunk, head, chunk),用TMA一次性将数据装入共享内存,再依次完成归一化、门控前缀和、衰减变换、小矩阵乘和Neumann展开。K1固定使用包含8个warp的CTA,寄存器用量被压至每线程32个。
K2用流水线顺序推进状态,每个CTA对应一个(序列, head),必须沿chunk顺序推进同一份状态。它将CTA划分为1个加载warp、4个MMA warp和1个写回warp,并设置3级输入流水线和2级输出流水线,完整状态以BF16保存在共享内存中。
KCP
CP,即context parallel,是在上下文过长的时候而需要将一个序列发给不同的rank的行为
同前面prefill遇到的问题一样,不同rank之间面临了记忆矩阵是有依赖关系的这一问题,因此这里通过把一个S完全展开成只含有S‘和M的式子
这里的S’就是*0输入对应的输出;而M则是S矩阵更新时候前面的“系数”。这两个值都是local的,意为只需要他们自身token的信息就可以计算得到
所以CP的过程就是先计算出这些local的矩阵,然后经过一次通信,去让逻辑上更后的rank去得到逻辑上靠前的rank的信息
.png)
Agentic Infra
our co-located system combines partial rollouts, external KV-cache retention, adaptive throttling and resumable microVM sandboxes to preserve long-lived model and environment state
外部kv缓存池
训练阶段cache和激活值、梯度会抢显存
活跃的cache存在显存里,闲置的被evict放到DRAM里
Rollout 自动节流调度器(Rollout auto-throttling scheduler)
在多步 Rollout 中,上下文随着轨迹推进而逐渐增长,使得基于完整轨迹平均长度的固定并发度既难以估计,又在早期过于保守。相反,如果并发度设置过高,会在后期阶段造成 KV 缓存压力,并可能触发抢占。
因此,我们在 LLM 请求调度层设计了一个自动节流(auto-throttling) 机制,使用运行时信号(如活跃请求数、排队请求数和 KV 缓存利用率)动态控制发送给推理引擎的请求数量。这使得 Rollout 早期保持良好利用率,同时在 KV 缓存压力上升时降低并发度,无需手动调参即可避免欠饱和和过载
Gradient Buffer Reuse
策略模型的Gradient buffer只有在反向传播的时候用,参考模型平时放 CPU 内存,需要时临时加载到 GPU,并复用策略模型的梯度缓冲区来存放它,从而不额外占用显存
AgentEnv - Sandbox Infrastructure
Inference and serving
Prefix cache
Hybrid attention引入的问题:
两种attn的存储和管理方式
Linear attn是粗粒度的存储记忆矩阵,而MLA是可以细粒度追加的,引入把物理块和hash解耦
MLAprefill时,切成块,用链式哈希注册来表示前缀关系
前缀树的缺陷?百万上下文,内存开销大
时序逻辑,对cpu友好
删除/过期处理复杂
KDA存checkpoint
S矩阵很大,每隔512就存占显存
中间检查点会被抛弃,只保留轮次边界
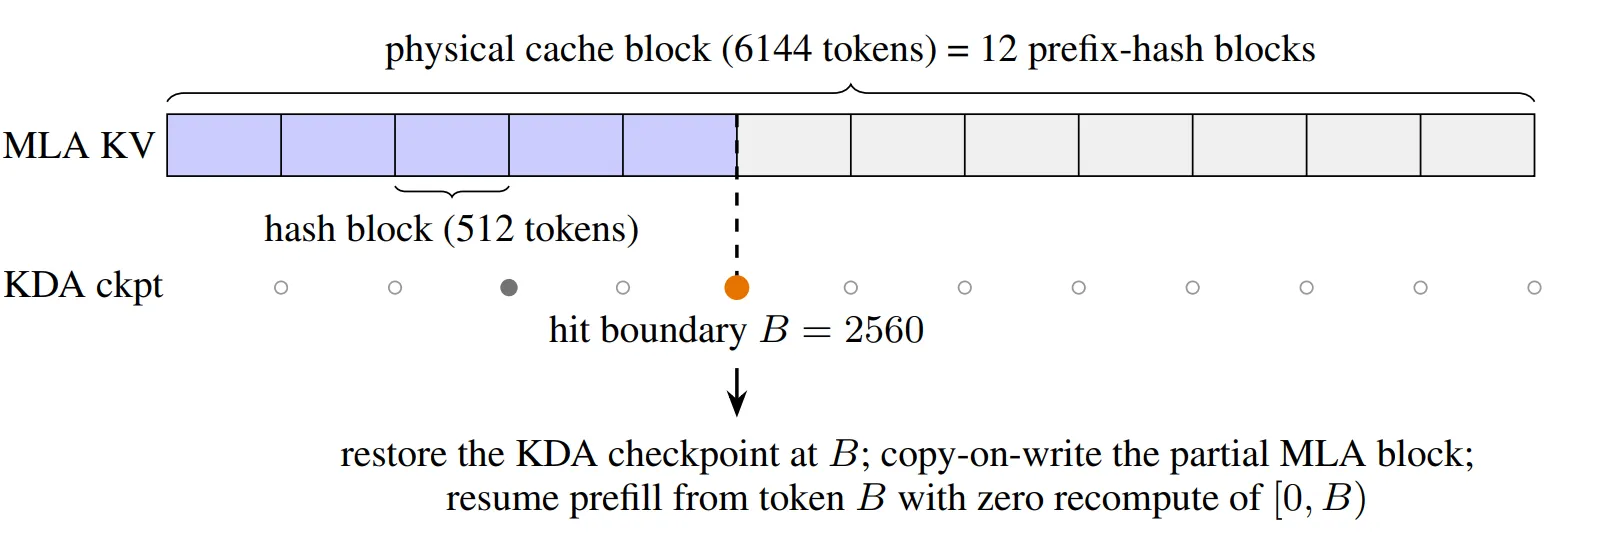
查找过程分为两个阶段(图 12)。MLA 阶段通过链式哈希匹配完整的物理块,并在第一个缺失的块处,回退到该物理块内部的哈希端点,因此部分填充的页面仍然可以被命中。KDA 阶段则要求在候选边界处,每个 KDA 缓存组(每个组维护一个独立的递归状态)都有一个检查点。
最终命中的位置是同时满足两个阶段的最长边界——它始终是哈希块(512 token)的整数倍,绝不要求是物理块(6144 token)的整数倍。
在图 12 中,一个前 2800 个 token 匹配缓存前缀的请求,在 B = 2560 = 5 × 512 处命中——位于一个 6144 token 物理块的内部深处——然后从 token B 处恢复预填充,无需重计算 [0, B)。
然而,在实际实现的支持里似乎没有这么做,而是把S也靠拢了MLA KV的细粒度,为此带来的存储占用由ssd来承担了
其他设计
命中的块会被锁住
正在写入的块会被锁
KDA检查点的原子性(evict的时候会一起踢掉),咋实现的不知道
Kernel