文章
ICS2-note
本文目录 73
ICS 笔记
ICS2 复习笔记,主要根据课程 Slides 和 CSAPP 教材整理。
最近实在太忙了,草稿箱里其实已经躺着好几篇 Blog,一直没时间写完。
先用这篇 ICS 复习笔记水一篇,之后应该会补充更多偏思路性的内容,希望最终能把整篇知识体系串联起来。
二更:
由于涉及的知识点实在太多,最近只是稍微整理了一部分。本篇笔记原来是英文的,整理后的版本采用中文,同时也记录了更多思路性的东西,意图感性的展示出整个操作系统的一些知识
整篇笔记按照各个单元进行划分,主要参考 CSAPP 和课程 Slides,同时补充了一些示意图。
Menu
- 记忆架构
- Storage & RAM
- Locality & Cache
- Cache 写策略
- 异常控制流
- 进程控制(Process Control)
- 信号(Signals)
- 非本地跳转(Nonlocal Jumps)
- IO
- 系统级 I/O(Sys-level I/O)
- RIO(Robust I/O)
- 标准 I/O(Standard I/O)
- 虚拟内存(Virtual Memory)
- 页表与地址转换
- TLB & 多级页表
- VMA & 内存映射
- 页面置换算法
To be archived
errno:最简单的实现方式就是维护一个全局变量。
Process Scheduling:
- FIFO
- SJF
- STCF
Memory Hierarchy
本章介绍计算机中存储的架构 从不同的存储到一些缓存的机制
Storage
常见的存储介质包括:
- Disk(机械硬盘,依靠磁盘旋转读写)
- SSD
- SRAM
- DRAM
他们访问的速度是
SRAM > DRAM > SSD > Disk相应的,造价也会随速度增加。所以如何权衡成本和速度,就是Memory Hierarchy要解决的事情
在日常使用机器中,所谓的内存(主存)就是由DRAM组成的,而硬盘一般是SSD或者Disk
这里有关Disk的旋转读取,以及SSD的颗粒存储就不展开了
RAM
Random Access Memory,是一种访问的方式,可以以几乎相同的时间访问任意地址
sRAM和DRAM都是具有这种方式的存储介质
这种特性保证了CPU能够快速的访问内存、执行程序
注: 这里的随机访问指的是给定一个地址(或索引),可以直接访问对应的数据,而不需要先访问其他数据 而与之对应的顺序访问,则是访问某个数据之前,必须按照存储顺序访问前面的数据,好比数组和链表的区别
Locality
程序运行过程中通常具有 Locality(局部性)
Temporal Locality(时间局部性) :最近访问过的数据,很可能在不久之后再次被访问
Spatial Locality(空间局部性):与当前访问位置相邻的数据,更有可能在之后被访问
Memory Hierarchy
记忆层级,主要是指从CPU的开始,到主存的这一条层级架构
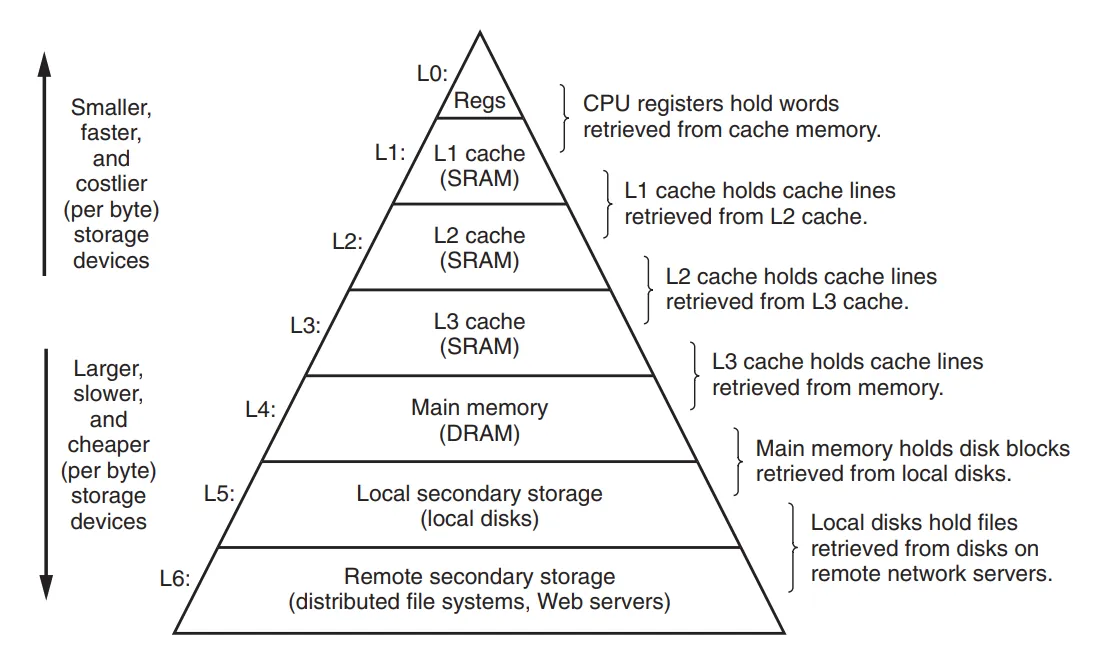
Cache
cache,又或者缓存是什么?
主存使用的存储介质是DRAM,他不是最快的,为了提高访问速度,在cpu和主存之间会引入缓存,将一些数据存在SRAM里,以便更快的访问
当cpu需要访问内存的时候,会从最近的缓存开始访问,如果miss就访问下一级的缓存,并将访问到的数据提升至更高的cache中
L1 -> L2 -> L3 -> 主存
因此,按照金字塔的结构,越靠近 CPU 的存储层级应该:
- 访问速度越快
- 容量越小
当发生 Cache miss 时,需要从更低一级存储中取回数据。
如果 Cache 已满,则需要淘汰(Evict)已有的数据块,为新的数据腾出空间
由于 Cache 的容量有限,一个内存块通常只能映射到 Cache 中的一小部分位置,这就是 Placement Policy(放置策略)
Cache Miss 可以分为三种类型:
-
Cold Miss(冷启动未命中)
Cache 刚开始为空,需要逐渐预热(Warm up)
-
Conflict Miss(冲突未命中)
Cache 实际上还有空闲空间,但由于映射策略限制,导致多个数据竞争同一个 Cache Line
这种情况是可以通过调整cache的结构,或者是调整代码来调整变量的地址来进行优化的
-
Capacity Miss(容量未命中)
Cache 容量确实不足,即使采用最优映射策略也无法避免
Cache Memory
Cache 的整体组织结构
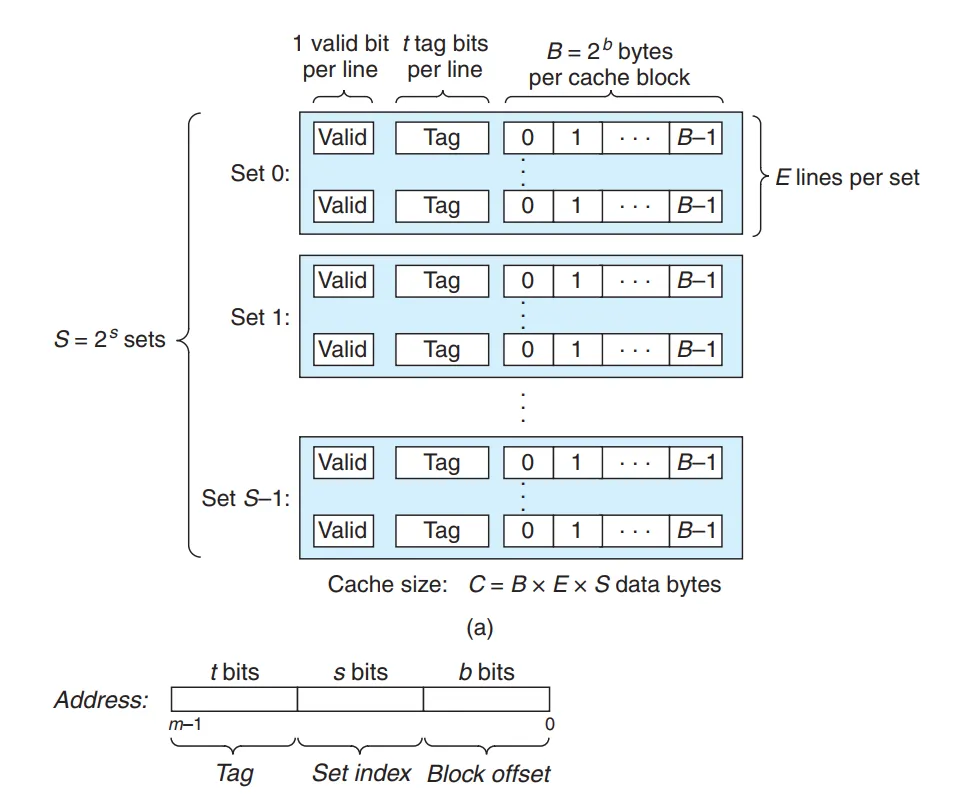
Q: 为什么要把地址拆成几份,而不是直接把地址作为索引?
A: 一个cache是一个小的存储空间,因此 它不可能做到像主存一样,一个物理地址对应一块空间;他里面应该是类似于
unordered_map的形式。那么就需要用idx去查询:
如果用完整的address(32bit为例)去做idx,那么idx占32bit,存储的数据只有1byte=8bit,利用率很低
如果想要拓展存储数据的大小,把address拆成set bit和offset bit,这样就能存储更多的数据;但是有一个很重要的前提—所有的address都能被存入cache,对应到这里无序地图的概念,也就是说cache里条目的数量必需等于2的set-bit次幂的数量,否则就会出现有的address存不进cache。于此同时一个条目的大小也必须是2的offset-bit次幂byte
以32bit为例,offset bit, set bit,总共的大小就是 也就是 4GB,远远大于我们想要的效果
计算出这么一个大的cache的原因,是因为没有引入踢出的机制,或者说在不违反
unordered_map之一前提下,一个idx可以索引到不同的条目,比如set bit和offset bit之间空两个bit,这样就是每个条目对应了一个idx了。那么如何区分当前存储里的条目对应的是那个地址条目呢?这时再把刚刚那两个bit引入,作为额外的tag bit就可以分辨了。同时cache的大小也由于tag的存在而被缩减成了1/4!在此基础上继续调整这几个bit的大小,我们就能得到想要的cache的大小了,同时还可以拓展一个set里的line的数量,在line满了之后进行踢出和替换
Direct Mapping Cache
Direct Mapping(直接映射)中:
每个内存块只能映射到唯一的一条 Cache Line。
因此:
其中 E 表示每个 Set 中 Cache Line 的数量。
Cache 写策略(Writing Cache)
主要有两种写策略。
Write Through
每次写 Cache 时,都立即同步写回到下一层存储(通常是 Memory)。
优点:
- 实现简单
- 数据一致性容易维护
缺点:
- 写操作较慢
- Memory 带宽压力较大
Write Back
数据首先只写入 Cache。
只有当对应 Cache Block 被 Evict 时,才真正写回 Memory。
因此需要额外维护一个 Dirty Bit,用于记录该数据是否被修改过。
相比 Write Through:
- Memory 写次数明显减少
- 写性能更高
当发生 Write Miss 时,又对应两种不同策略。
Write Allocate
通常与 Write Back 配合使用。
发生 Write Miss 时:
先把对应 Block 调入 Cache,再完成写操作。
也就是说,数据仍然按照 Cache 层级逐层传递。
No Write Allocate
通常与 Write Through 配合使用。
发生 Write Miss 时:
不加载 Cache,直接写入下一层 Memory。
Memory Mountain
(待补充)
Exceptional Control Flow
Process Control(Exception)
Reaping
需要区分下面几个重要概念:
- Zombie Process(僵尸进程):子进程已经终止,但父进程尚未回收(reap)其退出状态。
- Orphan Process(孤儿进程):父进程已经退出,但子进程仍然在运行。
父进程通过 reap 操作回收已经终止的子进程(Zombie Process)。
init Process
当父进程退出后,内核会将所有仍在运行的子进程交由 init Process(现代 Linux 中通常是 systemd)接管。
init Process 的特点:
- 系统启动时创建;
- 永远不会终止;
- 是所有进程的祖先。
因此,Orphan Process 最终都会由 init Process 负责回收。
waitpid
pid_t waitpid(pid_t pid, int *statusp, int options);返回值:
- 成功:返回被回收子进程的 PID;
- 返回
0:使用WNOHANG时,没有子进程退出; - 返回
-1:发生错误。
TODO:整理
options的三种常用选项。
sleep
(待补充)
execve
execve 用于加载并执行一个新的程序。
它通过传入:
- 参数列表(argument list)
- 环境变量列表(environment variable list)
来启动新的可执行文件。
#include <unistd.h>

int execve(const char *filename,
           const char *argv[],
           const char *envp[]);

// 成功时不会返回;失败返回 -1
需要注意:
execve 不会创建新的 Process。
它会直接用新的程序替换当前 Process 的地址空间,因此成功执行后,原来的代码将不再继续运行。
Signals
Signal 属于一种更高层次的 Exceptional Control Flow。
Signal 与 Exception 的区别
| Signal | Exception | |
|---|---|---|
| 发送者 | CPU(用户态或内核态产生事件) | Kernel |
| 接收者 | Kernel | 用户程序 |
| 特点 | 异步(Asynchronous) | 同步(Synchronous) |
简单理解:
- Exception 通常由当前正在执行的指令触发,例如 Page Fault、Divide by Zero。
- Signal 则更偏向异步通知,例如 Ctrl+C、子进程结束、定时器超时等。
Sending Signal
Process Groups
(待补充)
kill
kill 用于向指定 Process 或 Process Group 发送 Signal。
alarm
unsigned int alarm(unsigned int seconds);作用:
设置一个定时器。
当指定时间到达后,内核会向当前 Process 发送 SIGALRM。
返回值:
返回上一次 alarm 尚未结束时剩余的秒数。
Receiving Signal
Pending Signal Set
Kernel 会维护一个 Pending Signal Set。
收到 Signal 时:
- 若该 Signal 当前被阻塞,则加入 Pending Set;
- 等解除阻塞后,再进行处理。
需要注意:
同一种 Signal 不会排队(Not Queued)。
无论收到多少次,同一种 Signal 在 Pending Set 中最多只会保留一个。
Signal Handler(sighandler)
可以为某个 Signal 注册对应的处理函数(Signal Handler)。
Signal 到达后,Kernel 会中断当前程序的执行,转而调用对应的 Handler。
Handler 执行结束后,再返回原来的程序继续运行。
Blocking and Unblocking
Signal 的阻塞(Blocking)可以分为两种:
-
Implicit Blocking
Kernel 自动完成。
-
Explicit Blocking
程序员主动调用
sigprocmask等接口进行控制。
Signal Handler 的设计
设计 Signal Handler 时,需要注意:
- Handler 应尽量简单;
- Handler 应避免执行耗时操作;
- Handler 应避免调用不可重入(non-reentrant)的函数。
尤其需要牢记:
Pending Signals are not queued.
因此 Handler 的设计不能依赖于:
“收到多少次 Signal,就一定会调用多少次 Handler。”
例如:
父进程通常会捕获 SIGCHLD,然后在 Handler 中循环调用 waitpid,回收所有已经退出的子进程。
避免并发 Bug(Race Condition)
Signal 是异步发生的,因此非常容易产生 Race Condition(竞争条件)。
例如:
父进程:
- 调用
fork()创建子进程; - 将子进程记录到某个数据结构中;
- 注册
SIGCHLD的 Handler,在子进程退出时删除对应记录。
如果:
子进程结束得非常快,
那么:
SIGCHLD 可能会在父进程完成记录之前就已经到达。
最终导致:
Handler 删除了一条根本不存在的记录。
这就是典型的 Race Condition。
显式等待 Signal
一种简单的方法是:
while (!flag)
    pause();
但是这里存在竞争窗口:
Signal 可能恰好发生在:
判断 flag
↓

调用 pause()
之间。
这样程序将永久睡眠。
因此,更推荐使用:
sigsuspend()
它可以将下面三个操作原子化(Atomic):
sigprocmask
↓

pause

↓

sigprocmask
从而彻底避免上述竞争问题。
Nonlocal Jumps
setjmp(jmp_buf env);

longjmp(jmp_buf env, int retval);
longjmp 可以让程序直接跳回到之前执行 setjmp 的位置。
setjmp
setjmp 可以执行多次。
第一次执行时:
返回值始终为:
0当之后调用对应的 longjmp 时:
setjmp 将再次返回,
返回值为:
retvallongjmp
longjmp 可以调用多次。
它本身不会返回,而是直接恢复程序执行现场,并跳转回对应的 setjmp。
存在的问题
由于会直接跳过中间大量函数,
因此容易导致:
- Memory Leak
- Resource Leak
- 文件未关闭
- 锁未释放
因此需要谨慎使用。
Application
Nonlocal Jump 的两个典型用途:
-
从深层函数调用中立即返回,而无需层层返回;
-
在 Signal Handler 中直接跳回指定位置,而不是继续执行被中断的那条指令。
IO
Sys-level I/O
Unix I/O
在 Unix 中,一切都被抽象为 File(文件)。
无论是:
- 普通文件
- 终端(Terminal)
- Socket
- Pipe
都可以通过统一的 I/O 接口进行访问。
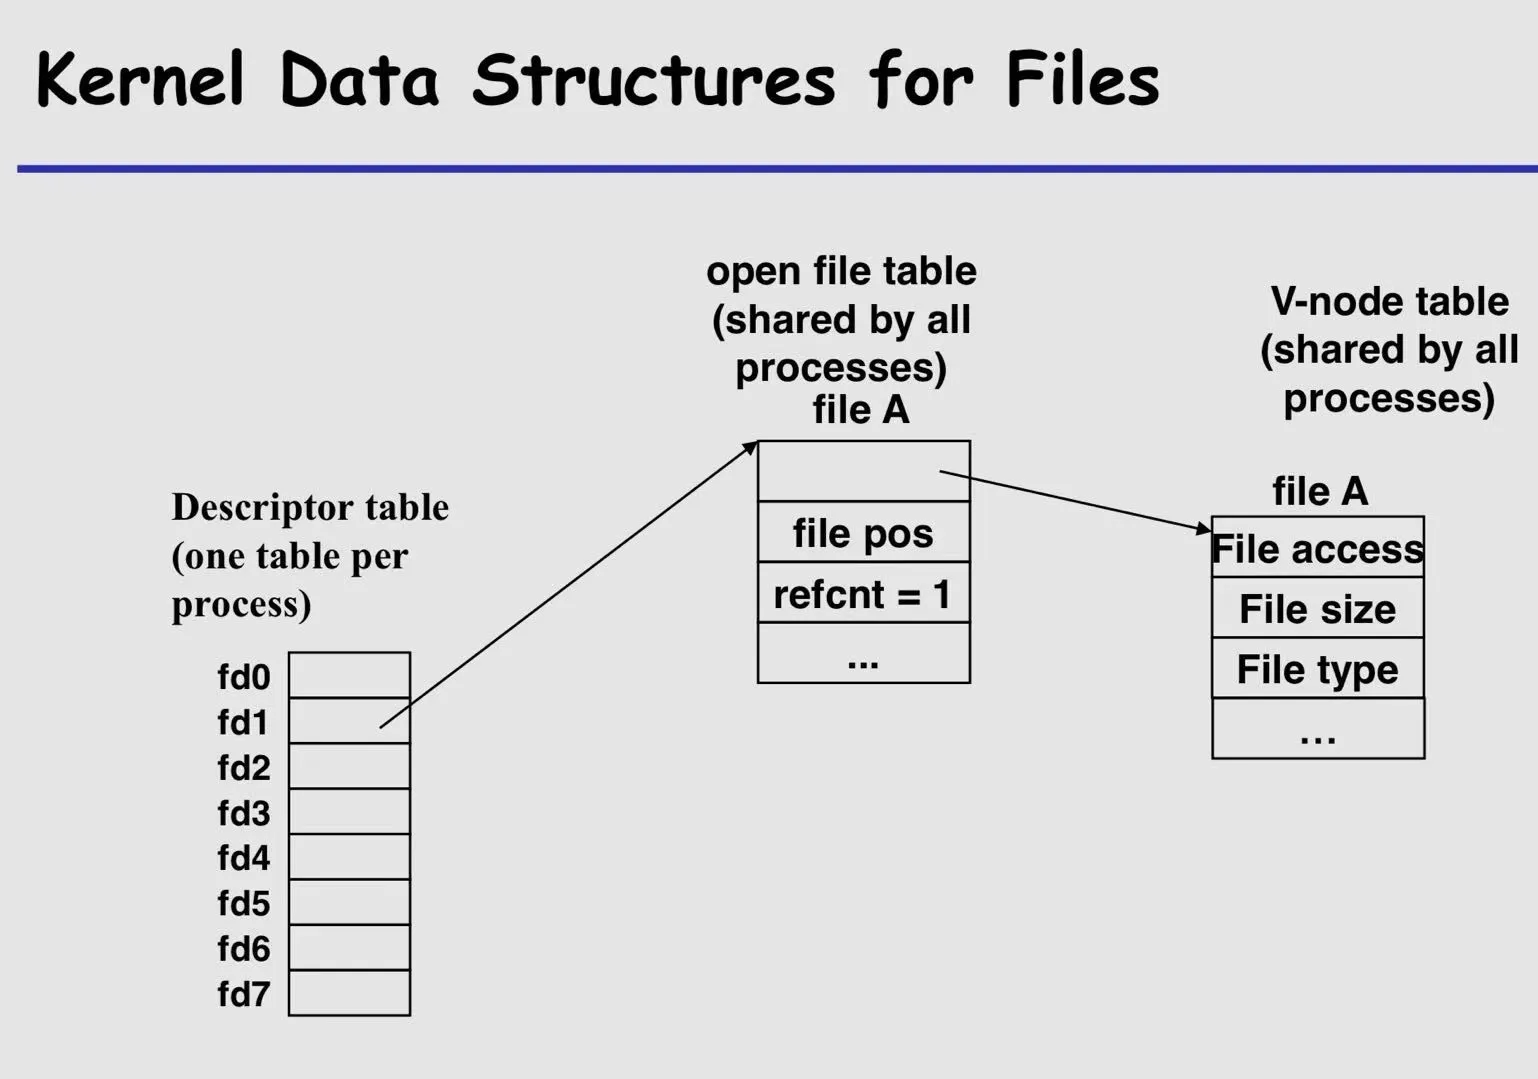
对于每一个打开的文件,Kernel 都会维护一个 File Offset,表示当前读写的位置。
Opening and Closing Files
调用 open() 可以将一个文件名转换成 File Descriptor(fd)。
File Descriptor 本质上是一个非负整数,用于唯一标识当前进程打开的文件。
int fd = open(pathname, flags, mode);成功时返回一个 File Descriptor;
失败时返回 -1。
下图展示了文件描述符与内核数据结构之间的关系。
Sharing Files
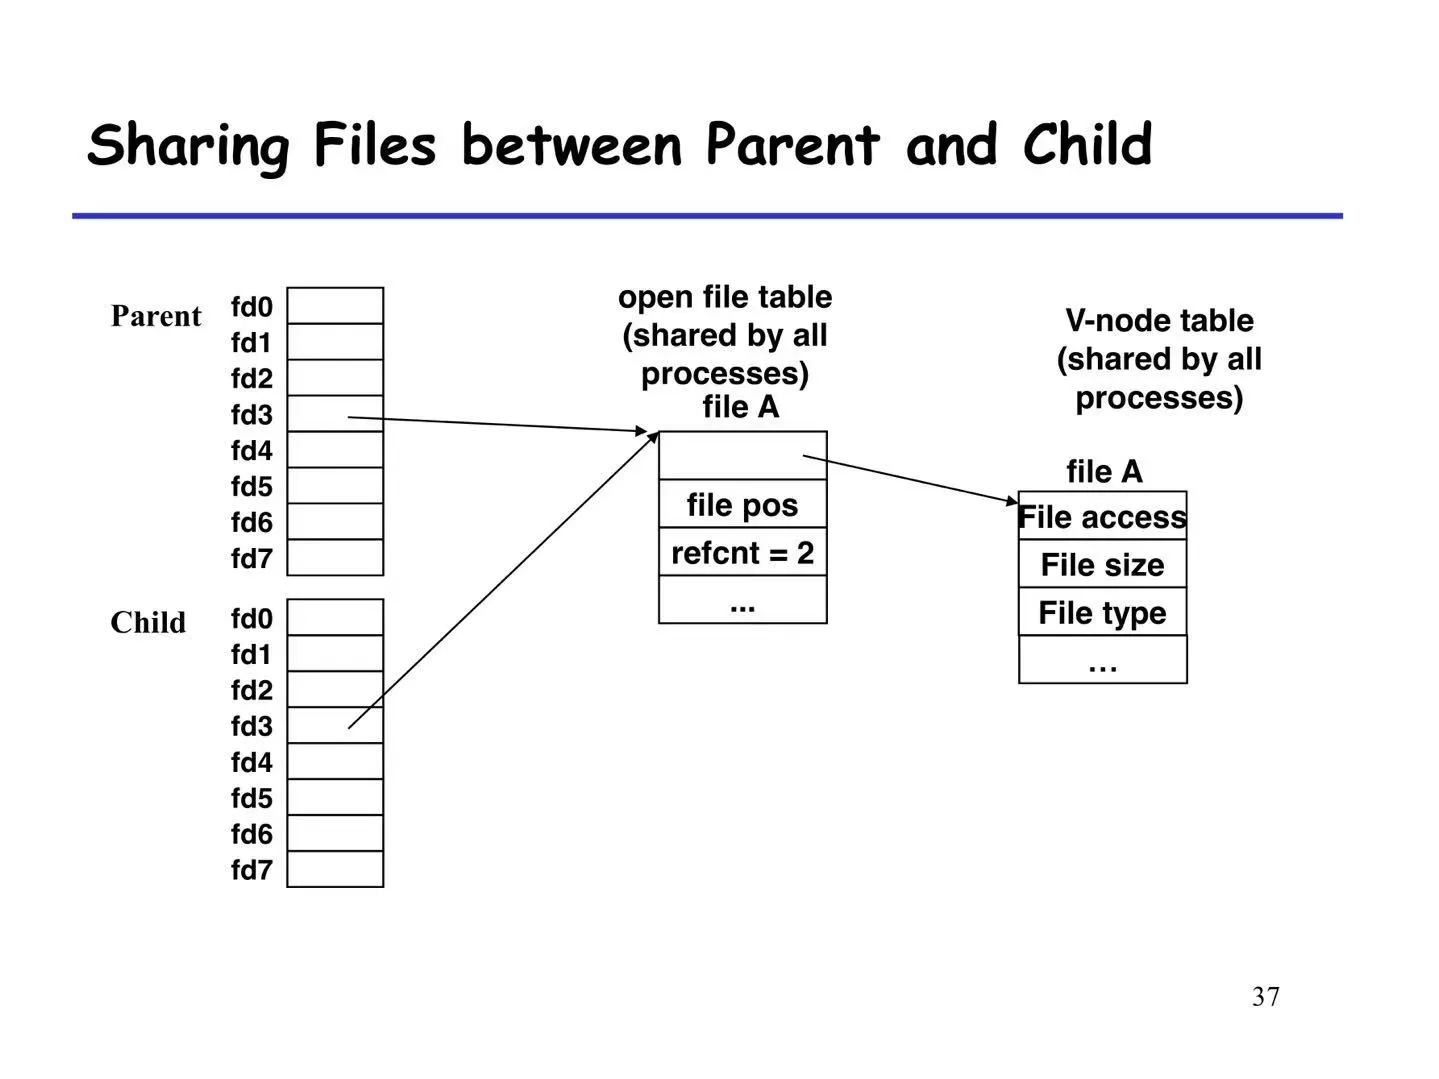
当父进程调用 fork() 创建子进程时:
父子进程拥有不同的 File Descriptor Table(文件描述符表)。
但是:
它们会共同指向同一个 Open File Table Entry(打开文件表项)。
因此:
- File Offset 是共享的;
- 打开文件对象也是共享的;
- 引用计数
refcnt会增加。
fork()

Parent fd table
        │
        │
Child fd table
        │
        ▼
Open File
(refcnt++)
如下图所示:
因此:
父子进程读取同一个文件时,会共享同一个 File Offset。
I/O Redirection
Unix 可以利用 dup() 和 dup2() 完成 I/O 重定向。
dup()
int dup(int oldfd);作用:
复制一个 File Descriptor。
Kernel 会返回当前最小的可用 File Descriptor。
例如:
oldfd = 3

↓

dup(oldfd)

↓

newfd = 4
其中:
3 和 4 指向同一个 Open File。
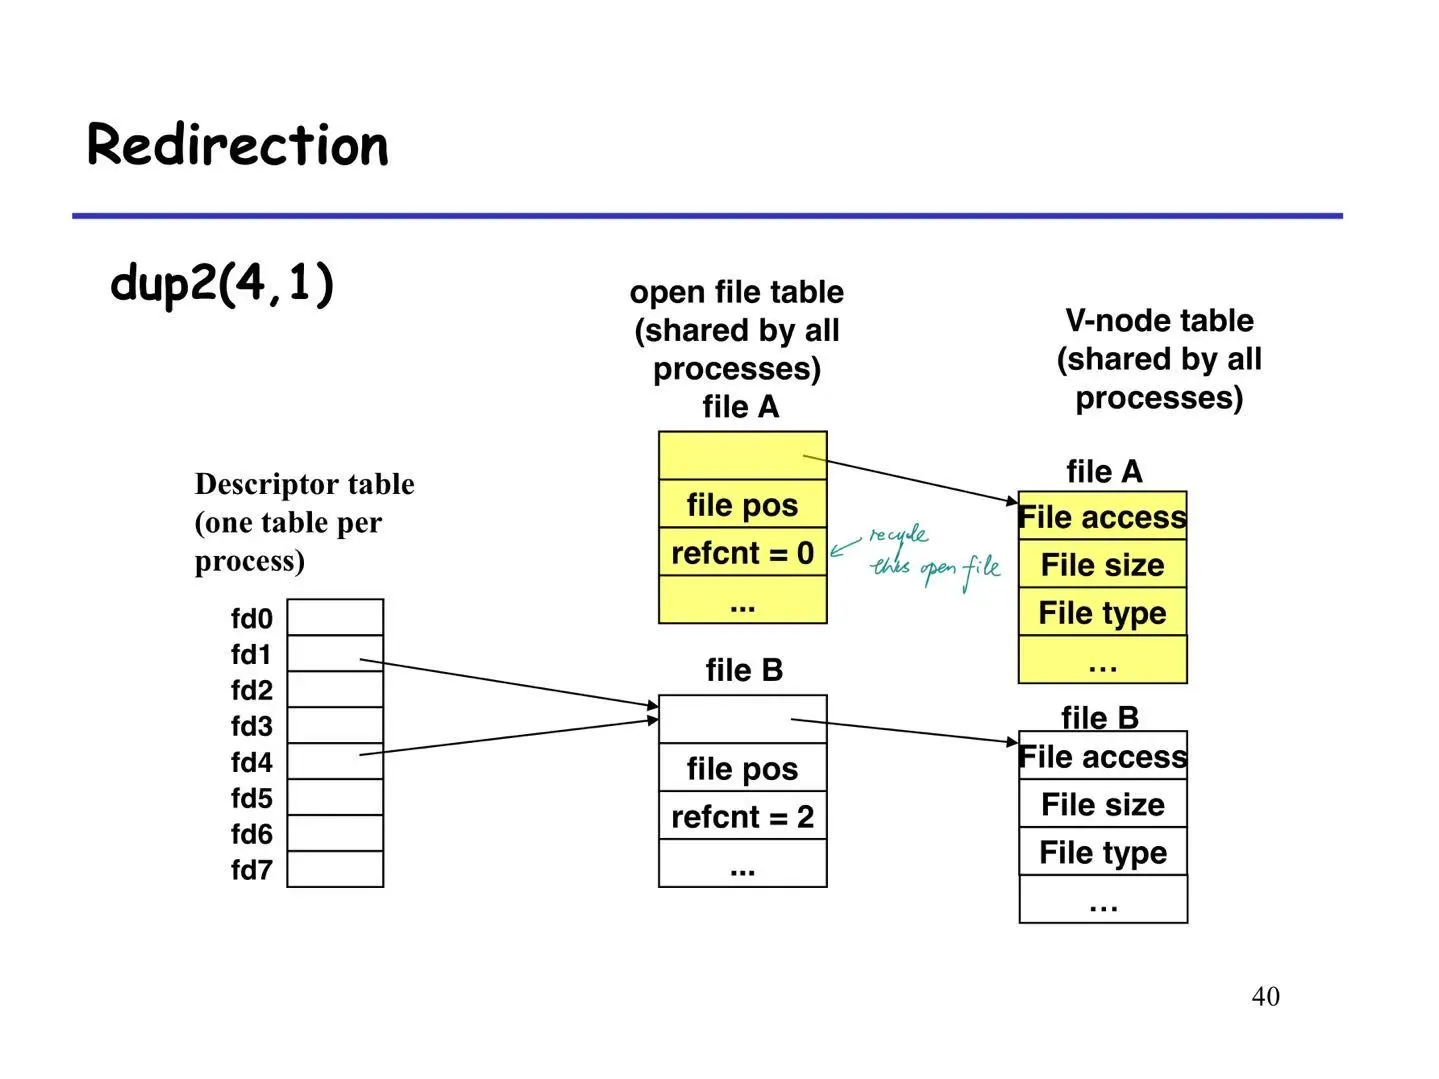
dup2()
int dup2(int oldfd, int newfd);作用:
让 newfd 指向 oldfd 所引用的同一个打开文件。
如果 newfd 已经打开,则会先自动关闭。
因此:
dup2() 常用于实现 Shell 中的:
<>>>2>
等 I/O 重定向功能。
如下图所示:
RIO(Robust I/O)
CSAPP 提供了一套封装后的 Robust I/O。
它的目标是:
- 避免系统调用被 Signal 中断;
- 保证一次读取或写入指定数量的数据;
- 提供更稳定、更可靠的 I/O 接口。
无缓冲版本(Unbuffered)
主要包括两个接口:
ssize_t rio_readn();
ssize_t rio_writen();
返回值:
- 成功:返回实际传输的字节数;
- EOF:返回 0;
- 错误:返回 -1。
其中:
rio_readn()
持续调用 read(),
直到:
- 已读取指定字节数;
- 遇到 EOF;
- 或发生错误。
因此能够避免普通 read() 一次读不满的问题。
rio_writen()
持续调用 write(),
直到所有数据都写入完成。
因此不会因为一次 write() 返回较小长度而导致数据丢失。
带缓冲版本(Buffered RIO)
Buffered RIO 在内部维护了一块缓冲区(Internal Buffer)。
所有高级接口最终都会调用内部函数:
rio_read()首先定义一个数据结构:
typedef struct {
    int rio_fd;                // File Descriptor
    int rio_cnt;               // Buffer 中剩余未读取的字节数
    char *rio_bufptr;          // 下一次读取的位置
    char rio_buf[RIO_BUFSIZE]; // 内部缓冲区
} rio_t;
然后初始化:
void rio_readinitb();之后即可调用:
ssize_t rio_readlineb();
ssize_t rio_readnb();
rio_readlineb()
按一行读取数据。
读取结束条件:
- 遇到
\n - Buffer 已满
- EOF
因此非常适合网络程序读取 HTTP Header。
rio_readnb()
读取指定数量的数据。
与 rio_readn() 类似,
区别在于:
它优先从内部 Buffer 中读取,
Buffer 不足时再调用 read()。
这样能够显著减少系统调用次数,提高 I/O 效率。
Standard I/O
C 标准库提供了另一套 I/O 接口:
例如:
fopen()

fclose()

fread()

fwrite()

fprintf()

fscanf()
它们将文件抽象成 Stream(流)。
与 Buffered RIO 类似,
Standard I/O 同样使用内部缓冲区,以减少系统调用次数。
但是 Standard I/O 更偏向于一次只处理一种 I/O 模式。
例如:
- 读(Read)
- 写(Write)
如果频繁在两种模式之间切换,则需要调用:
fflush()

fseek()

rewind()
等接口同步缓冲区。
因此:
对于网络编程,CSAPP 更推荐使用 RIO;
而对于普通文件操作,Standard I/O 更方便、更符合 C 的编程习惯。
Virtual Memory
Physical Memory 与 Virtual Memory
现代操作系统采用 Virtual Memory(VM) 机制,使每个 Process 都拥有一套独立且连续的虚拟地址空间,而实际的数据则存放在 Physical Memory(PM) 中。
这种设计带来了几个重要优点:
- 简化程序的内存管理;
- 提供进程隔离,实现内存保护;
- 支持按需加载(Demand Paging);
- 能够利用磁盘扩展可用内存空间。
Virtual Memory 作为 Cache
从另一个角度来看,Virtual Memory 本质上也是一种 Cache。
它将磁盘上的数据缓存到 Physical Memory 中。
因此:
Disk
    ↓
Physical Memory
实际上可以看作:
Physical Memory 是 Disk 的高速缓存。
由于 Physical Memory 容量有限,因此需要根据一定策略淘汰页面。
不过需要注意:
缓存的数据始终组织在 Physical Address 上,而不是 Virtual Address。
这一过程依赖后面介绍的 Reverse Mapping 等机制完成。
Page Table 与 Address Translation
由于:
- Disk 的访问延迟非常高(Large Miss Penalty);
- 一次访问整个文件开销巨大;
因此 VM 不会按字节管理内存,而是采用固定大小的 Page(页)。
通常:
Page Size = 4KBVirtual Memory 被划分为:
Virtual Page(VP)
Physical Memory 被划分为:
Physical Page(PP)
地址转换(Address Translation)的任务就是:
Virtual Page
↓

Physical Page
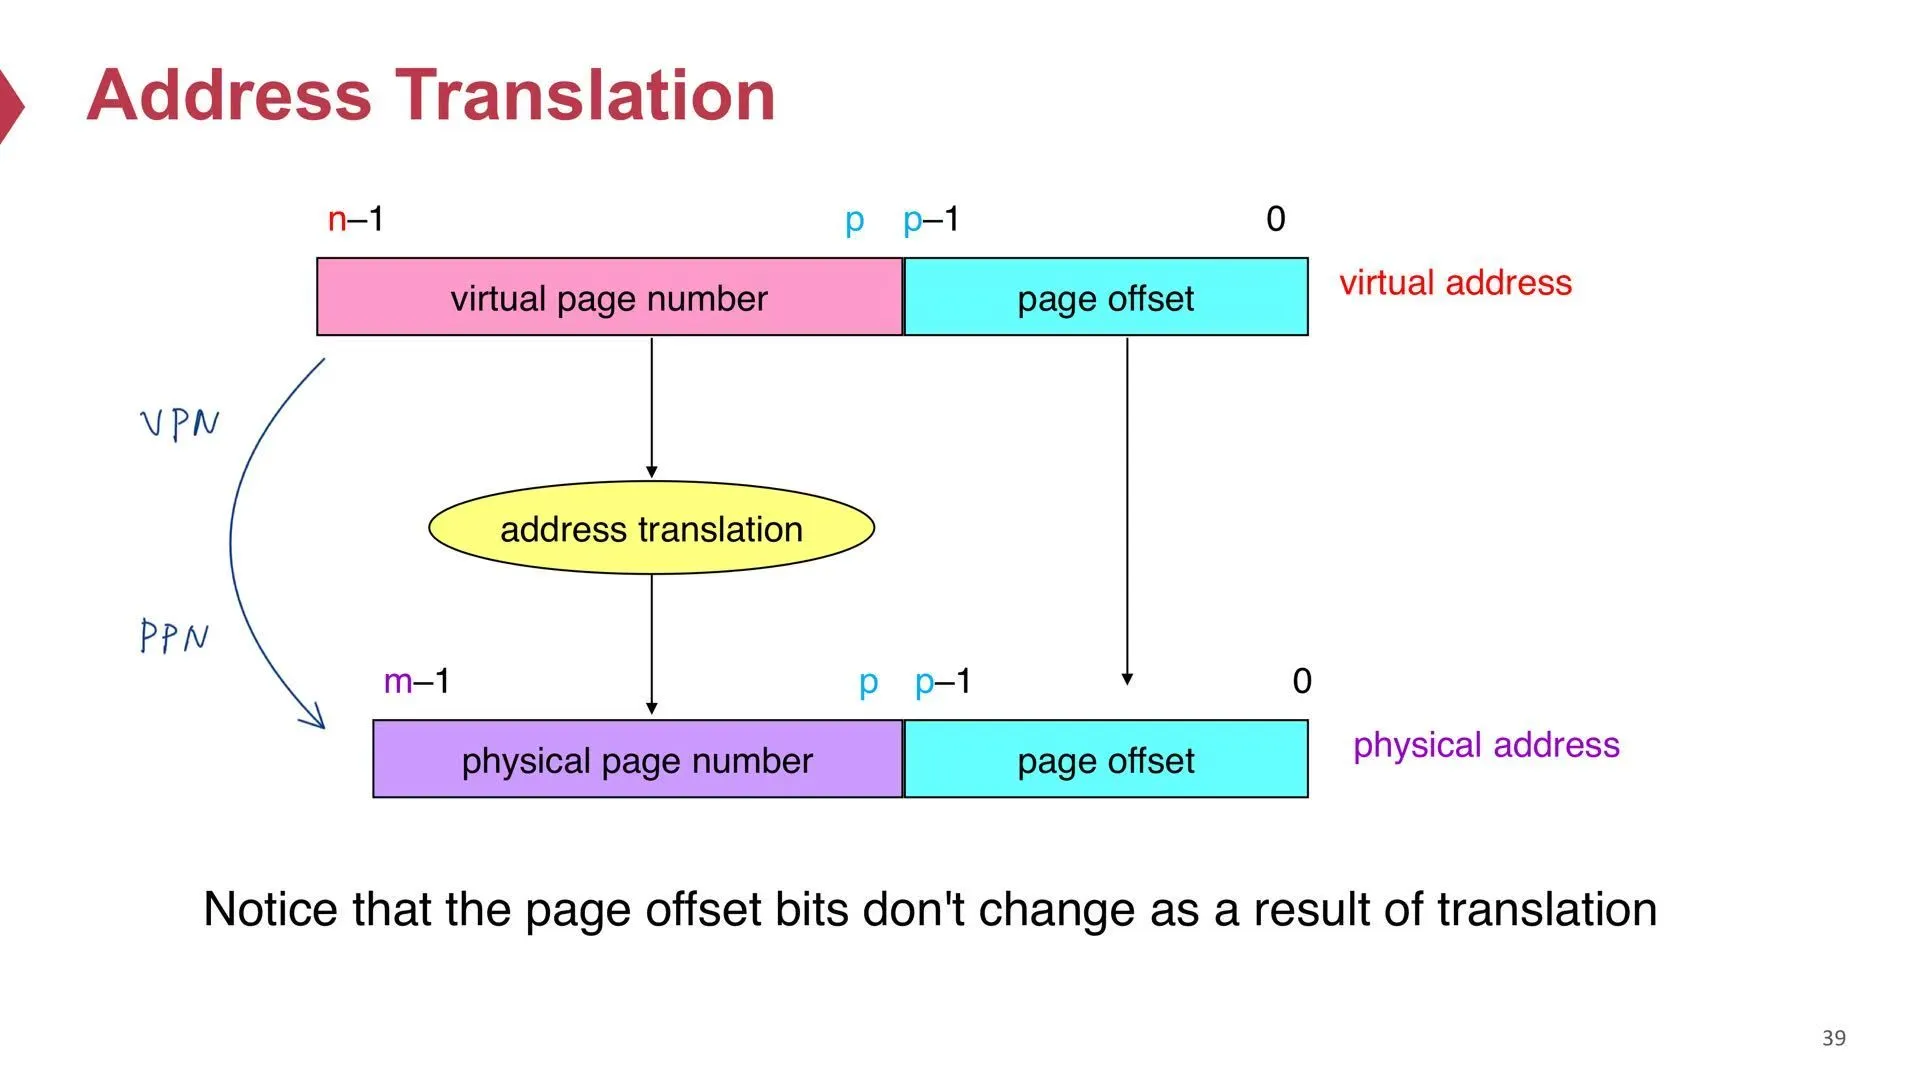
地址组成
无论是 Virtual Address 还是 Physical Address,
都可以划分为两部分:
| Page Number | Page Offset |其中:
- 前半部分表示所在的 Page;
- 后半部分表示页内偏移(Offset)。
如下图所示:
Page Table
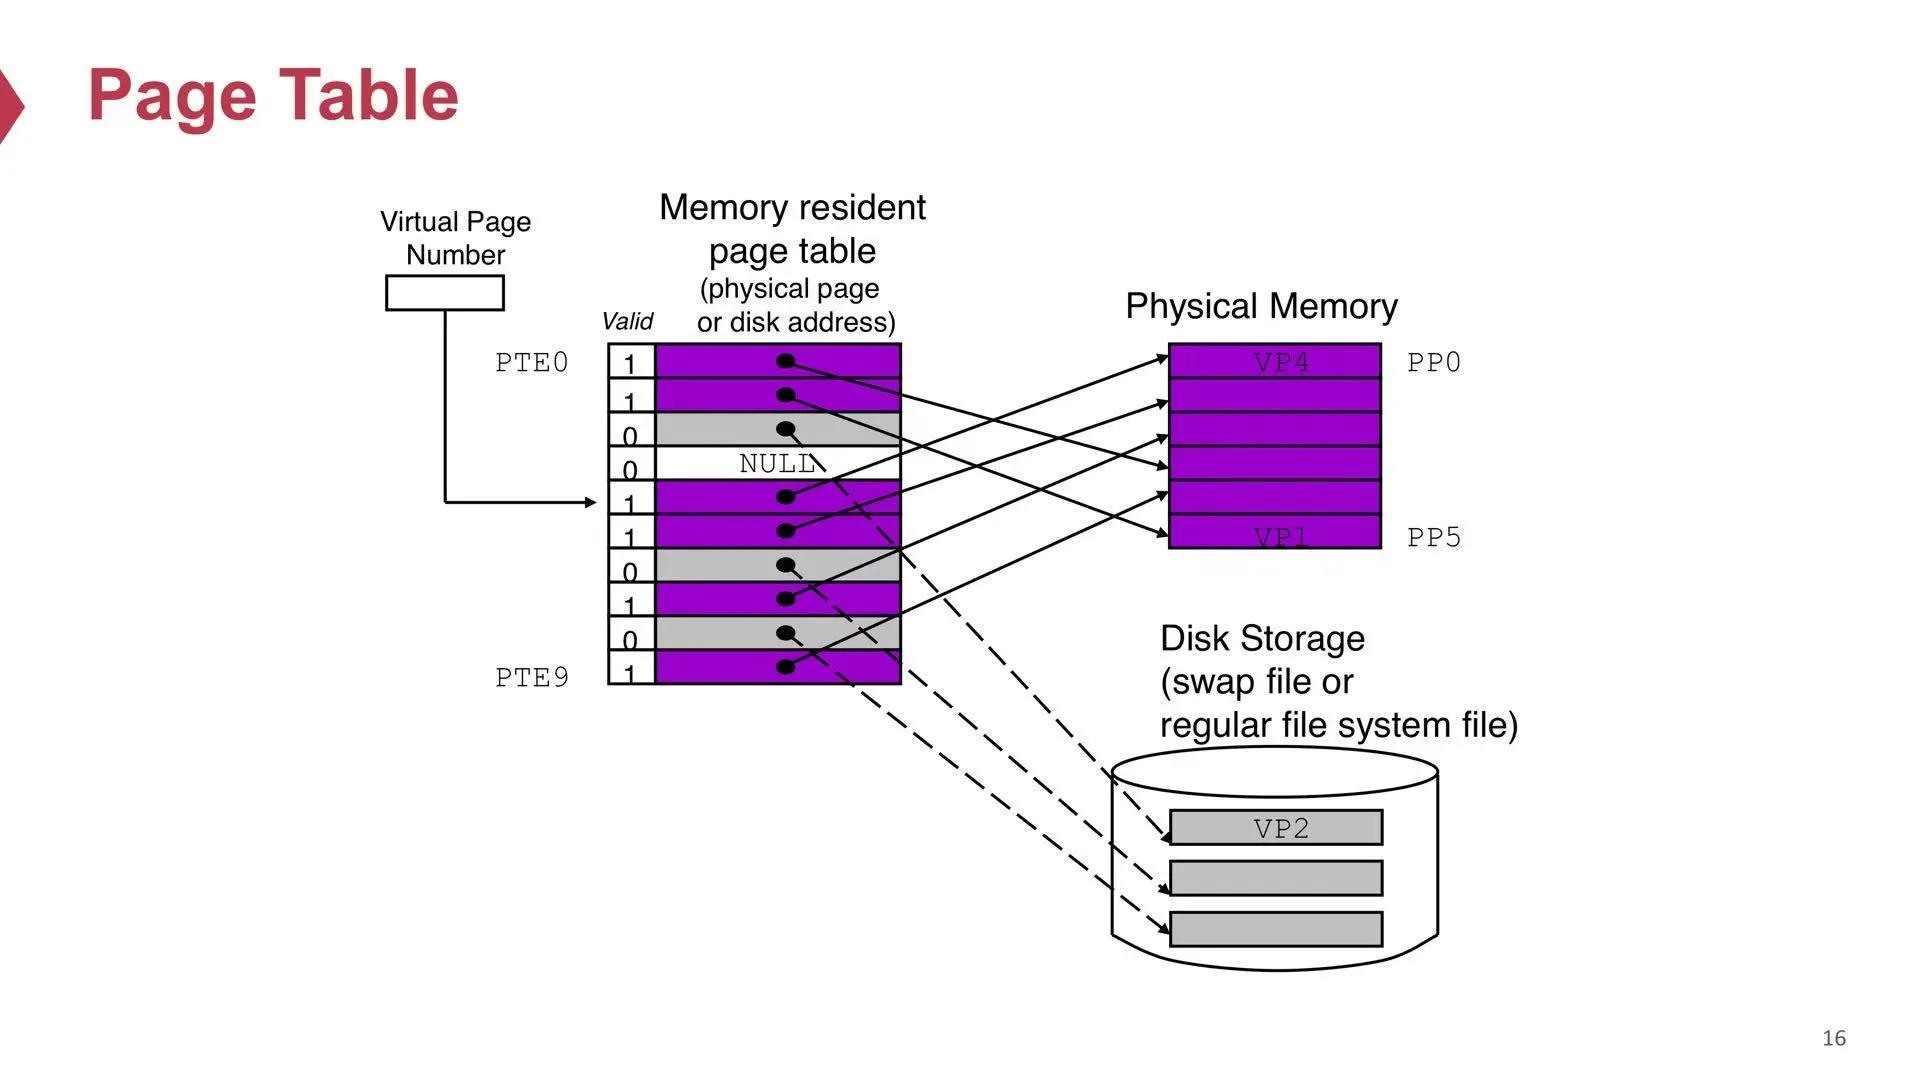
Page Table 保存了:
VPN
↓

PPN
之间的映射关系。
可以理解为:
VPN
    ↓
查 Page Table
    ↓
PPN
每一个表项称为:
Page Table Entry(PTE)
如下图:
##3 Page Fault
如果访问某个 Virtual Page 时:
对应 PTE 中的 Valid Bit 为 0,
说明该页面当前不在 Physical Memory 中。
此时将发生:
Page Fault
随后:
Kernel 会进入 Page Fault Handler。
Handler 会:
- 找到对应页面;
- 从 Disk 调入 Physical Memory;
- 修改 Page Table;
- 如果 Physical Memory 已满,则选择一个 Victim Page 进行淘汰(Swap Out)。
随后重新执行导致 Fault 的那条指令。
Page Table 的作用
Page Table 不仅完成地址映射,
还承担多个功能。
1. Memory Management
完成:
VA

↓

PA
之间的地址转换。
2. Memory Protection
PTE 中保存多个 Permission Bit,例如:
- Read
- Write
- Execute
Kernel 根据这些权限决定:
某次访问是否合法。
例如:
Code Segment

↓

Read + Execute

×

Write
即可防止程序修改自己的代码。
3. Memory Recording
PTE 还包含一些状态位,例如:
- Reference Bit(访问位)
- Dirty Bit(脏位)
其中:
Reference Bit
记录页面最近是否被访问,
供页面替换算法使用。
Dirty Bit
表示页面是否被修改过。
如果 Dirty Bit 为 0,
页面可以直接丢弃;
否则需要写回磁盘。
TLB
虽然 Page Table 功能强大,
但一次地址转换需要额外访问内存。
例如:
访问一次数据:
VA

↓

查 PT(一次 Memory Access)

↓

得到 PA

↓

再次访问 Memory
因此:
一次访存实际上需要:
Memory

↓

Memory
共两次访问。
为了解决这个问题,
CPU 引入了:
TLB(Translation Lookaside Buffer)
TLB 本质上就是:
Page Table 的 Cache。
它通常采用 SRAM 实现,访问速度远快于 DRAM。
如果:
TLB Hit则可以直接获得 PPN,
无需再次访问 Page Table。
Multi-level Page Table
如果采用单级 Page Table,
假设:
Virtual Address = n bit

Page Size = 4KB
那么:
需要维护:
2^(n-12)个 Page Table Entry。
对于 64 位系统而言,
这将消耗极大的内存。
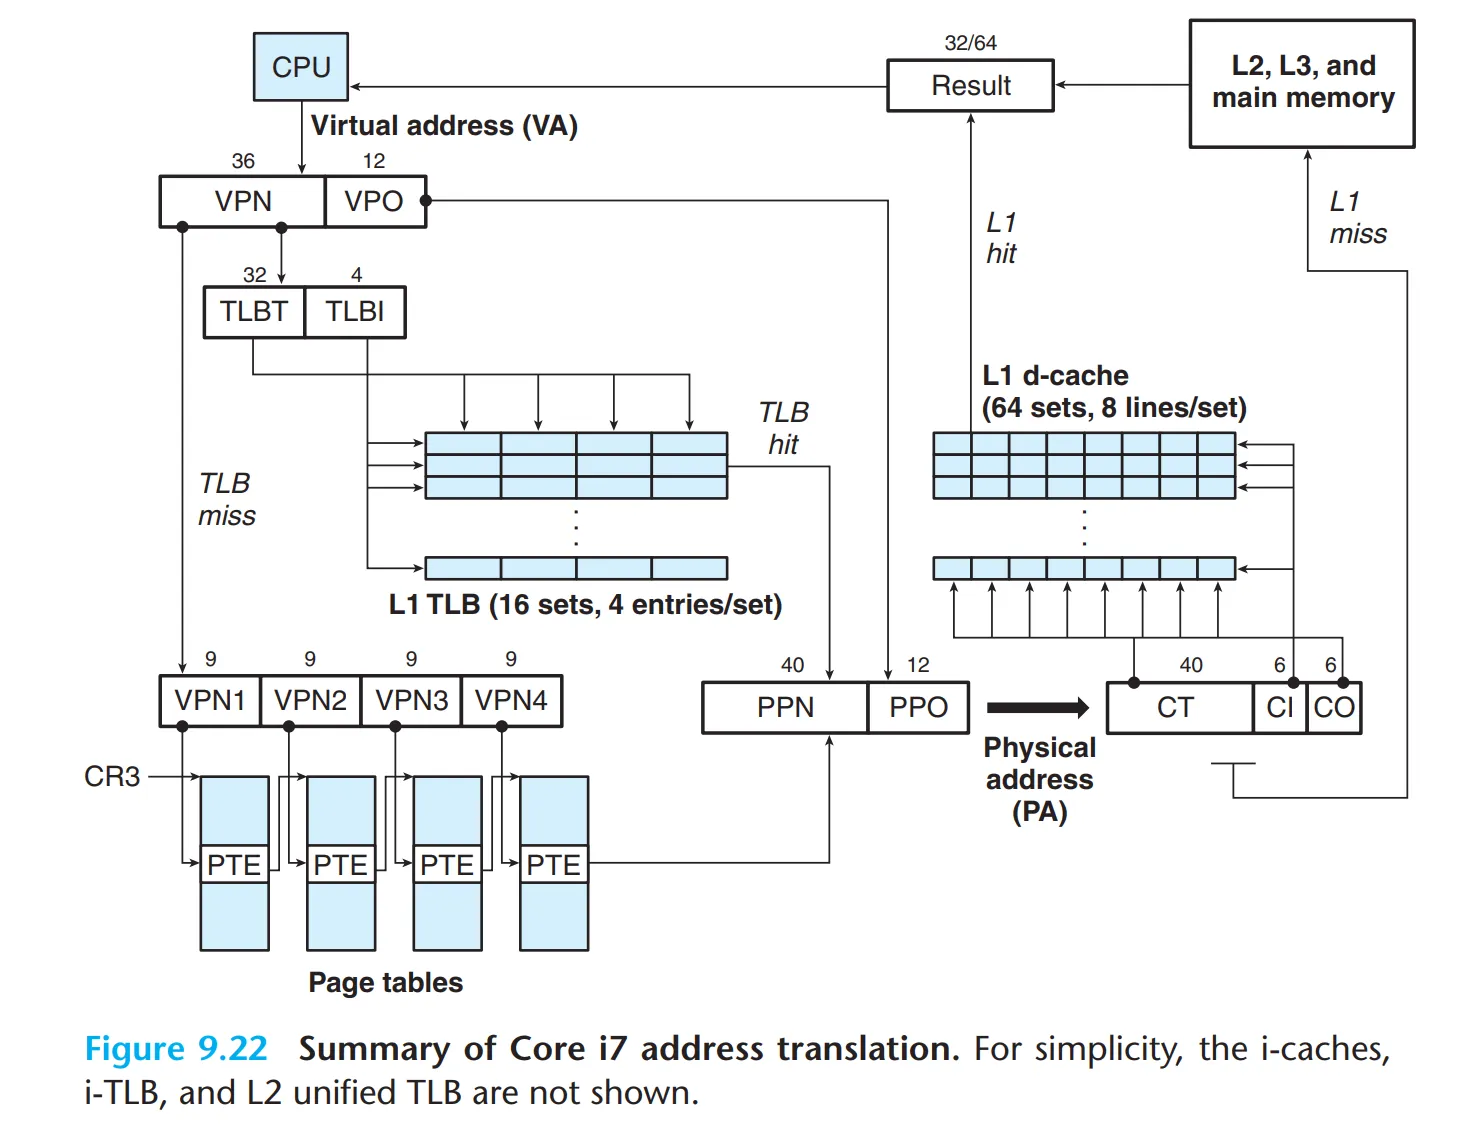
因此现代系统采用:
Multi-level Page Table(多级页表)
将整个页表拆分为多个层次。
只有真正使用到的部分才会分配内存。
这样能够显著降低空间开销。
第一层 Page Table 的基地址保存在:
CR3 Register
由于 CPU 每次地址转换都需要访问它,
因此:
第一层 Page Table 本身不能被换出。
如下图所示:
VMA
Linux 使用:
Virtual Memory Area(VMA)
来描述一段连续 Virtual Address Space。
对应的数据结构如下:
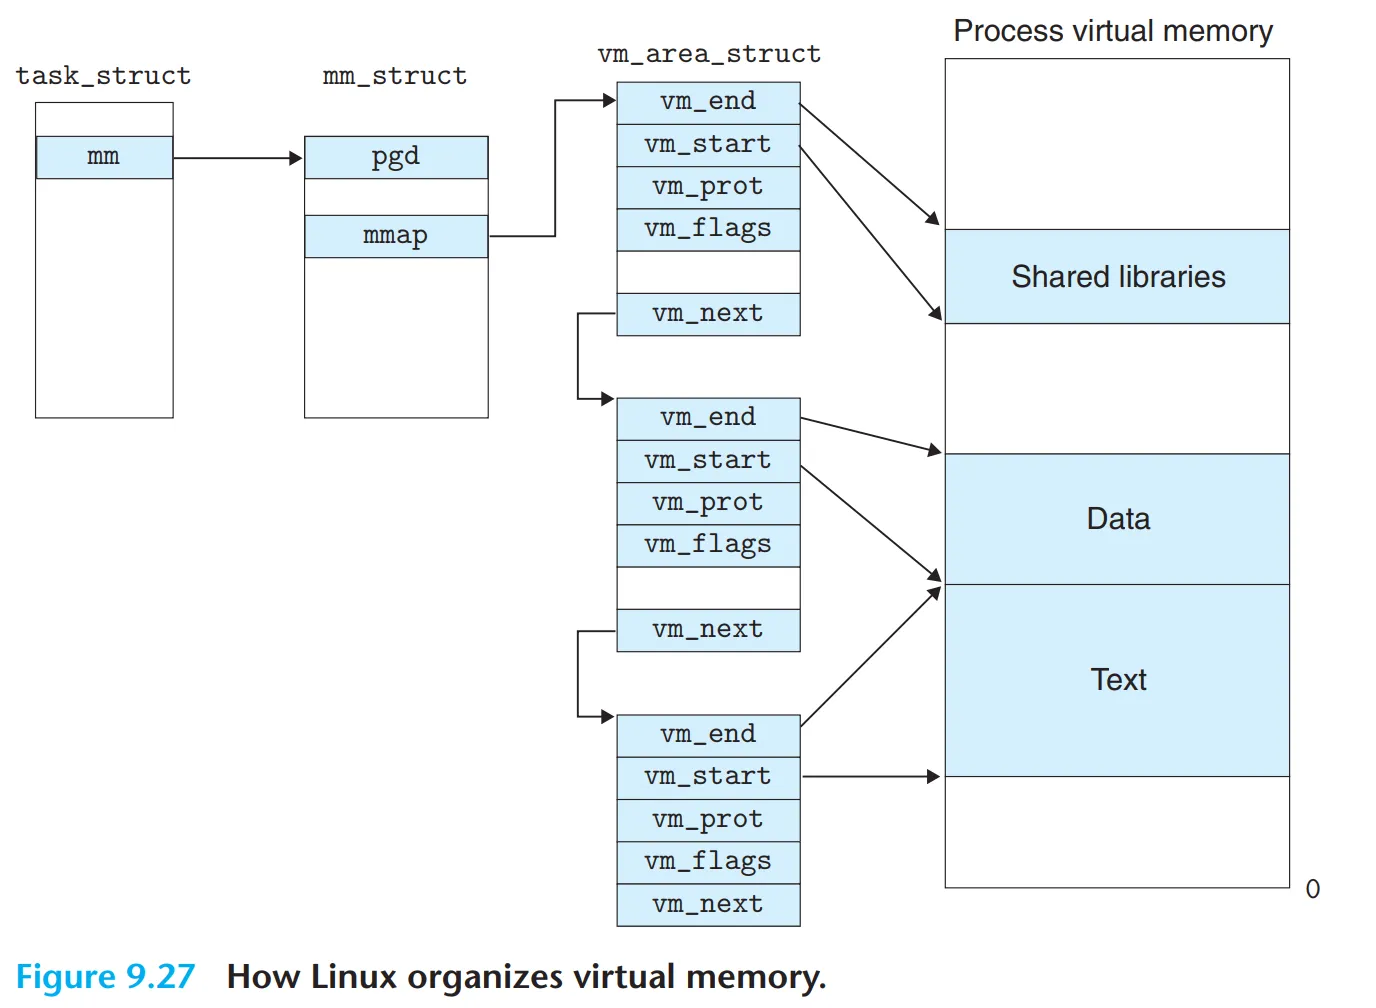
其中:
-
vm_prot表示访问权限。
-
vm_flags表示映射属性,例如:
- Shared
- Private
每个 Process 通常包含多个 VMA,例如:
- Code
- Data
- Heap
- Stack
- Memory Mapped File
Memory Mapping
一个 VMA 可以通过 Memory Mapping 获得初始内容。
映射对象可以来自:
- Disk 上的普通文件(Regular File)
- Anonymous File(匿名映射,没有对应文件)
fork() 再次分析
执行:
fork();之后,
Kernel 会复制:
mm_structvm_area_struct- Page Table
但是:
Physical Memory 并不会立即复制。
这是因为:
Linux 采用:
Copy On Write(COW)
策略。
具体来说:
父子进程最开始共享同一份 Physical Page。
只有当其中某一方第一次写入时,
Kernel 才真正复制对应页面。
因此:
COW 属于一种典型的 Lazy Strategy(延迟策略)。
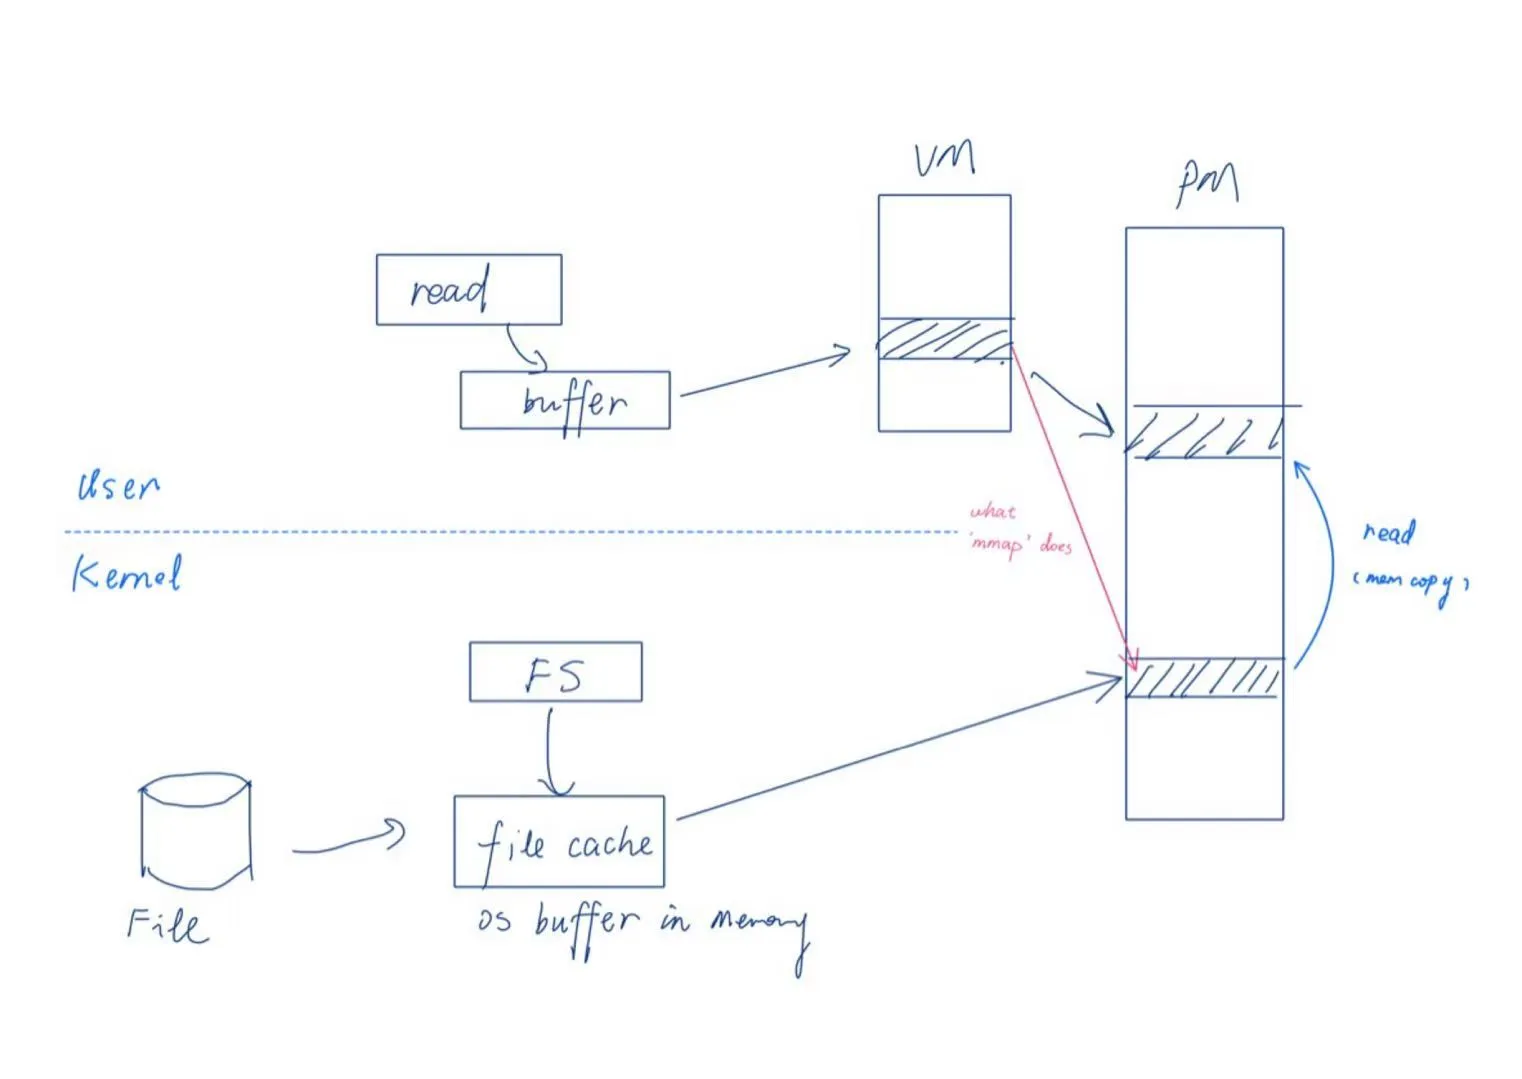
mmap()
用户程序也可以直接调用:
mmap()建立 Memory Mapping。
相比:
Disk

↓

Kernel Buffer

↓

User Buffer
传统读写方式,
mmap() 可以直接建立:
Disk

↓

Virtual Memory
之间的映射。
因此:
程序访问内存时,
Kernel 会自动完成页面调入,
避免了额外的数据复制。
如下图:
Page Swapping 与 Replacement Policy
当 Physical Memory 不足时,
Kernel 会将部分页面交换到 Disk,
这一过程称为:
Page Swapping。
通常,
Kernel 会维护:
- High Water Mark
- Low Water Mark
当可用内存低于阈值时,
后台线程开始进行页面回收。
常见页面替换算法
OPT
Optimal Algorithm。
理论上的最优算法:
始终淘汰未来最长时间不会再次访问的页面。
由于需要知道未来访问情况,
因此只能作为理论上界。
FIFO
First In First Out。
最早进入 Memory 的页面最先被淘汰。
实现简单,
但可能出现 Belady’s Anomaly(Belady 异常):
增加 Memory 容量反而导致更多的 Page Fault。
LRU
Least Recently Used。
淘汰最长时间没有被访问的页面。
利用程序具有 Temporal Locality 的特点,
通常能够取得较好的效果。
由于精确实现成本较高,
现代操作系统通常采用近似 LRU 算法。
Clock Algorithm
Clock(时钟算法)是 LRU 的一种近似实现。
每个页面维护一个 Reference Bit。
系统像时钟一样循环扫描所有页面:
- Reference Bit 为 1,则清零并跳过;
- Reference Bit 为 0,则选择该页面作为 Victim。
Linux 中的页面回收算法也是基于类似思想进行改进实现的。