Article
EAGLE
On this page 14
Extrapolation Algorithm for Greater Language-model Efficiency , EAGLE 算法学习
前面看完了Medusa方法,再看加速效果更好的EAGLE
二更:
学习DFlash的时候又重新回顾了一下,在ref block里加了一些思考的内容
EAGLE
下图是这几种方法的对比:
- spec sampling 是 token-level
- Medusa 是利用一个 feature 用不同的 head 去预测不同位置的 token
- EAGLE 是将 token 和 feature 混合输入
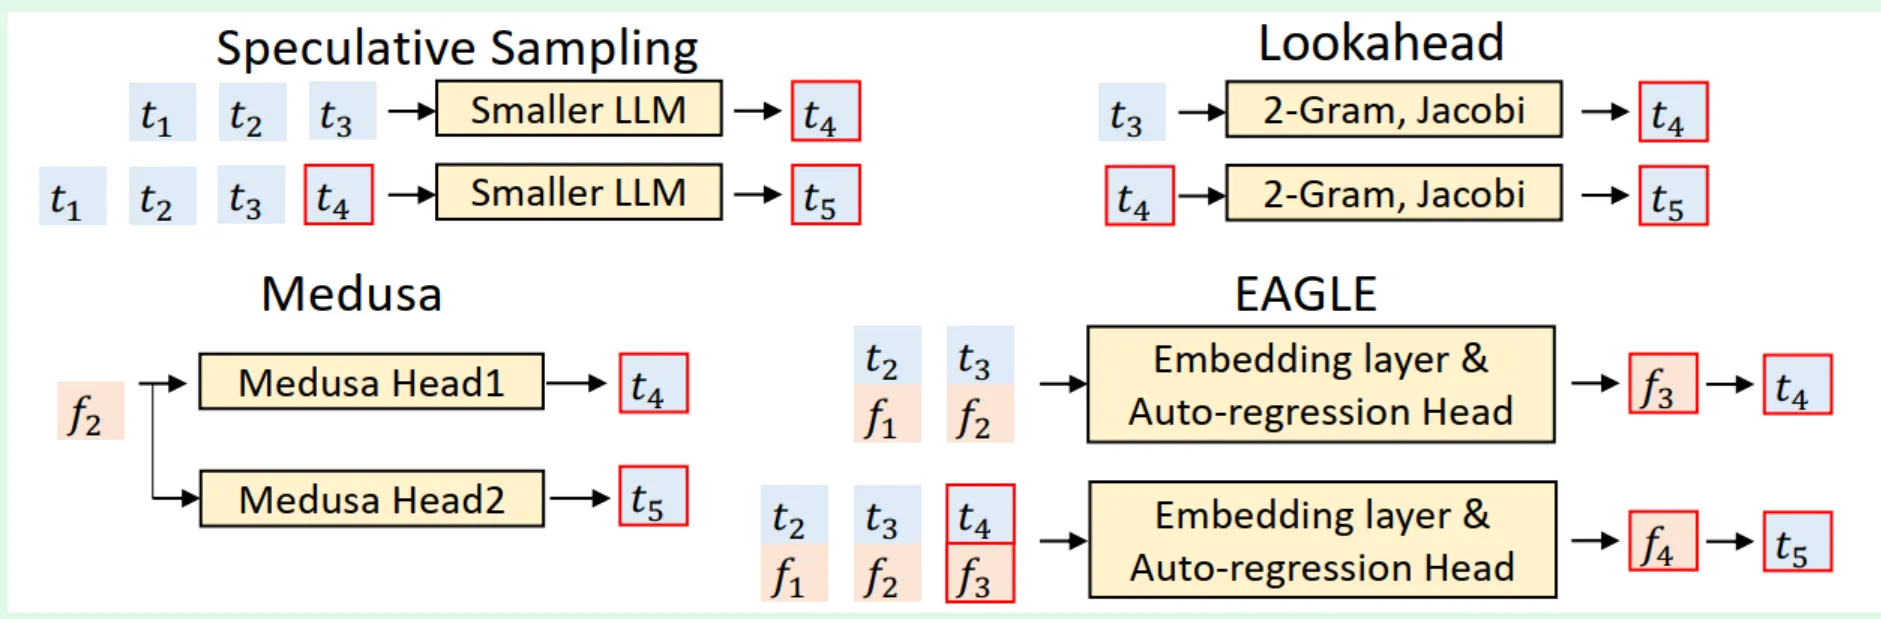
论文首先指出这个方法的提出和实现基于两个观察:
- feature-level 的自回归比 token-level 要容易,因为token的采样是随机的
- sampling 过程中产生的随机性会显著限制预测 next feature 的表现,而在输入中加入上次采样得到的 token ,能有效消除这种不确定性
提炼
看完整篇论文,我认为相较于 Medusa 利用多头去处理 feature ,EAGLE则是训练了一个针对 feature 的 draft model 。
针对上面的观察一,我的理解是:一个标准的 llm 输入输出都是 token ,而 token 采样的时候引入了不确定性,或者说在sampling的过程中已经消减了很大一部分的信息,这会要求模型有更多的参数和计算来提升精度,因此很难获取一个非常理想的 token-level 的 draft model 。并且由于 token-level 的问题是离散空间里稀疏变量的问题,而 feature 则是一个高维的连续向量。因此 feature 的变化是容易学习的,针对他设计的模型也更简单,推理也快得多
而针对上面的观察二,我的理解是:在常规llm流程中,一般是 hidden_states -> logits -> 采样得到token -> hidden_state,也就是说采样这一步给feature引入了不确定性。为了消除这个不确定性,可以把采样完的 token 和 hidden_state(feature) 一并输入;换句话说,从出发,当前的 feature 并不知道自己要往哪个方向进行变化,因为是有一步随机的步骤即 token 的采样决定了它这一轮的变化,所以将采样完的 token 一并作为数据,相当于告诉了 一个走向 的方向,可以极大消除的不确定性,提高接受率。
论文节选
1. EAGLE pipeline / Draft Model
下图为 EAGLE 推理的流程:
- green : embedding
- orange : feature
- red : prediction of draft model
- blue (with snow icon) : target LLM parameter
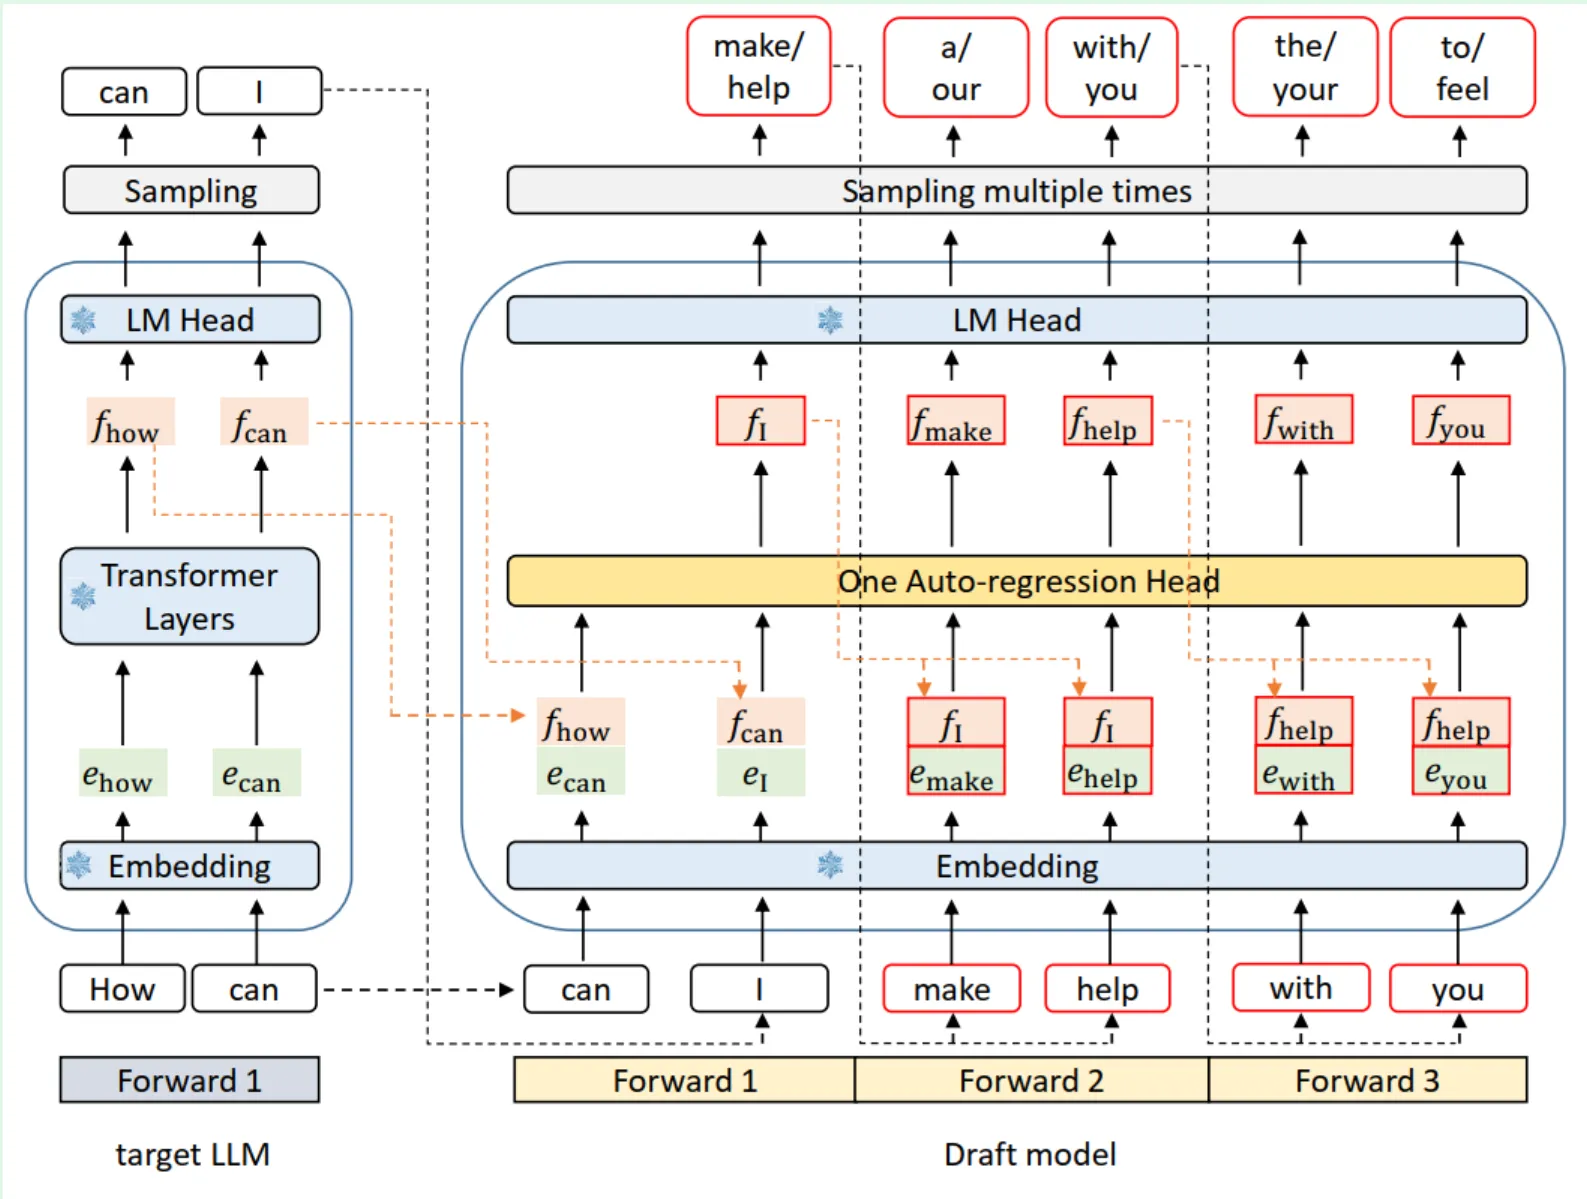
可以看到这里 Draft Model 由三部分组成:
- Embedding Layer : 与目标 LLM 共享
- LM Head : 与目标 LLM 共享
- Autoregression Head :由一层 FC layer 和一层 decoder 构成
Draft Model 的输入是一个形状为 (bs, seq_len, hidden_size) 的 feature 和一个形状为 (bs, seq_len) 的 token 。token 序列会被 embedding层转换成 embedding ,最后合并成形状为 (bs, seq_len, 2*hidden_size) 的输入
Q: 这里draft model使用了KV cache吗? 作为AR的结构,是使用了cache的;这里cache是draft model自己的,因为他是另外训练得到的qkv矩阵 因此draft model要想看到前面prefill的kv cache,不能搬运target的,而是得自己跑一遍prefill来拿
FC 层的作用是将 (bs, seq_len, 2*hidden_size) 降维成 (bs, seq_len, hidden_size)
在计算 draft 的时候,EAGLE 构建了一颗树。这棵 Draft Tree 的深度是 ,拥有超过个的 token 数,只会执行步 forward。
例如,下图是草稿生成的过程中构建的树,可以看到天然的不含有 Medusa 中那种缺乏逻辑性的分支。 这里深度为3,token数为10
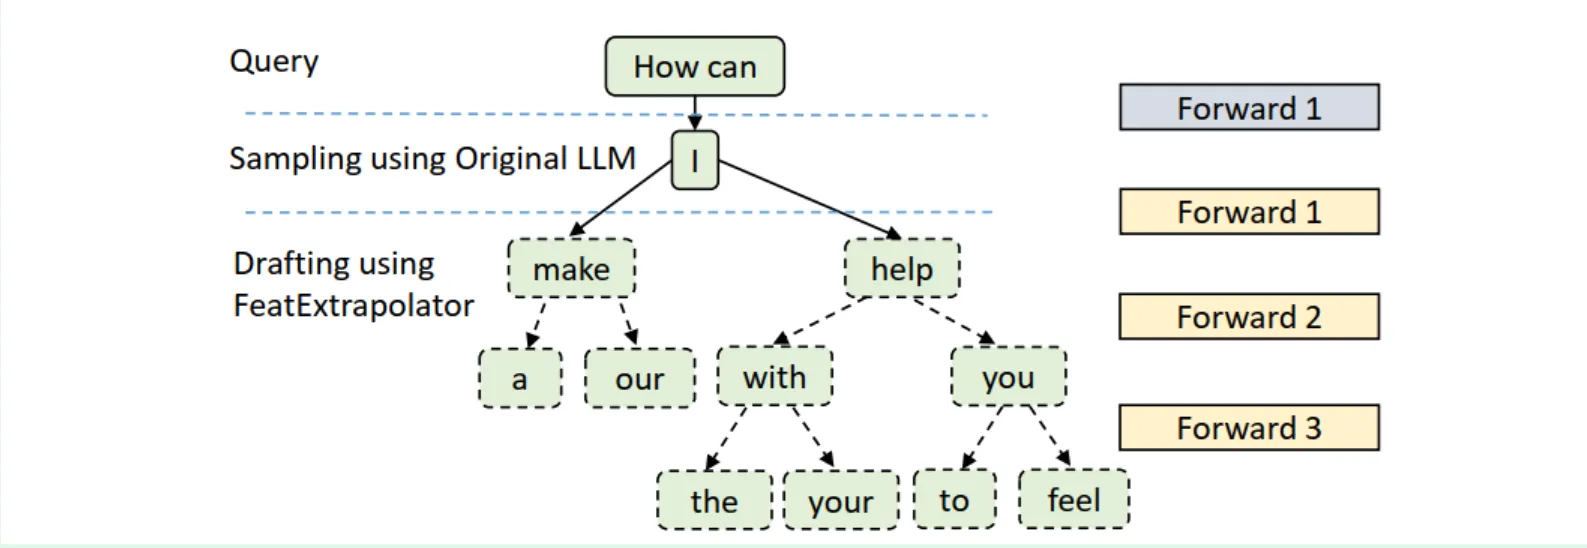
对于这颗树的构建规则,附录中有提到一些:
- greedy:每个节点选择 top k 作为儿子
- intuition:高概率的分支应该更深/更广
最终都使用了这颗静态的树
遵循上面两个规则,在每一层中,左边的节点的概率是更高的,并且左边拥有更好的深度
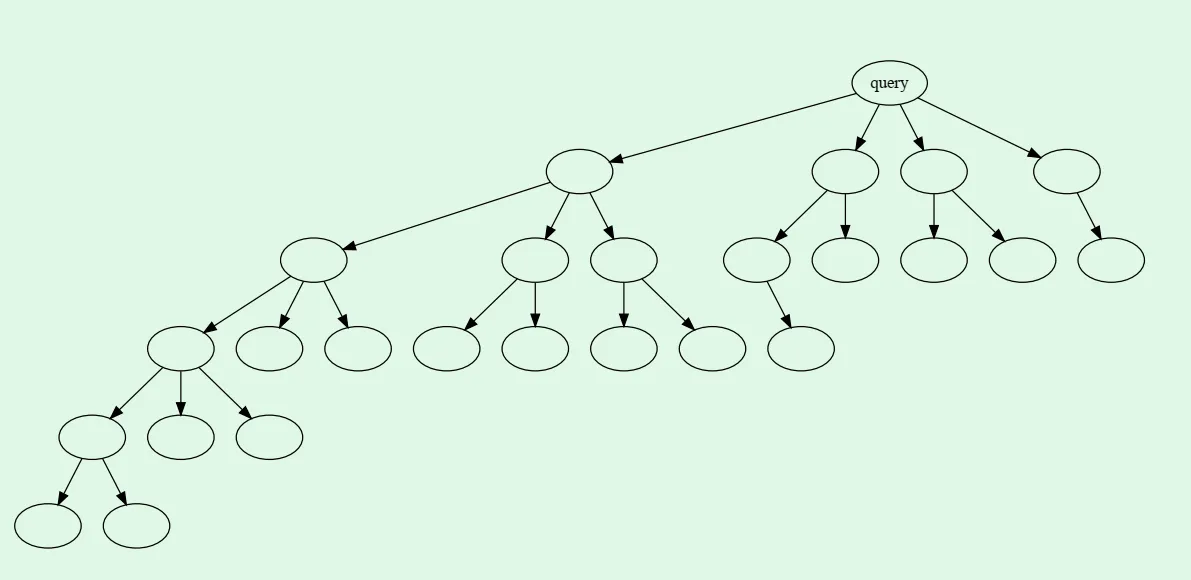
具体的后面看完代码之后可能我会来补
(EAGLE-2改成动态树了,不看这一块了)
2.Training
这是草稿模型进行一次前向传播
预测下一个 feature 使用了残差的方式,并使用了 Smooth L1 作为损失
而预测下一个 token 则是一个 Classification loss
最后联合回归损失和分类损失,得到
通常分类损失是显著大的,所以论文中将权重设置为了 0.1
3.Verify
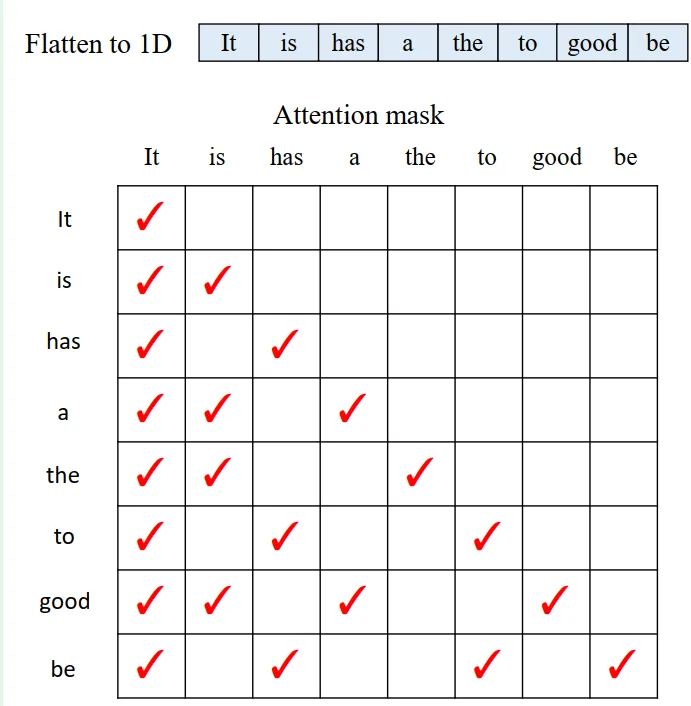
使用了和 Medusa中类似的 Tree Attention
EAGLE-2
和第一版的主要区别是树的变化 (Context-aware dynamic draft tree)
文章在开头首先指出了 EAGLE 和 Medusa 使用的都是同样的静态 draft tree ,这本质上基于了一个假设:一个 token 的接受率很大程度上取决于他在这个树上的位置
自然地假设概率高的draft token更会被接收,由此得到的静态树一定是向左倾斜的
为了减少生成和验证的开销,树的右侧的token自然要减少
但是这和 spec sampling 中 *“some tokens are simpler and can be predicted by smaller models”*会产生一些冲突,当一个简单的token出现的时候,也许我们不需要这棵静态的树,用一个链表就能解决。实验也发现了 token 接受率还和上下文密切相关。因此静态树有天然的限制。在不同的 context 下动态的调整树会更好
动态调整树肯定会有更好的效果,但是就是动态带来的收益要能大于动态树产生的开销
要想拥有更适应 context 的动态结构,就需要原始 LLM 对上下文的推导。而这个推导的结果,在正常的decoding中,就是新生成的hidden。这与加速的目的相悖。但是 EAGLE 的实验结果证明了 draft model 具有良好的校准性(Well-calibrated),它的置信度分数(即预测的token概率)能够很好地近似最终验证得到的 Draft Token 的接受率
EAGLE-2 基于这一点事实展开,通过动态树的构建提高了接受率(acceptance rate)
Well-Calibrated Draft Model
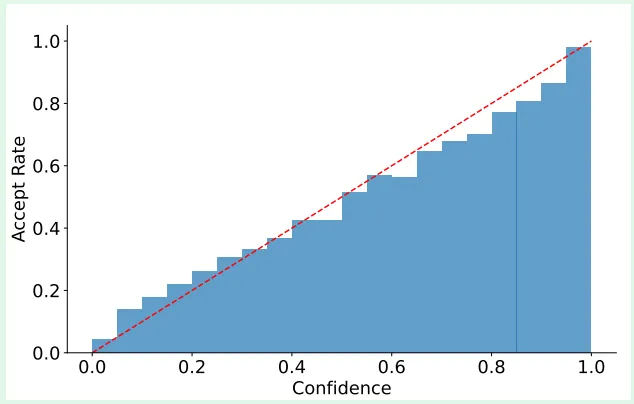
EAGLE-2 提供了这样一张统计图,其中,
Confidence 就是 Draft 预测的分布;而接受率在贪婪搜索下就是 和 预测的最可能的结果一致,在随机采样中是如果 target 认为这个词出现的概率比 Draft 预测的概率还大,那么就是 1.0 的接受率,否则按照比例接受
这样的校准性能够避免使用 Target LLM 对上下文的推导,仅仅用 Draft 就能寻找动态树的路径
Expansion of tree
Tree Attention 可以很好的并行验证,但是token太多开销过大,因此需要选择性的添加token
因为否定一个 token 就是截断这条路径,所以衡量一个 token 的价值的值是 Global Acceptance,即,然后留下 top-k的 token
Reranking Nodes
经过 expand 之后,还要进行一次排序筛选,保留所有节点中期望收益最高,也就是 Global Acceptance最大的 个 token
这一步会有一个现象,就是浅层的 token 会比深层的 token 更有优势,因为每一次都是乘一个小于 1 的数,所以当模型很自信的时候,会生成更深的路径,一次推理中能走更多的步骤;而当模型很困惑的时候,树的结构趋向于“收缩”,预测趋于浅层,节省深层 token 验证的资源,提高整体期望值
示例:
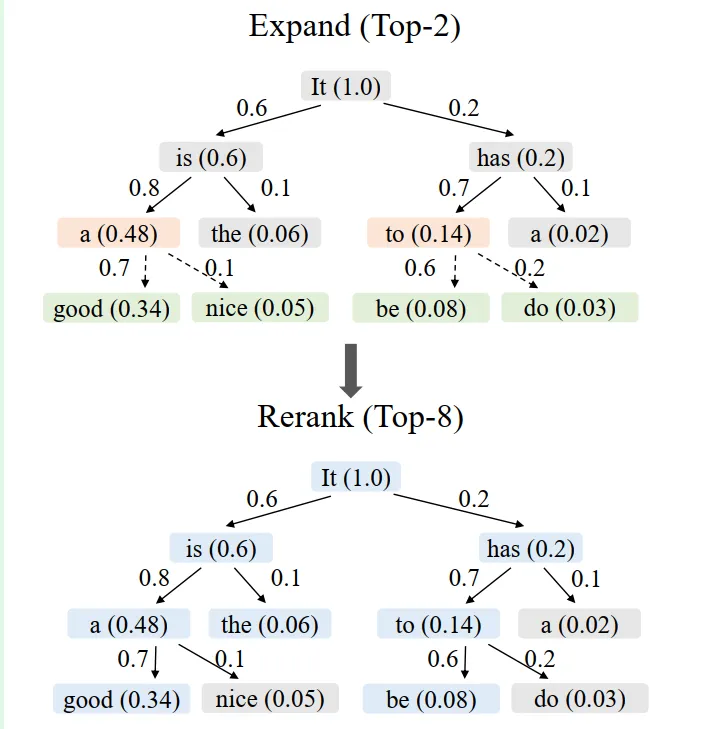
用 tree-attention 验证:
EAGLE-3
第三版主要是在训练上
新的训练架构
Training-time test
EAGLE 的训练是基于 feature-level 的,训练的损失是联合回归损失和分类损失。是feature的损失,但是的 token 损失其实才是最终的目标。这也就意味着 feature 会施加一个额外的约束,让 Draft Model 很难在更大的 training data 中获益。为此 EAGLE-3 做了这样的尝试:
- 取消 feature 的 loss :显著提高,但是feature的预测显著下降导致以及后续急剧下降
- 当前的训练是割裂的训练每一步,最终得到是一个单步预测器,因此幻觉可能在推理的过程中积累。通过在训练中加入推理得到的数据,可以很好的解决;同时可以把 feature 以这种形式加入训练
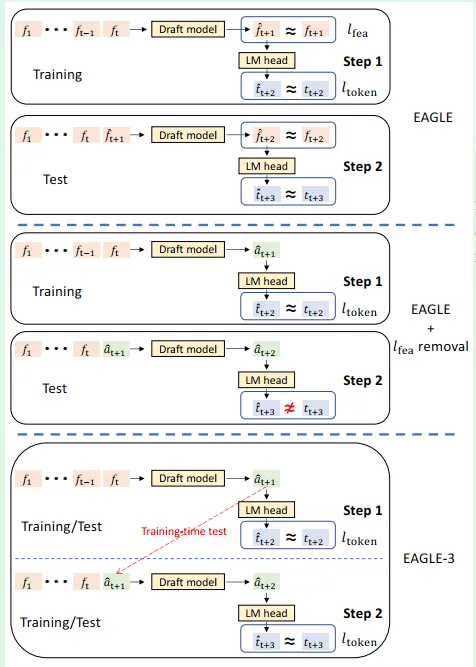
上图展示了两种方法的逻辑,这种新的方法被命名为 training-time test
特征利用
过去只使用最后的一层 hidden_layer 这个 feature , 但是现在充分利用了其他的更多的 feature
Scaling Law
新的架构随着 Data 的增长,Accept Rate 也显示出了增长
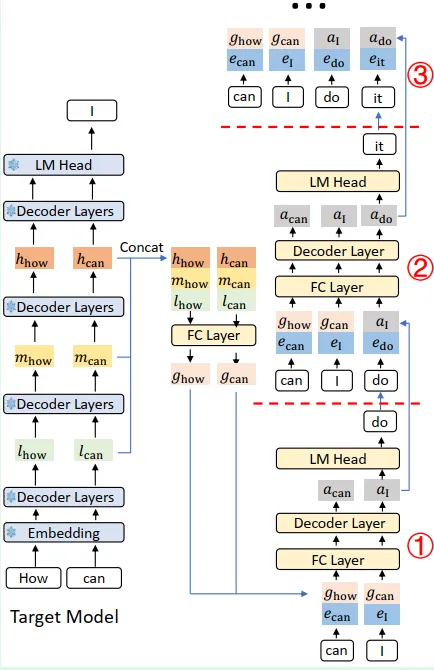
Pipeline
第三版的pipeline如下图。除了增加了底层的 hidden_state 的使用;同时由于训练的时候使用的新方法,draft 部分原本的单步预测器也变成了更 transformer 的 decoder;decoder输入的序列中,会重复使用生成的 draft feature,对应了训练得到的”轨迹感“,能根据前面所有步骤形成的动态趋势进行自我修正
Training
唯一要训练的部分就是 transformer decoder,训练的时候用了 tree-mask,从一个序列里产出的只能看到它这条路径上的Key(示意图里用 token 来代替了 feature 的表示)
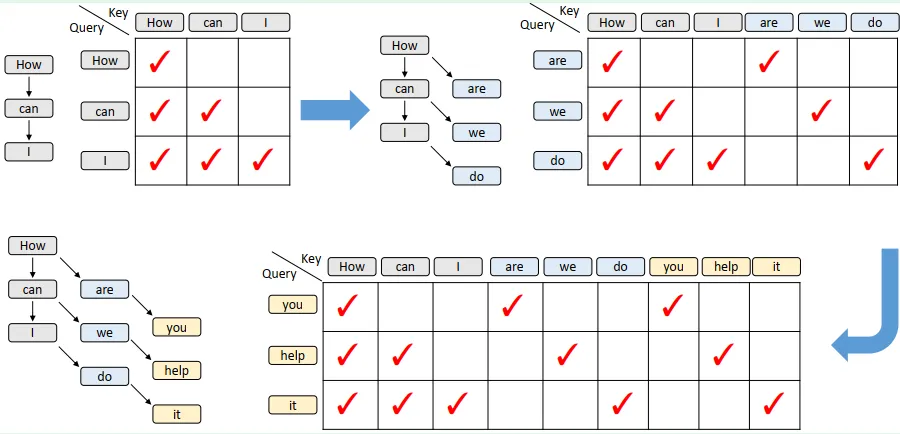
对于每一步的训练,由于浅层的错误是更致命的,所以可能会给不同深度的节点分配训练权重,看代码的时候看看
总结
EAGLE 由于加入了 token 的选择,可以加强 spec 过程中的上下文逻辑,减轻不确定性,从而获得更高的 Accept Rate
第二版通过动态树的结构,算是优化了算力的调度,让计算资源流向了更有用的 token ,提升了推理效率
第三版主要是在训练上增强,提升了 Draft Model 的表现