文章
DSpark
本文目录 8
Intro
DSpark是dpsk提出的一种SD的方法
之前的SD面临这样的问题:
- auto-regression的实现由于draft的串行,会带来比较大的延迟
- parallel的实现(比如DFlash),因为无法获取块内的信息,所以接受率很难提高
- 生成draft的长度难以评判,过长容易浪费verify资源,导致throughput下降,过短收益不大
对此提出的提升方案:
- 使用semi-autoregressive architecture,半自回归
- confidence-scheduled verification,对draft先进行自信程度的打分,动态调整生成的draft的长度
架构
整体流程架构的示意图
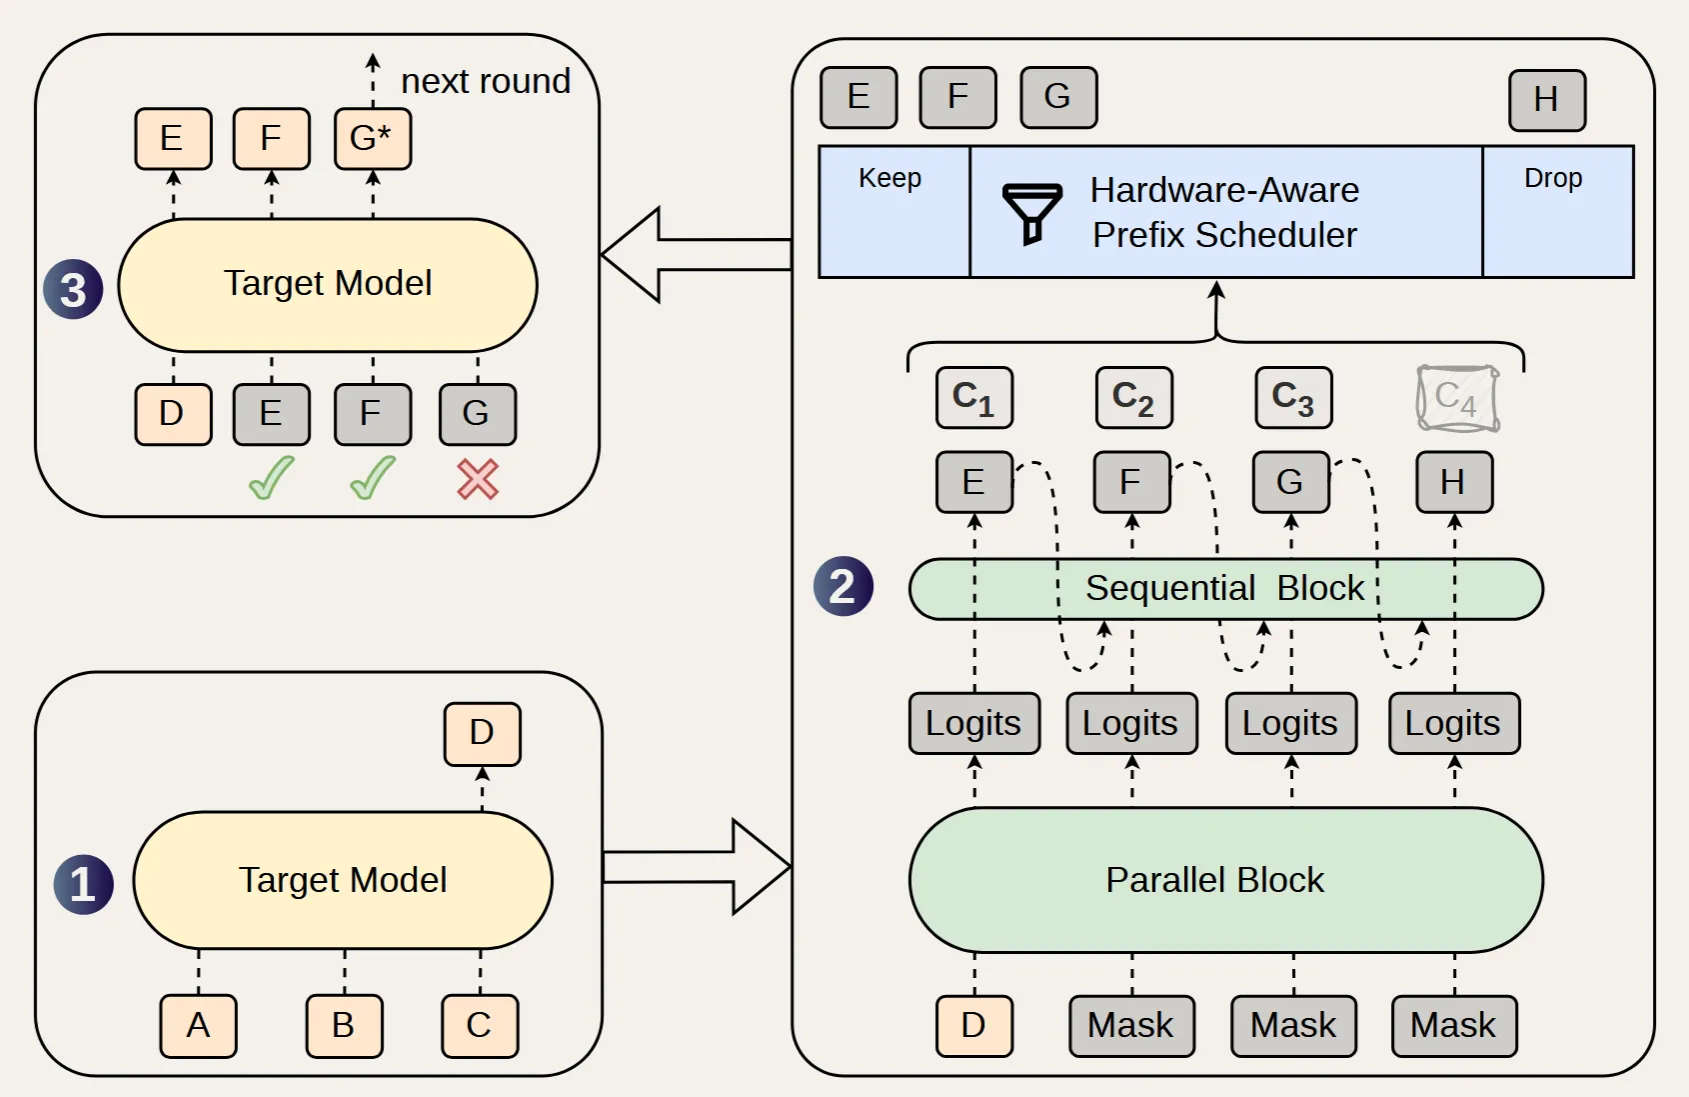
semi autoregression
分为两个part,一个part是Parallel Block,另一部分是Sequential Block
parallel block就是和DFlash一样的diffusion block,这里就不多介绍了
sequential block则是通过生成一个依赖前缀的Bias,去叠加到原先的logits上:
是原本的logits,就是第k个token的第v个词语的概率
而bias的计算方法,DSpark这里提供了两种:
- Markov Head:
- 利用markov性质,仅对相邻的做
- naive的实现会变成到的映射,需要的矩阵
- 把[V,V]的矩阵进行低秩分解成两个W
- 最终得到公式
- RNN Head:
- markov轻量,但是只能看到前面一个token,是memoryless的
- RNN通过维护一个recurrent state来relax这种限制
- 每次更新的输入是把这几个叠起来
- 旧的recurrent state
- hidden state
- 前一个token embedding 乘一个W
- 公式:
- 更新的公式:
- 最终得到bias:
Confidence-Scheduled Verification
spec的verify的特征是,遇到错误的token就丢弃后面所有的;这也代表着一味地增加draft生成的长度,可能不能带来更多的收益,同时花费了更多verify的开销,导致整个serving的througput的下降,尤其是高并发的场景下
Confident Head
Hardware-Aware Prefix Scheduler
Thinking
增加串行特征的方法确实能提升接受率,可能还有更多添加串行的方法(比如DFlash2里的selector),也可能在不同的逻辑位置去增加这个casual的信息
可变draft长度确实是对的,不同的anchor之后的句子难度是不一样的,对于简单的语句可以预测的长一点(正如同简单的token可以少经历几层layer一样)