文章
DFlash2学习
本文目录 5
Intro
在七月初DSpark在DFlash的基础上增加了一个串行头提升了接受率之后,DFlash在八月初也发了对DFlash的改进
主要的变化是,在diffusion输出hidden、LM head处理成logits之后,对这些位置的topk选出来的candidate做一个selector来增加因果关系;以及在diffusion的结构中加入了一个卷积
Selector
DFlash是对每个位置的candidate直接选取top1,这样选出来是没有因果的联系,是独立的,接受率从pos0的85%到pos6的73%在逐渐下降 ;DFlash2认为像DSpark那样再加一个串行的头去“修正”的策略是不必要的
因为根据数据,对于每个位置,如果从top1扩展到top16,那么正确答案存在于这16个token中的概率能获得接近15%的提升
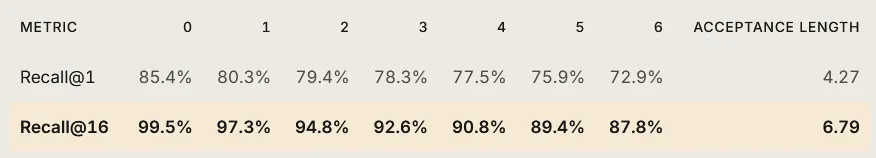
因此,DFlash2对所有位置的16个top candidate会做一个选择;但是的最优路径的选取空间太大了
所以这里的selector的策略还是一个对neighbor token的贪心策略,
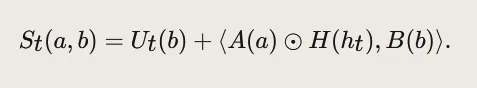
对前面的a和后面的b打分,最终形成一个的分数矩阵
Cov
从DFlash的注意力的情况里,可以看到从第一层往后,这些draft token之间互相的注意力的比重在下降;而且最终的注意力的权重会集中到几个头里;这就是文章里说的suffix decay后缀衰减
也就是说attention本来的两个任务:阅读block外面的context,阅读block内部的依赖;随着layer的深入,第二个任务被稀释
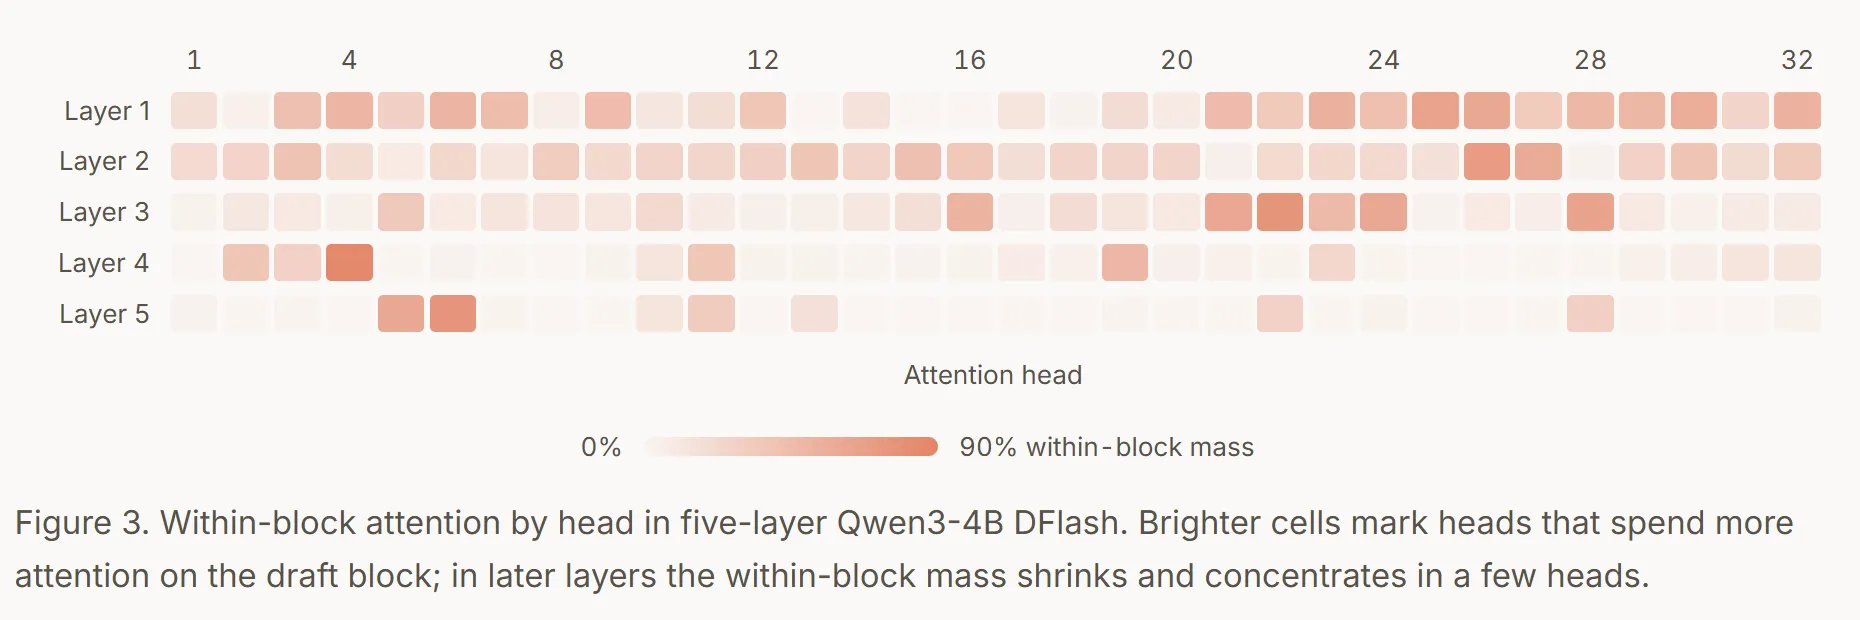
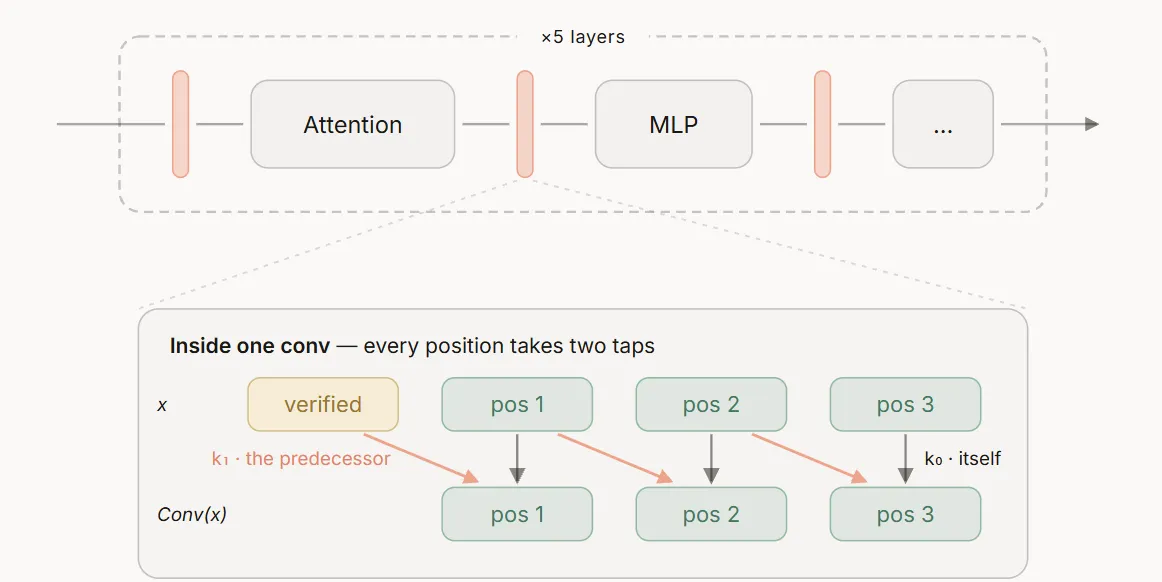
所以用一个cov来加强block内neighbor的注意力:
.png)
这里的逐元素去乘的权重是可学习的,是一个小的mlp
最终得到的workflow长这样
Idea
一些想法:关于DFlash2和DSpark的工作,尤其是为了提升接受率而添加casual性的操作,都是在LM head处理之后进行的;
如果是在LM head之前,在更为dense的hidden空间里做,会不会效果geng h