文章
DFlash
本文目录 9
本篇blog用于记录有关DFlash有关的内容
背景
1. diffusion LLM
扩散模型本来是图片生成方面的算法,通过在一次forward的不同轮次中不断向图片中加入噪声,直到达到高斯噪声,又在reverse的不同轮次中训练还原这些噪点,最终获取一个图像的能力
将这种方法应用到 LLM 上,就能获得一个和现有 auto regressive不同思路的生成方式,通过一轮一轮的扩散生成文本
有关dLLM的部分后面可能有空会完善一下以前的博客
2. Speculative Decoding
投机解码,用轻量的draft model去生成candidate tokens,然后用target model去验证,是实现无损加速的优雅的表达
在这之前的一些代表性的工作有用多头并行生成的Medusa以及自回归的天花板EAGLE,可以看看我往期的博客
3. Discussion
medusa作为一个并行的模型,他的limit在于除了第一个draft,后续的draft缺乏上文,所以接受率会比较有限
之后推出的eagle使用自回归,将预测的token和hidden扔进了小的draft model里,实现了接受率的提高,可以说eagle已经达到了自回归方法的天花板
为什么这么说?
在一个自回归的Speculative Decoding中,加速比和接受率是成正比的,,其中 ,那么
想要提升这个加速比,就需要减小单步生成的时间或者增加期望接收到的draft的长度;然而这两者通常是制约的,这也就是限制自回归方法的根本原因
那么如果想要更快地生成草稿,DFlash就借鉴了dLLM的生成方法,既是并行的(一次forward得到所有结果),生成的draft之间又不是逻辑上独立的
Block diffusion
DFlash最重要的一个部分就是它的draft model,也就是block diffusion的部分
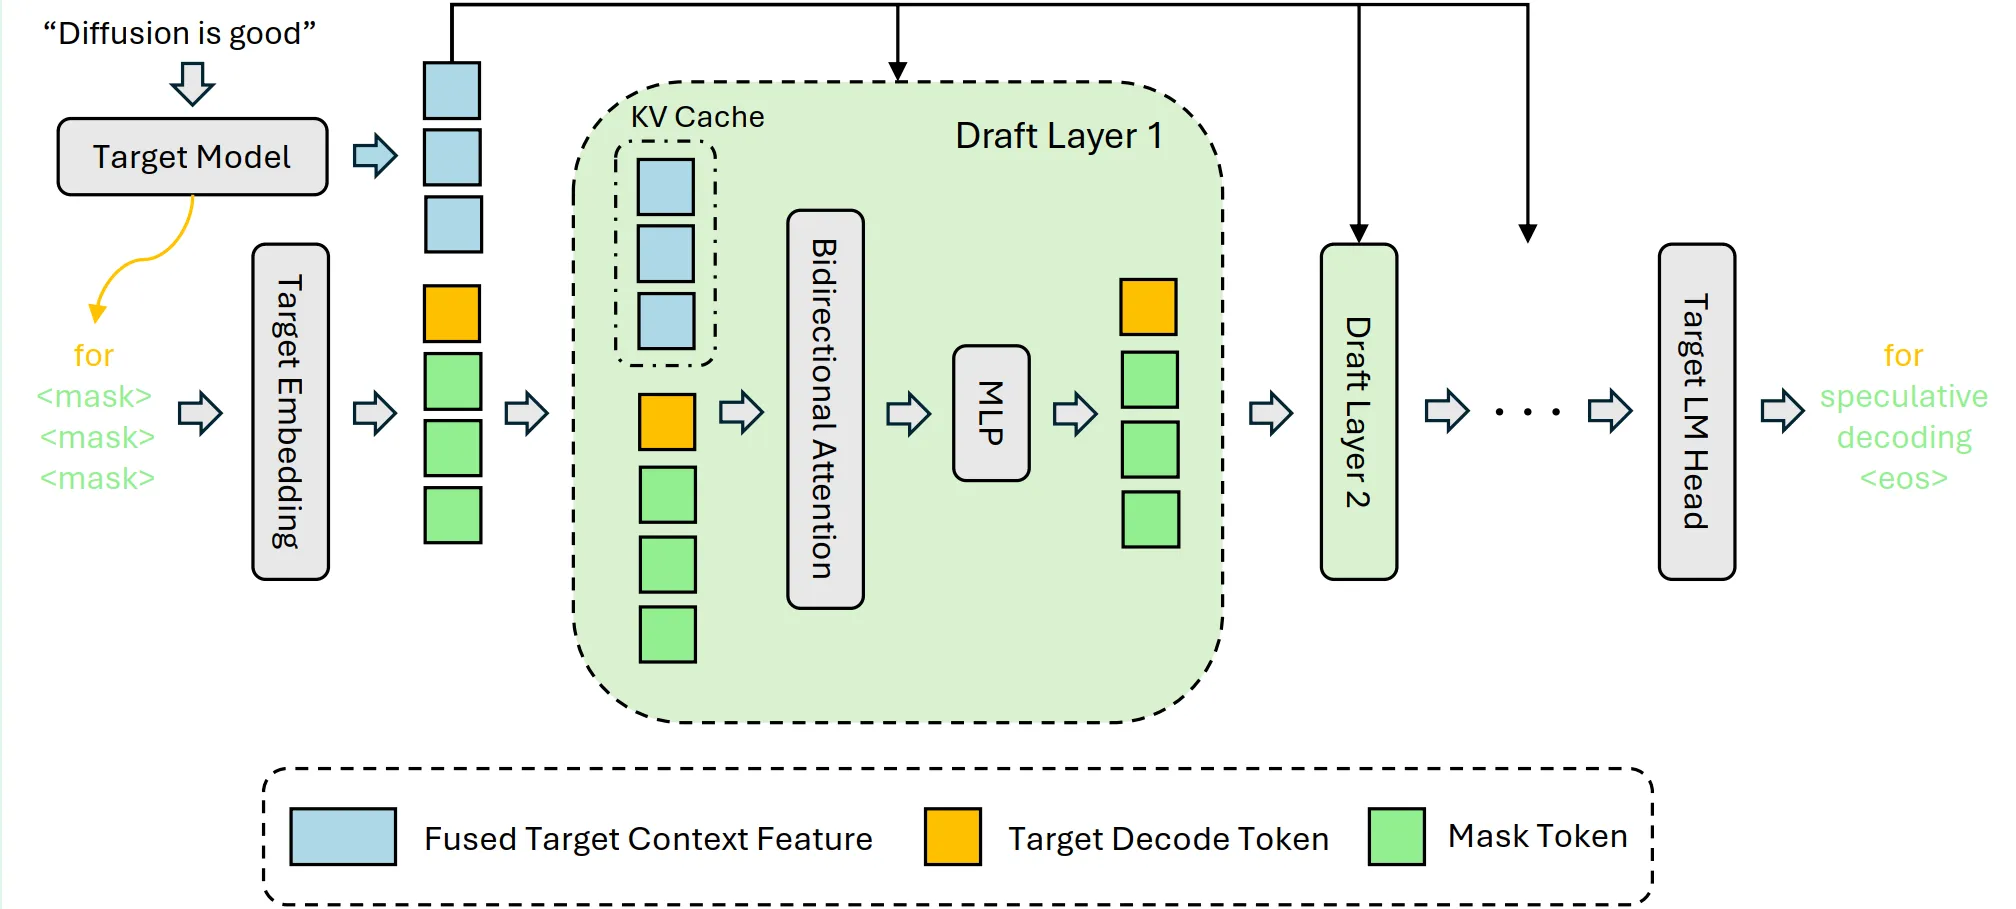
从图中可以看到,这里除了使用diffusion的方法,给固定数量的mask然后去unmask之外,最重要的一点就是这里的KV cache注入
KV injection
和普通的投机解码一样,在对target model对序列进行prefill的时候,draft model也会同时进行一次prefill来积攒cache
但是draft和target model的qkv矩阵是不一样的,所以他们不能共享kv cache;两个model分别保有各自的cache
为了让蕴含更多信息的target model的kv能被分享给小模型,DFlash把大模型的hidden抽了几层并用一个ffn压缩到和draft model的hidden相同的维度,并用draft的kv矩阵乘上去,放到draft自己的kv cache的前面,作为一个参考
这样做会带来一定的计算并追加cache的overhead,后续计算attn的时候也会带来一点开销,但是的计算、的投影以及其后续的ffn这些都没有影响,它带来的接受率的benefit要overweigh这些overhead
Training
Random sampling of masked blocks
标准的Block Diffusion training里是把 response 均匀切成 block,然后在 block 内随机 mask 一些位置,让模型做 denoising
但是他和针对spec decoding的小模型不是很匹配,因为其在一个block内部的mask是随机分布的;而spec decoding面临的情况是它会有target提供的前缀,去生成相对短一点的一段seq,在“clean token”之后的token应该是被连续mask的
所以下面是它的设计:
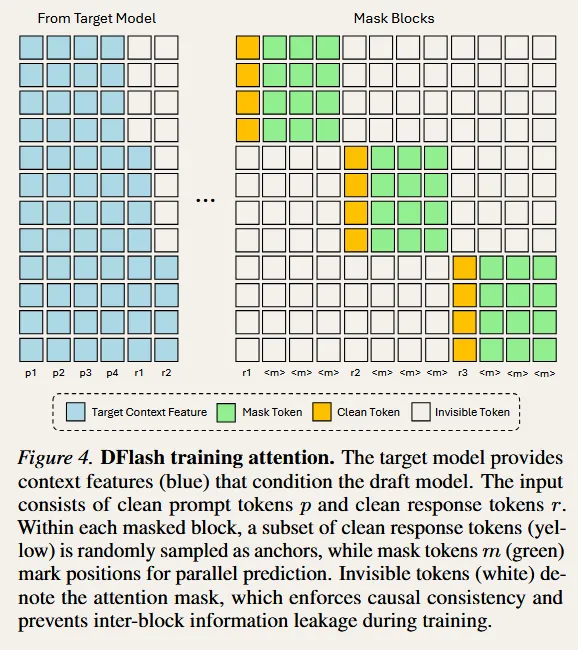
上图可以理解成一个attention score的矩阵,纵轴对应的是q,横轴对应的是k;
蓝色block是target model生成的feature,黄色的是clean token;因为推理的过程中小模型用的输入就是前面大模型的hidden去进行一个kv inject;同时用前面target model做verify得到的bonus token作为一个anchor token,后面加上token mask去做diffusion的去噪
所以它这里的q是只含有draft model生成的部分,k则是有target加上draft;同时用一些mask去把不属于自己的block内部的token去mask掉
limitation
看起来 DFlash 用diffusion实现了更好的加速方式,然而在长文本的场景下,他要进行去噪步数次的N长度的读取,memory bound会导致其加速比大幅下降,甚至不如vanilla
同时它显存占用也会变得很大,并发场景的表现也没有特别好
为此对于draft model的sparse attn的研发,甚至是不带cache的draft,在长文本下可能有比较大的潜力