文章
deepseek-v4.1-技术报告学习
本文目录 10
Intro
之前v4-pro出来效果不怎么好,ds又上调api价格的时候,就给了我一种在驱逐用户回收算力做训练的感觉
本来以为是要去给v4重新做一下后训练再发布,没想到直接端出来一个v4.1-flash,而且甚至启动的是一套新架构,完全可以说是v5-flash了
在当下agent越来越流行的情况下,long-horizon的session越来越多,要求模型需要具备更长的上下文。于此同时,长文本在prefill阶段对计算施加了很大的压力;而decode阶段对cache的需求给存储带来了很大的压力
一个好的“系统“优化的问题就是在不断的去scaling,除了提升引擎就是优化模型的结构和dataflow,所以这里的keywords也就是:
- less compute when prefilling
- less cache when decoding
- prefill和decode的非对称激活
Relevant Works
YOCO
You Only Cache Once
传统的transformer blocks是每层都有自己的来把hidden转换成矩阵,每一层的QKV都是等上一个layer输出hidden之后,再乘W矩阵得到的
这里则是有一些的layer直接复用前面某层的KV,所以需要cache的数量也减少了
IndexCache
对于一个sparse attention,相邻的layer对同一个token的query想要选取的kv indices是有高度相似的,因此某一层的layer选取的kv indice可以复用前面某层的的,避免lightning indexer的重复计算
有实验显示lightning indexer的开销甚至和sparse attention的开销差不多甚至更多,毕竟它是一个相当于全量的小的attention
模型架构
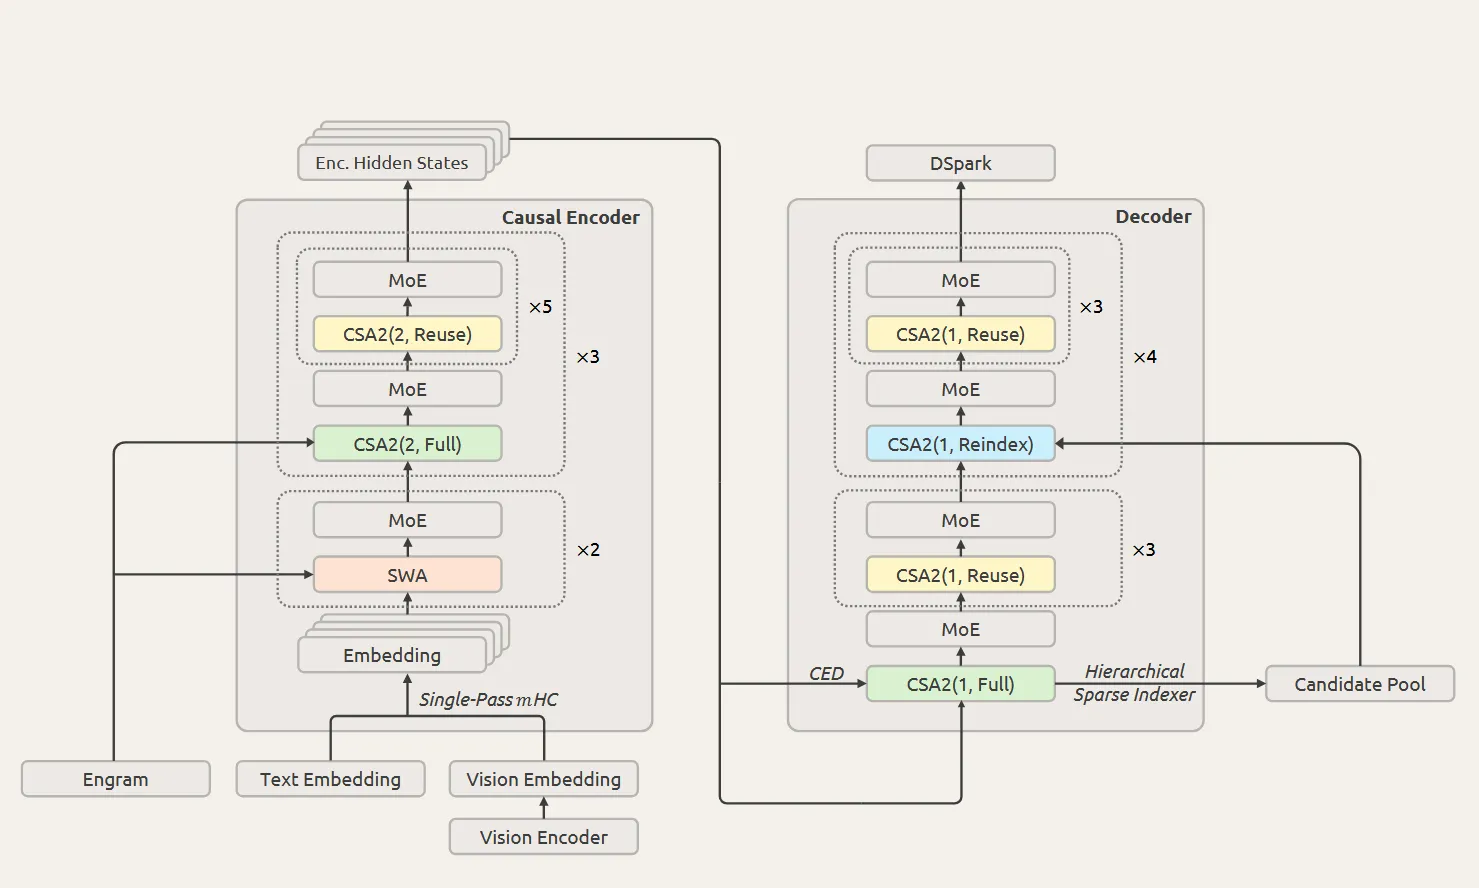
这里的transformer layer被分成了两类:encoder和decoder,各自20层
CED, Casual Encoder-Decoder
把这些layer区分成两类,就是因为借鉴了YOCO的思想,后半段的所有的decoder使用的都是一个global kv,而它就是前半段encoder最终的输出
所以prefill阶段只需要跑encoder,把encoder每一层的kv和最终产生的hidden对应的global kv给缓存住就行;decode阶段的encoder部分就使用自己的kv,decoder阶段使用global kv
这里有关kv复用大概的意思是对的,下面解释注意力的时候有更详细的
最终产生的效果就是不对称的计算
CSA2
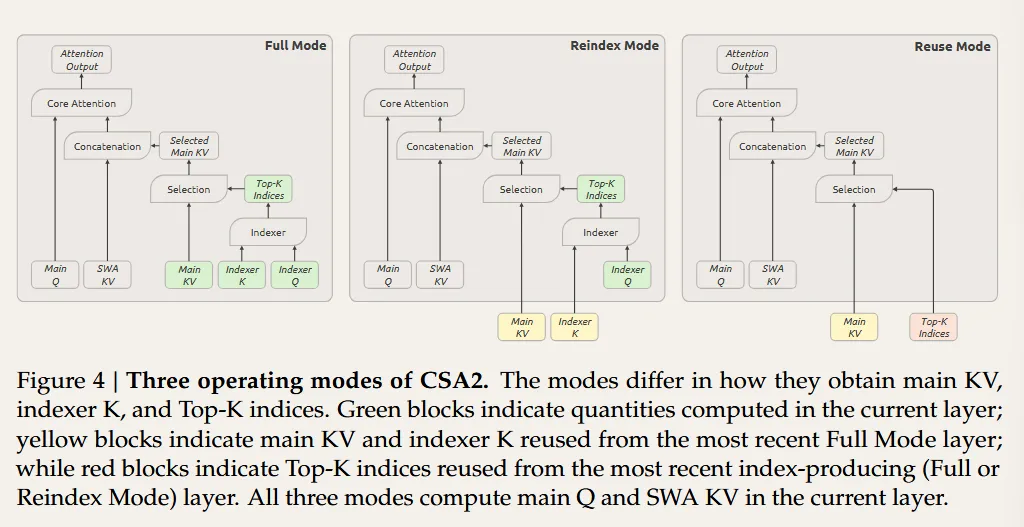
CSA2的复用结构类以一个多级cache,Full Mode是复用范围最大的Anchor,生产出来的数据可以供后面的树用Reindex复用范围小一点,Reuse是最小的单位
三种mode
Full Mode
之前的v4的CSA+SWA的流程就是
历史 token
   │
   ├─→ 压缩后的 global KV
   │       ↓
   │    indexer
   │       ↓
   │    Top-K sparse attention
   │
   └─→ 最近 128 token
           ↓
          SWA
两版的CSA的区别有:
- CSA2这里encoder的压缩比例是2,decoder的压缩比例是1也就是不压缩
- CSA2首先把原本的CSA的压缩的overlap和绝对位置编码去掉了
- CSA2的indexer K是从main KV投影出来的,替代原本CSA从hidden做一次运算
Reindex Mode
复用前面Full Mode生产出来的index K和main KV
Reuse Mode
复用前一个Reindex Mode选取的index,以及前一个Full Mode的index K和main KV
最终比例
Layer 0,1 : Window-only
Encoder(2~19) Full : 2, 8, 14 Reuse : 3-7, 9-13, 15-19
Decoder(20~39) Full : 20 Reindex : 24, 28, 32, 36 Reuse : 21-23, 25-27, 29-31, 33-35, 37-39
hierarchical sparse indexer
虽然已经使用了sparse attention,但是在面对更长的上下文的时候,去给所有的历史打一次分的开销还是很大,甚至比做真正的attention的开销还大
所以可以采用分级的思想来打分
所有 main KV entries
        ↓
先按连续位置分成 block
        ↓
先给所有的位置打分,再给每个 block 选一个分数(块内的最高分)
        ↓
选 Top blocks
        ↓
这些 block 展开成 candidate pool
        ↓
后续 Reindex 层只在这个 candidate pool 里再选 Top-K
这一步看起来是没有减少计算量的,甚至是增加了计算量的;但是后续的Reindex Mode里就直接复用这些已经选出来的block,而不会重新对全局的kv做打分选取了
这复用的真狠啊
encoder是每6层重算一个kv和indice;decoder直接全用前面的KV和indice Q,然后每5层复用一下index
Single-Pass mHC
mHC这里的变动就是把他变成了一个single-pass的运算过程
原版的公式是这样的,
而这个其实是对有依赖的,所以在进入layer之前需要先等待A_i的计算;
而这里改为了,A_i变成由上一层产生的了,因此这个依赖就被消除了,变成不用等待的single-pass的过程了
那为啥要消除这个依赖呢?在理想(没有依赖的)情况下,我们拿到的是上一层的输入的梯度和layer的输出;如果做单次的kernel运算就能得到这一层需要的,那么只用次的读和写就可以完成,也就是总计次的运算:
HBM 读
X_{l-1}, Y_{l-1}
      ↓
同一个 GPU kernel 内部
   算各种 mixing
   算 X_l
   算 A_l
   算 X̂_l
      ↓
HBM 写
X_l, X̂_l
而如果存在依赖,这个就不能通过单次的kernel运算,而是需要多次的运算,三个 kernel:
-
residual update:
-
coefficient prediction:
-
input mixing:
这个过程经过了次的读写,是理论下界的两倍
TODO
主要的模型的变化就这些,其他待拓展
Reference
-
zartbot的公众号/blog非常的up-to-date