文章
deepseek-v4
本文目录 7
ds v4 is coming!
目前看他们的技术报告的话主要新增的特性就是
- hybrid attention:用了
CSA和一个低秩投影之后的dense attnHCA - mHC (Manifold-Constrained Hyper-Connections):
- Muon Optimizer
包括从V3中继承的 MoE,MTP等等
1. hybrid attn
CSA
在没看之前,我以为ds会沿用之前的DSA,再混合一个线性注意力或者比较dense的小注意力;然而这次却使用了一种新的注意力
新的变体的Attention想要解决的问题基本上都是拥有更长的上下文带来的显存里存的cache过大的问题。DSA(或者说从MLA开始)已经大大缓解cache的压力,将其从变成了(感兴趣的朋友可以看我的另外其他的blog),新的CSA做的,反而是从压缩这里出发
Compressed Sparse Attention,就是做一个compress+sparse;也就是说直觉来说直接把几个kv压缩成一个,同时在计算attn的时候再去用sparse选idx
原始 tokens
t1 t2 t3 t4 | t5 t6 t7 t8 | ...

       ↓ 4:1 compression

    C1      |      C2      | ...

       ↓

Lightning Indexer
找出当前 query 最相关的 Top-K compressed entries

       ↓

Sparse Attention
v4 的参数里的典型的压缩率是4,也就是在1M的上下文中,1M/4 = 250K,在这个里面再进行top-K的选取
HCA
Heavily Compressed Attention,从名字上就能看出,如果把压缩比提升的足够大,例如128,那么百万的上下文被压缩之后,也不过只有8k左右的键值对,这是完全可以接受的范围,对他可以直接做一个dense的attention计算
SWA
Sliding Window Attention,滑动窗口注意力,一般是只保留最近的T个token的注意力
这里之所以把他单独拿出来,是因为v4的SWA不是把窗口以前的信息全部忘掉,而是为窗口内的部分提供额外的一条信息
它实际上是两条线路:
                        query q_t
                           │
             ┌─────────────┴─────────────┐
             │                           │
             ▼                           ▼
     Sliding Window                Compressed History
      recent raw KV                 old compressed KV
        128 tokens                 CSA / HCA
             │                           │
             └─────────────┬─────────────┘
                           ▼
                       Attention
也就是首先有一路是用的compressed KV,而窗口内部则是完整的raw KV,最后在把这两个按照sequence的顺序塞到attention block里去计算
所以最后真正的输入就是:
- CSA:top-k sparse CSA kv + 128 raw kv
- HCA:heavily compressed dense kv + 128 kv
因此,这几部分的kv cache是要分开来维护的
窗口内的 raw kv和注意力kv的cache的差别有很多,包括粒度大小、命中语义、恢复方式等等,但是最显著的差异应该还是生命周期
注意力的kv cache是拥有和这条message一样的生命周期的(这里不考虑eviction之类的),而SWA对应的raw kv cache则是拥有更短的生命周期,在decode推进的时候会逐渐过时
所以其实对于一个serving来说,只有compressed kv才比价有reuse的价值;而当request命中之后,也需要再做一段的“状态“恢复
2. mHC
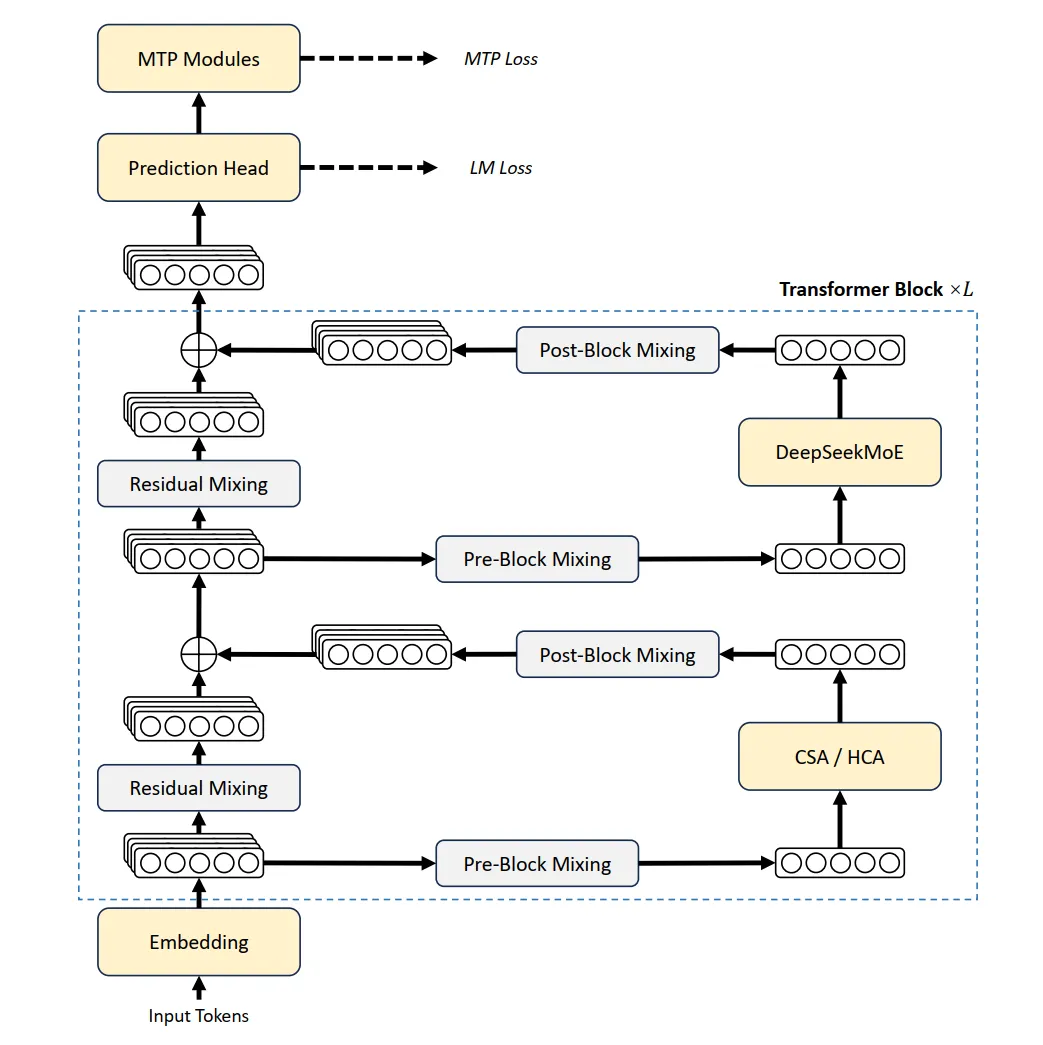
引入HC
传统的残差连接的形式大概是,由于每次的残差都有一个identity mapping也就是恒等映射,所以它随着模型层数的加深,是拥有一个很好的稳定性的;但是与稳定性相伴的,就是他的性能潜力是相对有限的,数据在一条路上跑,可能会被困在一个局部的极值点
那如果把这一条路扩展成多条路呢?因此出现了Hyper-Connection超连接
Naive HC, Hyper-Connections(超连接) 可以先把它理解成:把普通 Transformer 的单条 residual stream 扩展成多条 persistent residual streams(持续存在的残差流),然后允许每一层自由决定“从哪几条流读、往哪几条流写、各条流之间怎么混”
普通 residual 的形式是,只有一条 residual stream
Naive HC 把它扩展成
例如 的情况
它的基本形式可以写成:
这里可以分成三个部分,
负责 4→1 read mixing(读取混合):
把多条 residual stream 混成一个普通 -维 hidden state,送进 Transformer block:
然后 负责 1→4 write mixing(写回混合)
把 block 的输出重新分配给多条 residual streams
与此同时负责 4→4 residual mixing(残差流之间的直接混合)
因此完整 dataflow 大概和原来比起来是长成这样:

Naive HC 的关键,或者说一个可能的不安全的点就在于,这些 mapping 基本是 unconstrained(无约束)的可学习映射
尤其是可以是任意一个 learned matrix,比如:
那么 residual path 跨很多层以后就会形成一层一层的堆叠
这就是和普通 residual 不一样的地方,因为普通 residual 的 direct path ,也就是 identity mapping(恒等映射),无论经历多少层的残差连接都不会有任何的scale的变化,非常稳定
而 naive HC 的 direct path 变成之后则是每一层都在重新 mixing。
所以如果某些 的 spectral norm(谱范数)大于 1,连续相乘后可能:
造成 signal explosion
反过来,如果不断压缩某些方向,也可能:
向量一直被压缩,信息会逐渐消失
这就是 naive HC 最大的问题:它获得了更强的 routing capacity(路由能力),但牺牲了普通 residual 那种天然稳定的 identity highway
mHC和HC的区别
而 **mHC, Manifold-Constrained Hyper-Connections(流形约束超连接)**并没有推翻这个 HC 形式,它仍然是:
区别只是它多了一个m,把 限制到一个稳定的 manifold(流形)上,例如要求它是 doubly stochastic matrix(双随机矩阵):
“流形“就是某个维度的空间里的一个曲面。他在局部可能看起来像普通的欧几里得空间,但是整体可能拥有更为复杂的几何结构