最近在看 DSA 的内容,看看能不能优化一下写个算子啥的(虽然目前CUDA只会最简单的语法,先看算法)
由于涉及到的内容比较多,所以系统的梳理一下相关的笔记,主要包括:
修改于26/5/8:重新读了一些博客并理了一下思路,对于MLA的部分有了新的想法
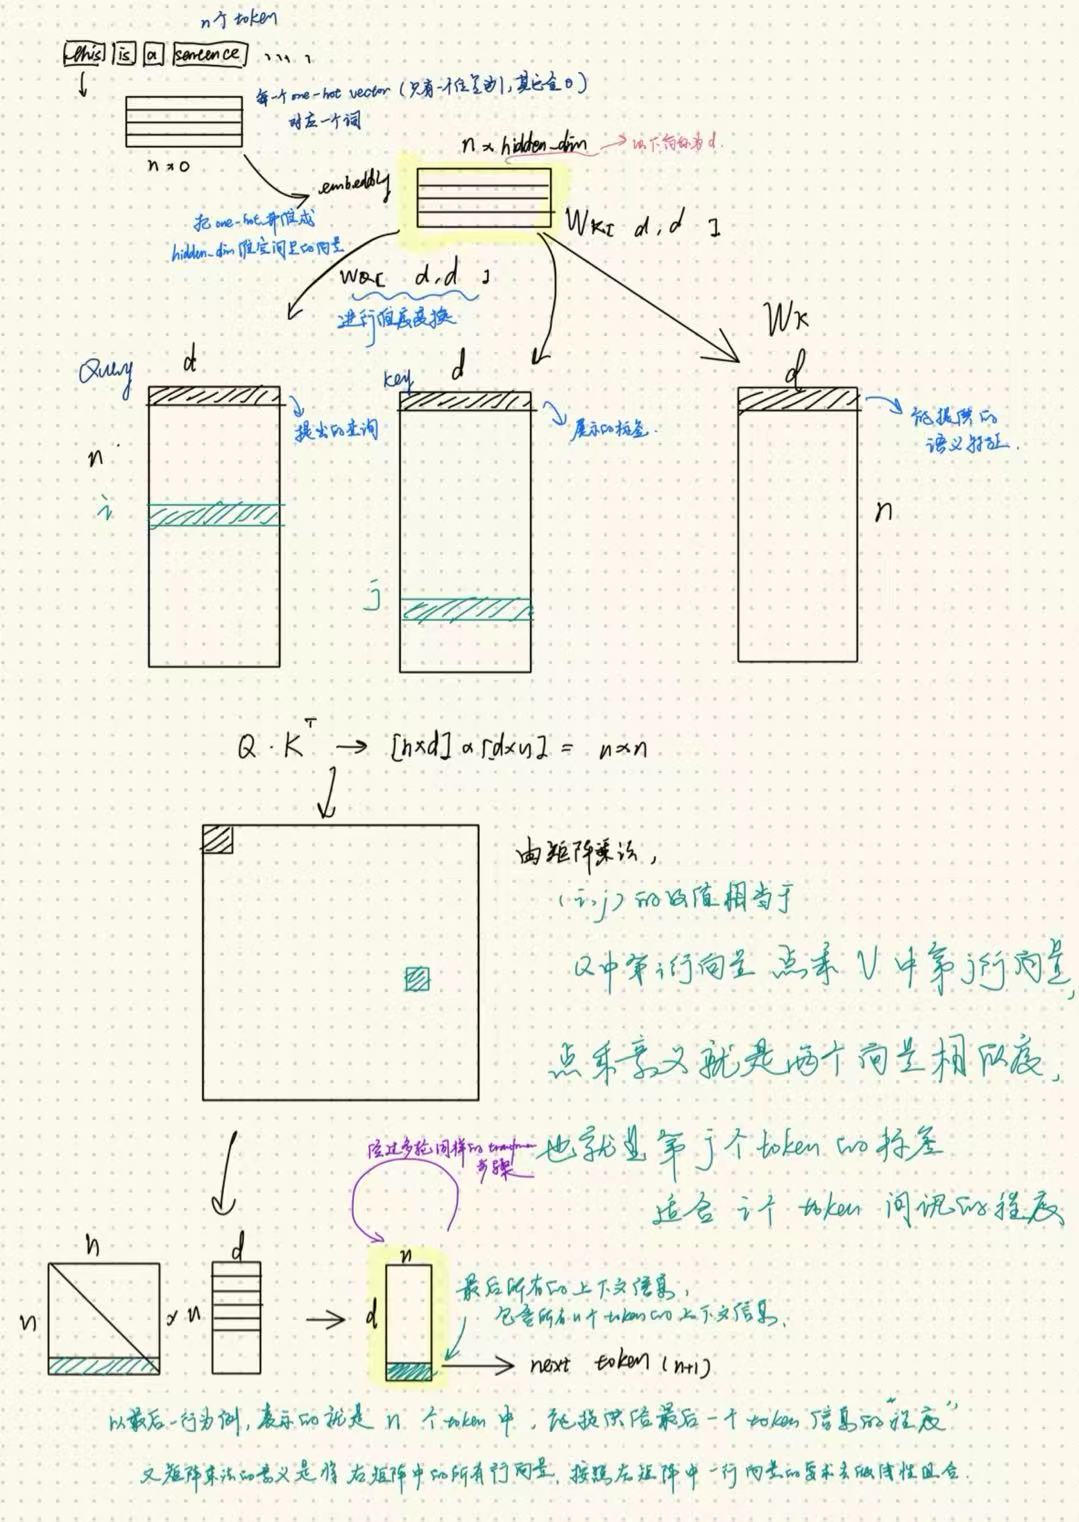
transformer 中最基础的东西,之前给一个朋友讲解的图
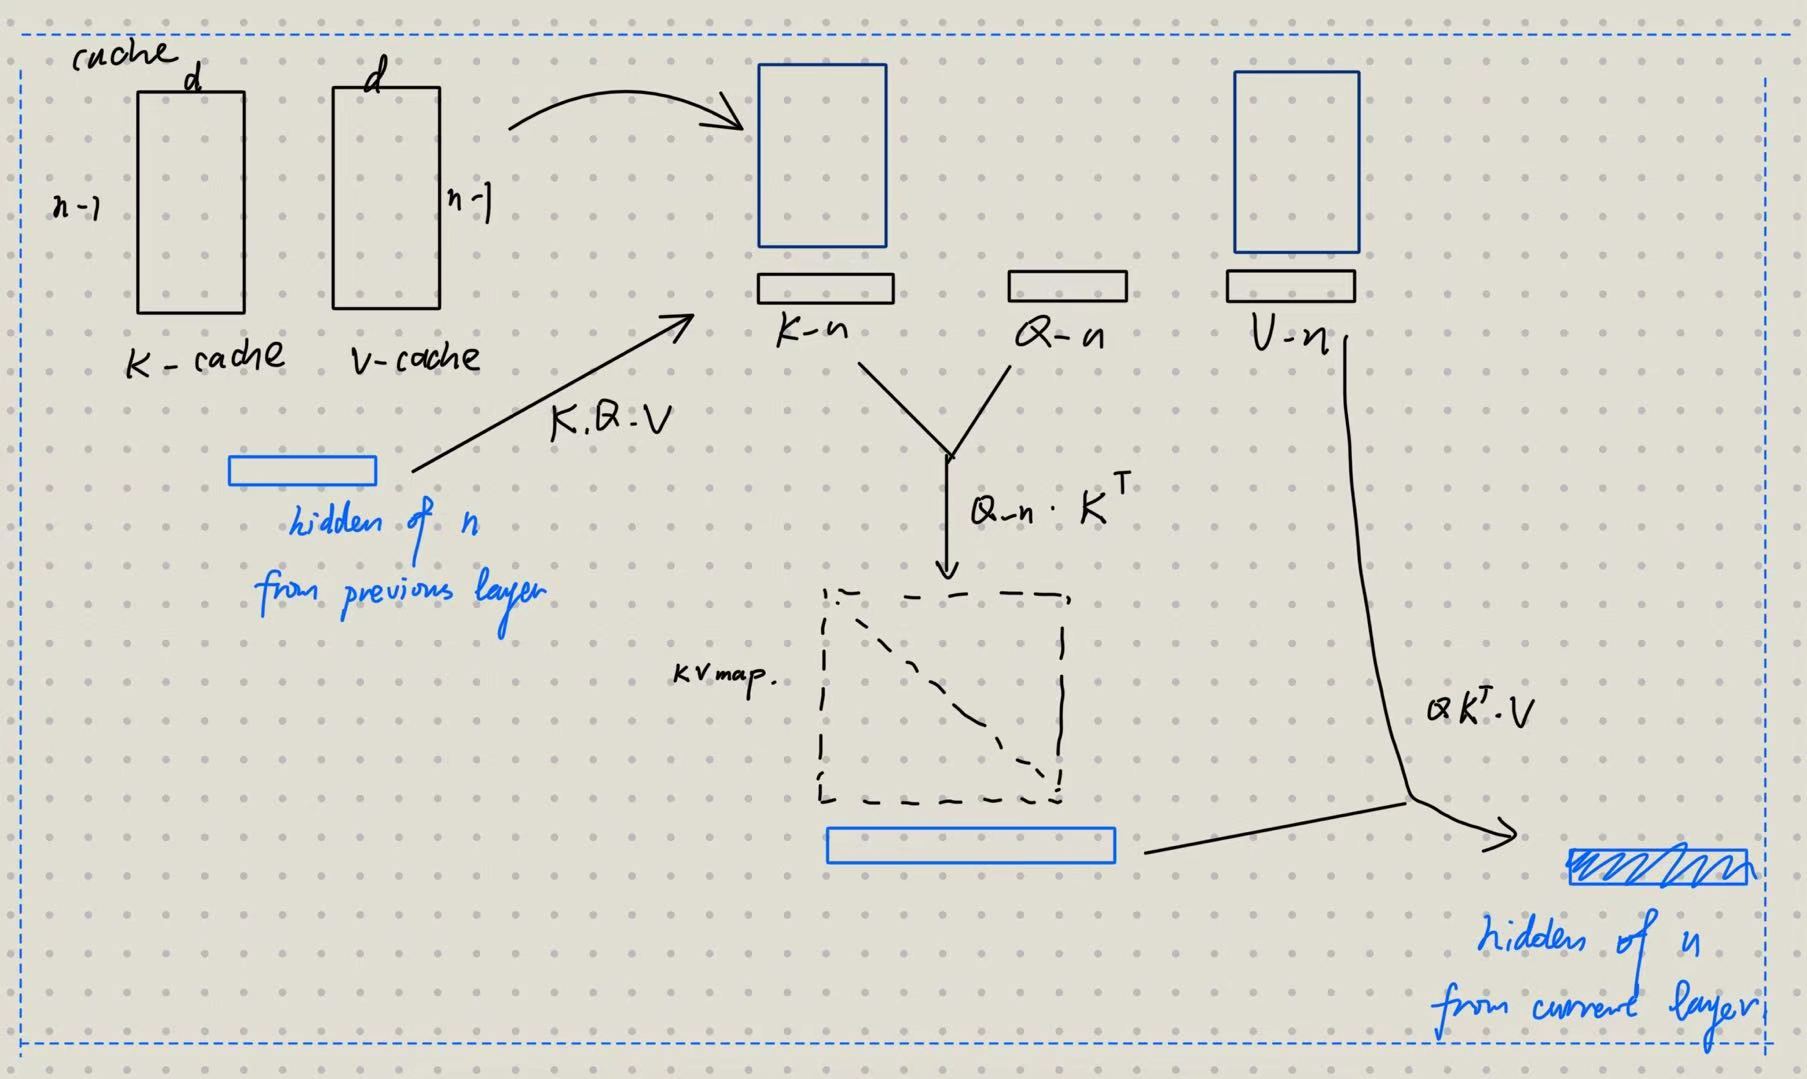
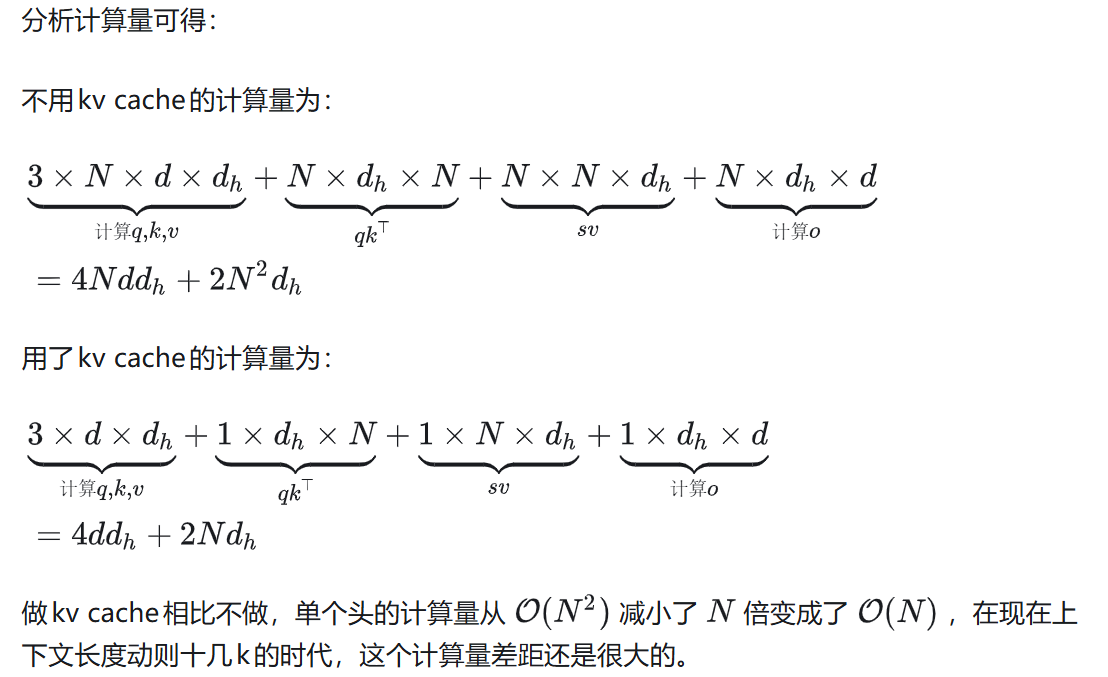
上图是最原始的版本,每一次 layer 的计算都要完整的算出 NxN ,计算量巨大而且有很多重复的KV计算。其实能看到 Q 只需要计算最后一行,KV则是需要进行重复的计算。引入 kvcache之后能将计算复杂度压缩成O(N)
由于所有token对应的kv都是固定的,在"第一次"计算的时候就可以把原始序列对应的kv都缓存下来,此后再更新加入新产生的token对应的kv。可以看到使用cache将之前的token计算出的 kv 缓存下来,可以避免重复计算,同时每次decode的时候只用传递一个x = X [ : − 1 ] x=X[:-1] x = X [ : − 1 ]
这里所说的”第一次“拥有一个名字prefill ,预先填好的;而后面的推理就是decode ,之前 PD 分离的 blog 有空补上
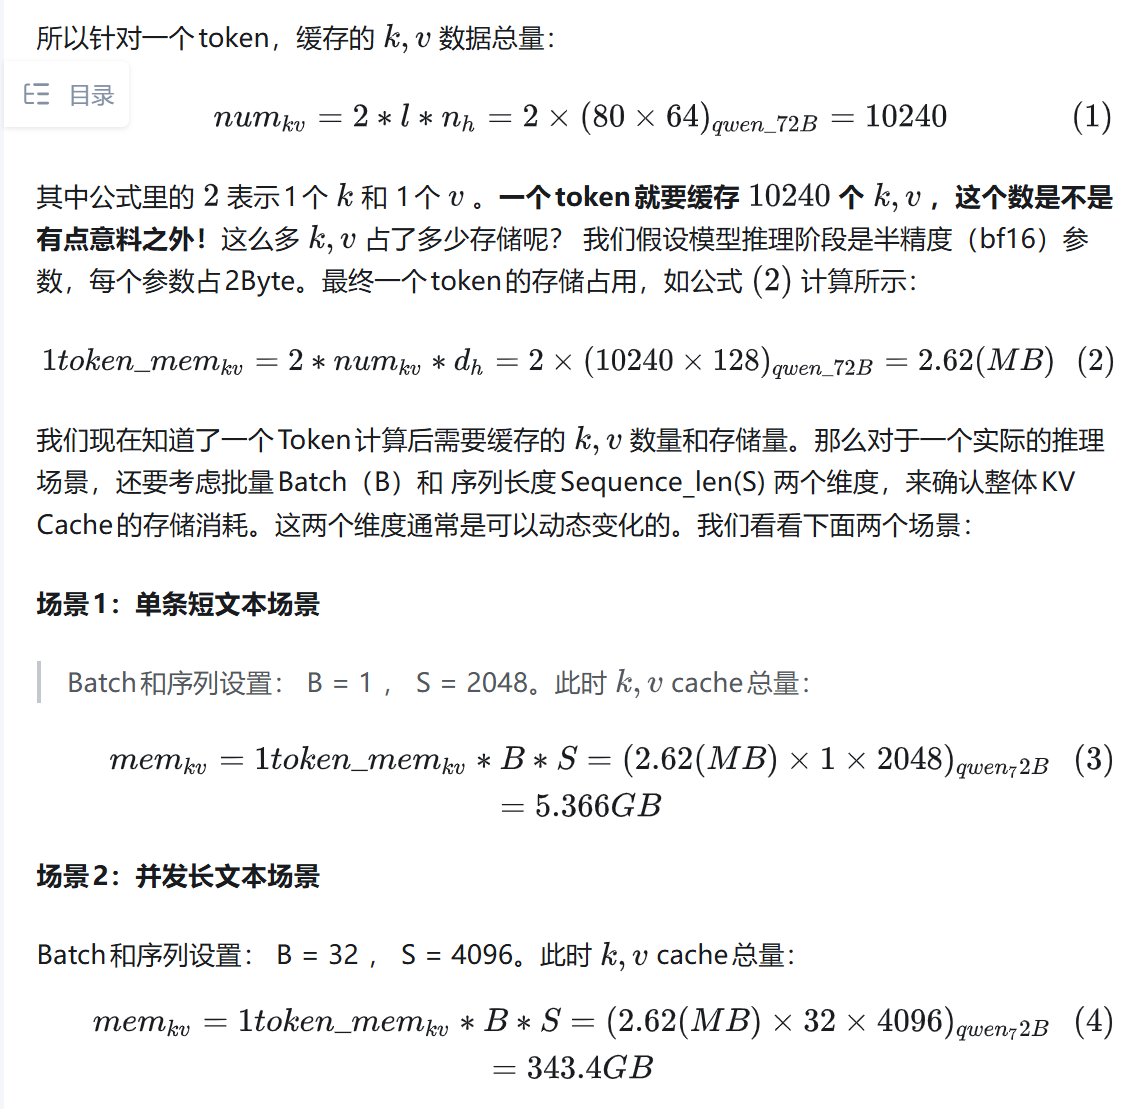
可以看到,这就是一个用空间换时间 的思维,但是这样的 trade-off 似乎有些不平衡,参考知乎博客1 、2 的内容,
参考知乎博客 的内容,对于将 LoRA 应用到 hidden_state有以下的分析
在不考虑rope的情况下 ,其实核心的计算公式就是
o = softmax ( x ⊤ W q ⏟ q R 1 × d h W k ⊤ X ⏟ k ⊤ R d h × N ) X ⊤ W v W o ⏟ v R N × d h o = \operatorname{softmax}\bigg(
\underbrace{x^\top W_q}_{\substack{q \\ \mathbb{R}^{1 \times d_h}}}
\;
\underbrace{W_k^\top X}_{\substack{k^\top \\ \mathbb{R}^{d_h \times N}}}
\bigg)
\underbrace{X^\top W_v W_o}_{\substack{v \\ \mathbb{R}^{N \times d_h}}}
o = s o f t m a x ( q R 1 × d h x ⊤ W q k ⊤ R d h × N W k ⊤ X ) v R N × d h X ⊤ W v W o
其中x = X [ : − 1 ] x=X[:-1] x = X [ : − 1 ] d h d_h d h d d d
而 kv cache之所以需要的存储空间爆大,就是因为它选取了K = W k T X , V = W v T X K=W_{k}^TX,V=W_{v}^TX K = W k T X , V = W v T X
比如我们直接缓存X X X d × N d \times N d × N h c h_c h c K K K d h × N × h c d_h \times N \times h_c d h × N × h c
对矩阵乘法应用一下结合律 得到
每个头计算量: 1 × d × d h ⏟ 计算 q + 1 × d h × d ⏟ q × W ⊤ + 1 × d × N ⏟ q k ⊤ + 1 × N × d ⏟ s v + 1 × d × d h ⏟ W v + 1 × d h × d ⏟ 计算 o = 4 d d h + 2 N d \text{每个头计算量:} \begin{aligned} & \underbrace{1 \times d \times d_h}_{\text{计算}q} + \underbrace{1 \times d_h \times d}_{q \times W^\top} + \underbrace{1 \times d \times N}_{qk^\top} + \underbrace{1 \times N \times d}_{sv} + \underbrace{1 \times d \times d_h}_{W_v} + \underbrace{1 \times d_h \times d}_{\text{计算}o} \\ &= 4 d d_h + 2 N d \end{aligned}
每个头计算量: 计算 q 1 × d × d h + q × W ⊤ 1 × d h × d + q k ⊤ 1 × d × N + s v 1 × N × d + W v 1 × d × d h + 计算 o 1 × d h × d = 4 d d h + 2 N d
KV Cache 推理单步计算量: 1 × d × d h ⏟ 计算 q + 1 × d × d h ⏟ 计算新 k + 1 × d × d h ⏟ 计算新 v + 1 × d h × ( N + 1 ) ⏟ q k ⊤ + 1 × ( N + 1 ) × d h ⏟ s v + 1 × d h × d ⏟ 计算 o = 4 d d h + 2 ( N + 1 ) d h ≈ 4 d d h + 2 N d h \text{KV Cache 推理单步计算量:} \begin{aligned} &\underbrace{1 \times d \times d_h}_{\text{计算}q} +\underbrace{1 \times d \times d_h}_{\text{计算新}k} +\underbrace{1 \times d \times d_h}_{\text{计算新}v} +\underbrace{1 \times d_h \times (N+1)}_{qk^\top} +\underbrace{1 \times (N+1) \times d_h}_{sv} +\underbrace{1 \times d_h \times d}_{\text{计算}o} \\ &= 4dd_h + 2(N+1)d_h \approx 4dd_h + 2Nd_h\end{aligned}
KV Cache 推理单步计算量: 计算 q 1 × d × d h + 计算新 k 1 × d × d h + 计算新 v 1 × d × d h + q k ⊤ 1 × d h × ( N + 1 ) + s v 1 × ( N + 1 ) × d h + 计算 o 1 × d h × d = 4 d d h + 2 ( N + 1 ) d h ≈ 4 d d h + 2 N d h
而在一般的模型里h c h_c h c
把这个想法延伸,如果想要存储更小的cache,可以再对X X X
S m ( x T W D q W U q ⏟ query W k T W U T W D T X ⏟ 向下投影 ⏟ 向上投影 ⏟ key 路径 ) ( X T W D ) ⏟ 向下投影 W U ⏟ 向上投影 W v ⏟ value 路径 W o Sm\left( \underbrace{x^T W_{Dq} W_{Uq}}_{\text{query}} \underbrace{W_k^T \underbrace{W_U^T \underbrace{W_D^T X}_{\text{向下投影}} }_{\text{向上投影}} }_{\text{key 路径}} \right) \underbrace{ \underbrace{\underbrace{(X^T W_D)}_{\text{向下投影}} W_U}_{\text{向上投影}} W_v }_{\text{value 路径}} W_o
S m ⎝ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎛ query x T W D q W U q key 路径 W k T 向上投影 W U T 向下投影 W D T X ⎠ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎞ value 路径 向上投影 向下投影 ( X T W D ) W U W v W o
这种想法是简单直观美丽的,但是当面对rope的时候就会出现问题,因为latent和rope是不兼容的 。如果要加入rope,把这个低秩的cache还原到KV是不可避免的,因为ropes是在完整 Q/K 之后增加的位置信息,在普通的kvcache里是已经被存入 K cache 中了
q t k i T = ( x i W D q W U q R i ) ( X j W D ⏟ c i W U W k R j ) T = x t ( W q ′ R i R j T W k ′ T ) c i q_t k_i^T = (x_i W_{Dq} W_{Uq} R_i)(\underbrace{X_j W_D}_{c_i} W_U W_k R_j)^T=x_t (W_q' R_i R_j^T W_k'^T) c_i
q t k i T = ( x i W D q W U q R i ) ( c i X j W D W U W k R j ) T = x t ( W q ′ R i R j T W k ′ T ) c i
上式在尝试在低秩压缩中引入rope的时候,出现了一个致命的问题:对于第t t t i i i 实时计算 R t − i R_{t-i} R t − i W q ′ ( R i R j T ) W k ′ T W_q' (R_i R_j^T) W_k'^T W q ′ ( R i R j T ) W k ′ T
也就是说引入rope之后要么得把 latent直接还原到 K,再整体做一个rope,但是这样还原就没有节省到 cache;
要么得在线计算R t − i R_{t-i} R t − i O ( N 2 ) O(N^2) O ( N 2 )
所以最核心的问题就是如何结合latent 和 rope ,或者说怎么离线计算x i x_i x i c i c_i c i
那么MLA是怎么解决这个问题的?
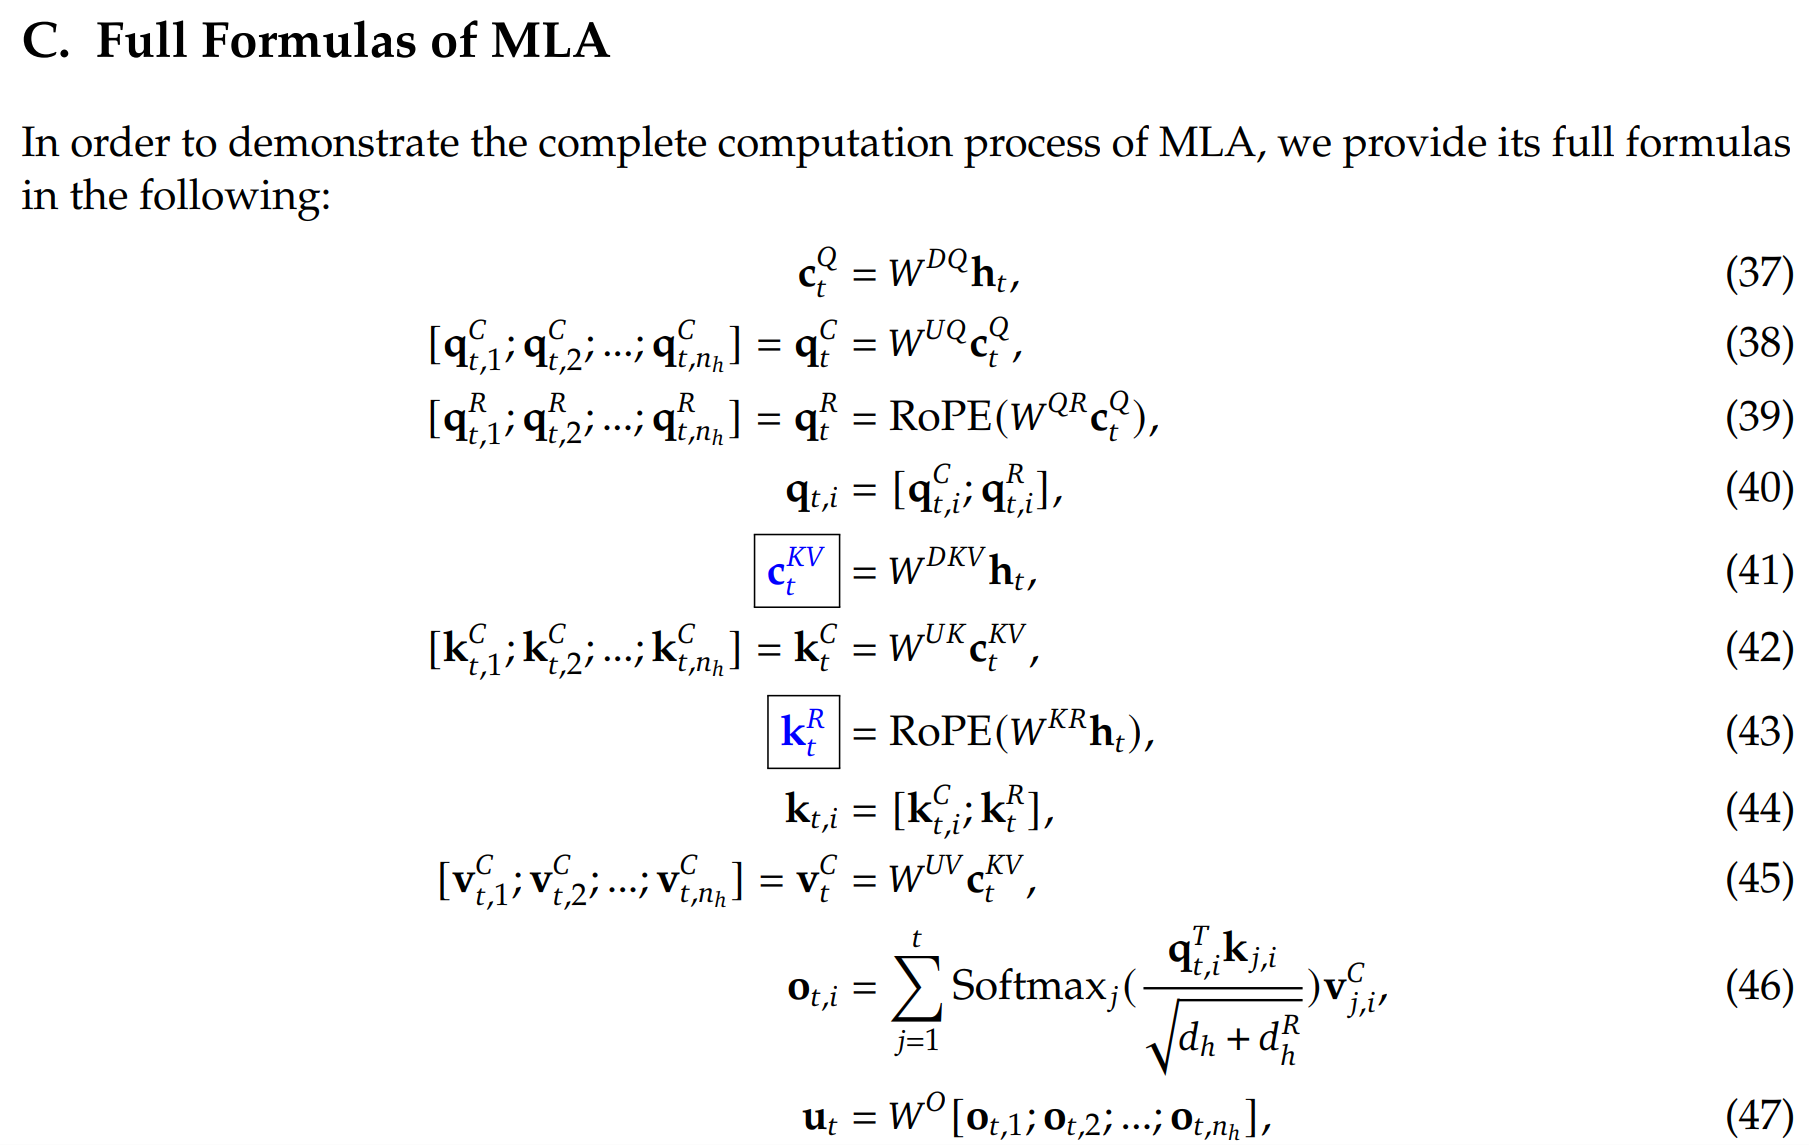
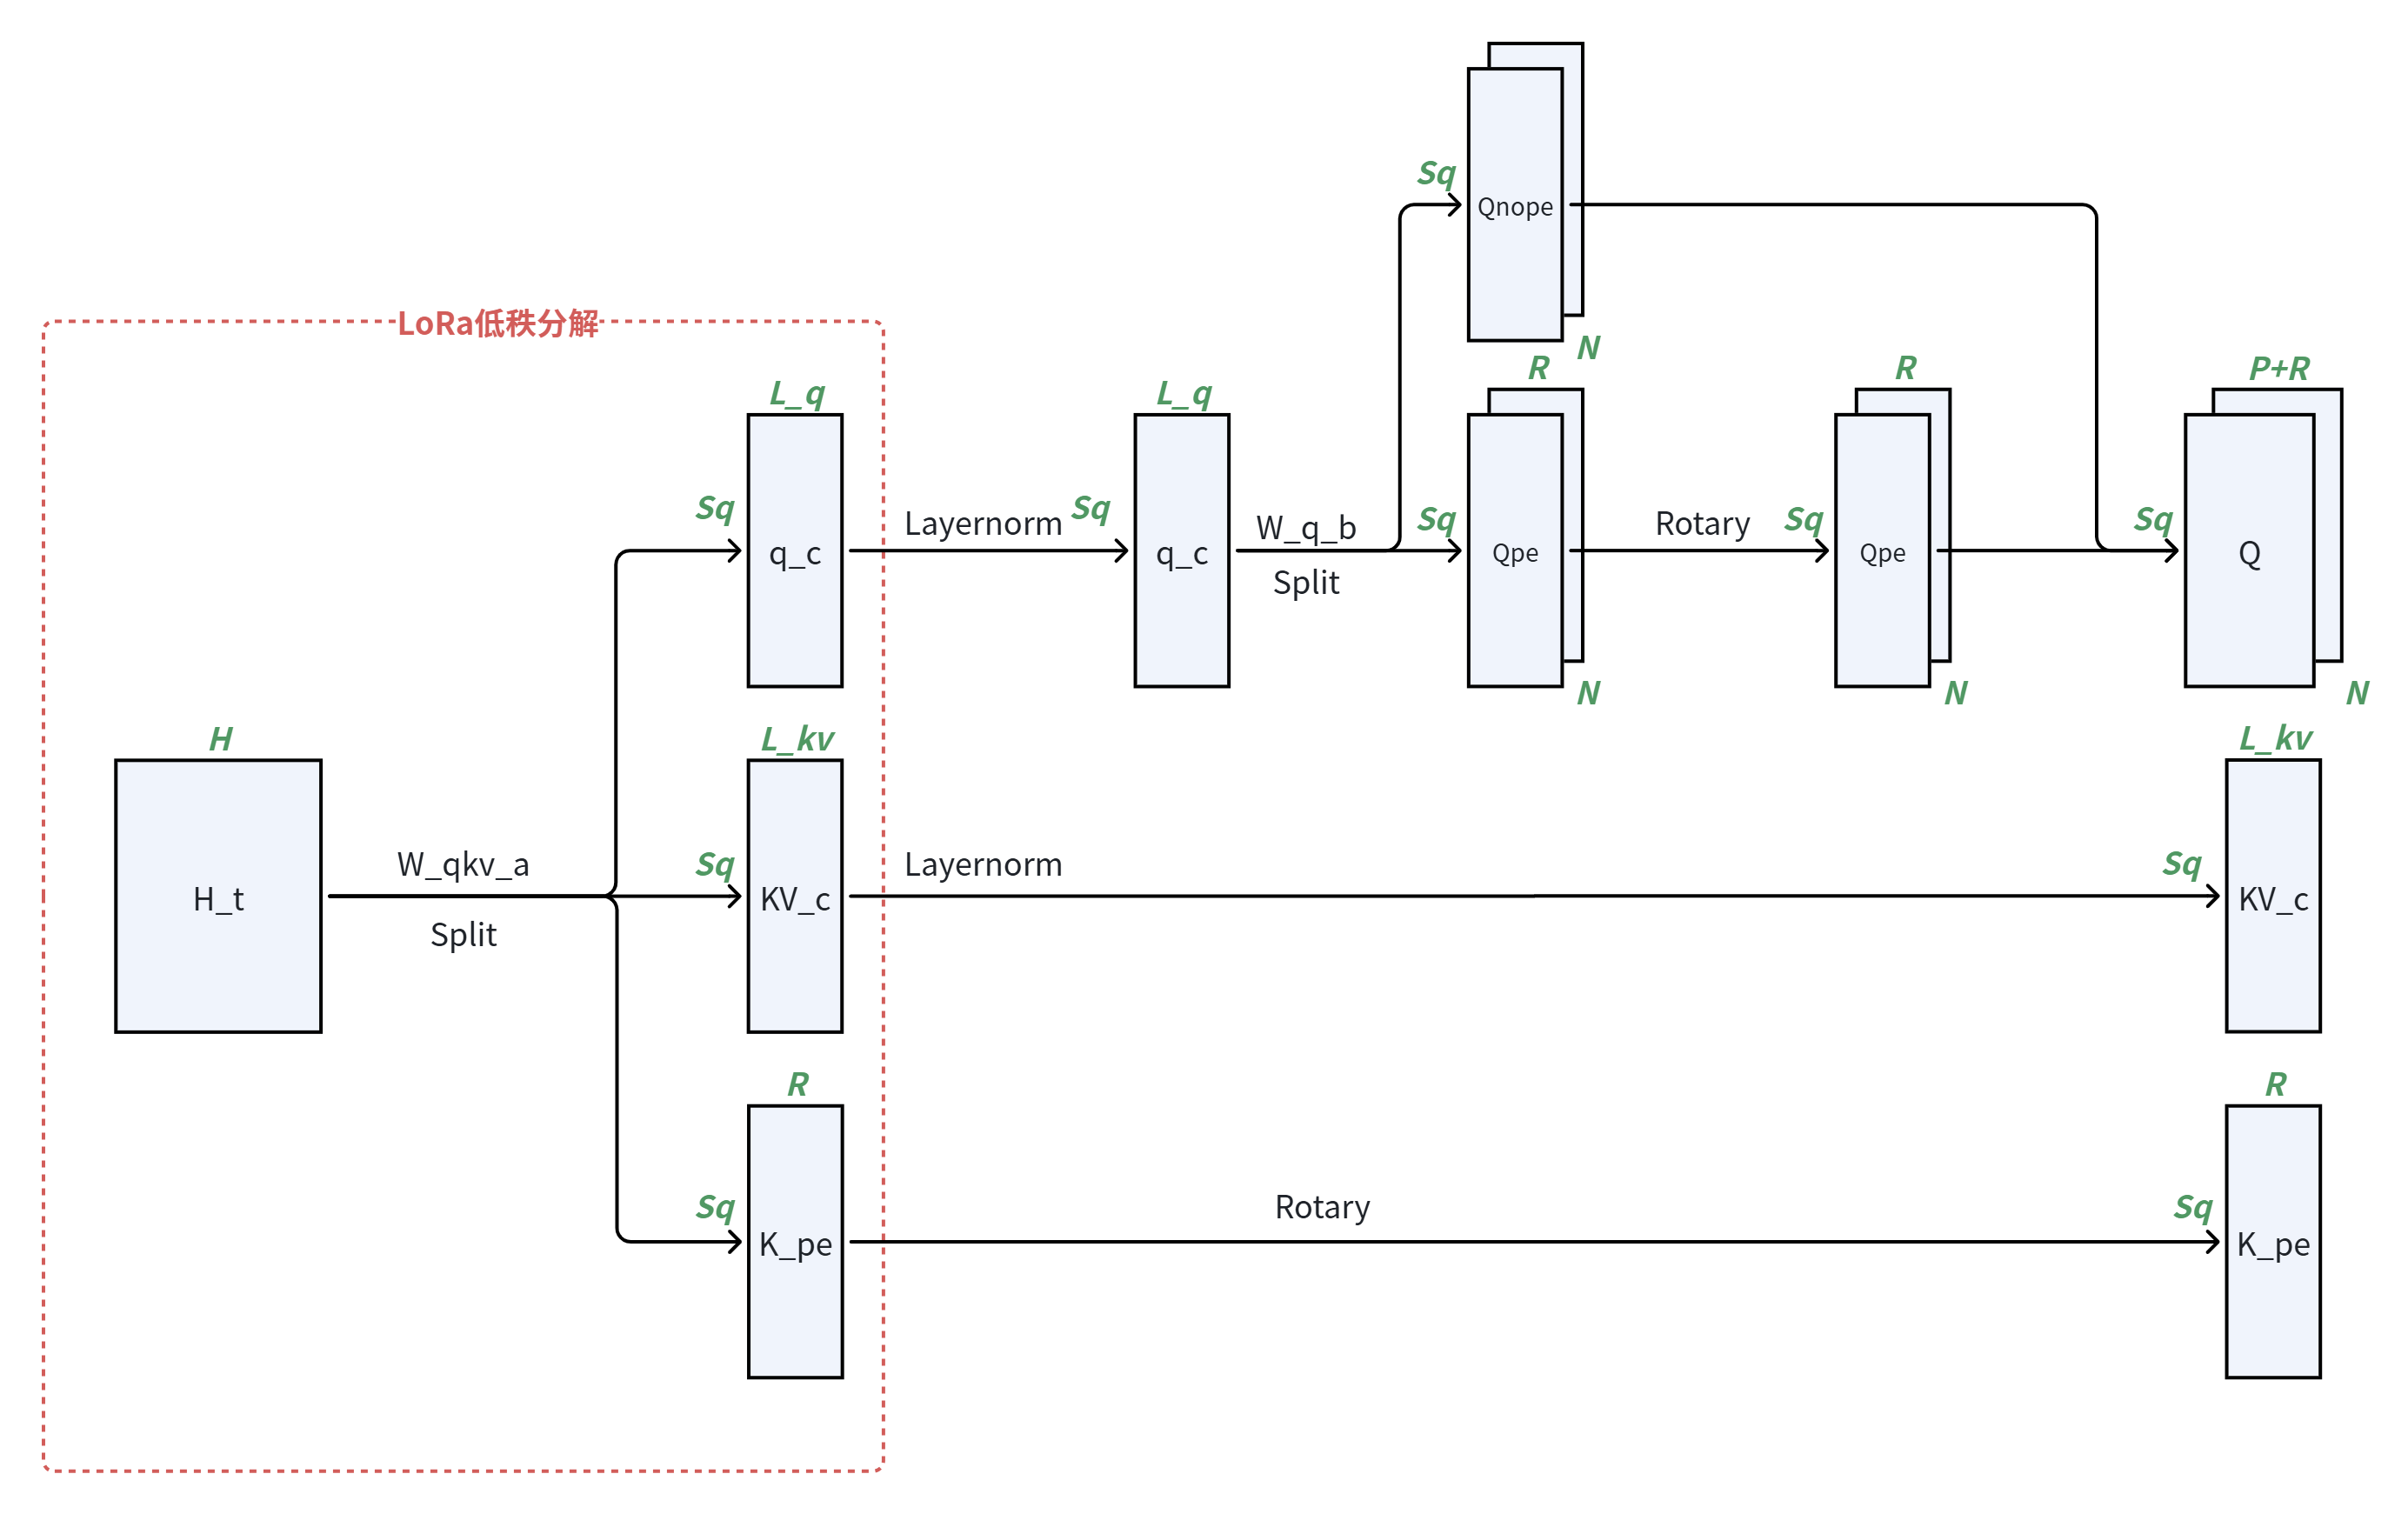
就是位置编码单独作为一个低维的小向量,并将q / k与他们concat起来之后再做乘法,也就是
q t , i T × k j , i = [ q t , i C , q t , i R ] T × [ k j , i C , k j , i R ] = q t , i C k j , i C + q t , i R k j , i R q_{t,i}^T \times k_{j,i} = \left[ q_{t,i}^C, q_{t,i}^R \right]^T \times \left[ k_{j,i}^C, k_{j,i}^R \right] = q_{t,i}^C k_{j,i}^C + q_{t,i}^R k_{j,i}^R
q t , i T × k j , i = [ q t , i C , q t , i R ] T × [ k j , i C , k j , i R ] = q t , i C k j , i C + q t , i R k j , i R
这样让位置编码自己一边玩去
S m ( x T W D q W U q ⏟ query W k T W U T W D T X ⏟ 向下投影 ⏟ 向上投影 ⏟ key 路径 ) ( X T W D ) ⏟ 向下投影 W U ⏟ 向上投影 W v ⏟ value 路径 W o Sm\left( \underbrace{x^T W_{Dq} W_{Uq}}_{\text{query}} \underbrace{W_k^T \underbrace{W_U^T \underbrace{W_D^T X}_{\text{向下投影}} }_{\text{向上投影}} }_{\text{key 路径}} \right) \underbrace{ \underbrace{\underbrace{(X^T W_D)}_{\text{向下投影}} W_U}_{\text{向上投影}} W_v }_{\text{value 路径}} W_o
S m ⎝ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎛ query x T W D q W U q key 路径 W k T 向上投影 W U T 向下投影 W D T X ⎠ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎞ value 路径 向上投影 向下投影 ( X T W D ) W U W v W o
和mla的公式对应
S m ( x T W D q ⏟ c q W U q W k T W U T ⏟ W U K W D T X ⏟ c k v ) ( X T W D ) ⏟ c k v W U W v ⏟ W U V W o Sm( \underbrace{x^T W_{Dq}}_{c_q} W_{Uq}\underbrace{W_k^T W_U^T}_{W_{UK}} \underbrace{W_D^T X}_{c_{kv}}) \underbrace{(X^T W_D)}_{c_{kv}} \underbrace{W_U W_v }_{W_{UV}} W_o
S m ( c q x T W D q W U q W U K W k T W U T c k v W D T X ) c k v ( X T W D ) W U V W U W v W o
借用一下老板的示意图,也就是这里多加了一个rope的分支
以下是废稿,留着备用
还有什么更好的trade-off呢?deepseek提出了类似于LoRA的方式,对X X X
要缓存的对象进一步减小
使用结合律可以提前计算得到升维的W U W_U W U W v / W k W_v/W_k W v / W k
不考虑位置编码 的情况下,我们把attention的公式展开为
S m ( x T W D q W U q ⏟ query W k T W U T W D T X ⏟ 向下投影 ⏟ 向上投影 ⏟ key 路径 ) ( X T W D ) ⏟ 向下投影 W U ⏟ 向上投影 W v ⏟ value 路径 W o Sm\left( \underbrace{x^T W_{Dq} W_{Uq}}_{\text{query}} \underbrace{W_k^T \underbrace{W_U^T \underbrace{W_D^T X}_{\text{向下投影}} }_{\text{向上投影}} }_{\text{key 路径}} \right) \underbrace{ \underbrace{\underbrace{(X^T W_D)}_{\text{向下投影}} W_U}_{\text{向上投影}} W_v }_{\text{value 路径}} W_o
S m ⎝ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎜ ⎛ query x T W D q W U q key 路径 W k T 向上投影 W U T 向下投影 W D T X ⎠ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎟ ⎞ value 路径 向上投影 向下投影 ( X T W D ) W U W v W o
要缓存的对象就是向下投影后的结果c k v c_{kv} c k v W U W_U W U W v / W k W_v/W_k W v / W k W U K , W U V W_{UK},W_{UV} W U K , W U V W q W U K T W_qW_{UK}^T W q W U K T c c c
但是加入位置编码 之后,由于RoPE运算和低秩的kv不兼容,换句话说就是两个权重矩阵的中间会夹着一个位置的编码
q t , i T × k j , i = ( R t W ( i ) U Q c t Q ) T × R j W ( i ) U K c j K V = ( c t Q ) T × ( W ( i ) U Q ) T R t T R j W ( i ) U K c j K V = ( c t Q ) T × ( W ( i ) U Q ) T R t − j W ( i ) U K × c j K V \begin{aligned} q_{t,i}^T \times k_{j,i} &= (\mathcal{R}_t W_{(i)}^{UQ} c_t^Q)^T \times \mathcal{R}_j W_{(i)}^{UK} c_j^{KV} \\ &= (c_t^Q)^T \times (W_{(i)}^{UQ})^T \mathcal{R}_t^T \mathcal{R}_j W_{(i)}^{UK} c_j^{KV} \\ &= (c_t^Q)^T \times (W_{(i)}^{UQ})^T \mathcal{R}_{t-j} W_{(i)}^{UK} \times c_j^{KV} \quad \end{aligned}
q t , i T × k j , i = ( R t W ( i ) U Q c t Q ) T × R j W ( i ) U K c j K V = ( c t Q ) T × ( W ( i ) U Q ) T R t T R j W ( i ) U K c j K V = ( c t Q ) T × ( W ( i ) U Q ) T R t − j W ( i ) U K × c j K V
这就导致结合律无法被提前使用,计算开销会上升到和先计算 K K K
q t , i T × k j , i = [ q t , i C , q t , i R ] T × [ k j , i C , k j , i R ] = q t , i C k j , i C + q t , i R k j , i R q_{t,i}^T \times k_{j,i} = \left[ q_{t,i}^C, q_{t,i}^R \right]^T \times \left[ k_{j,i}^C, k_{j,i}^R \right] = q_{t,i}^C k_{j,i}^C + q_{t,i}^R k_{j,i}^R
q t , i T × k j , i = [ q t , i C , q t , i R ] T × [ k j , i C , k j , i R ] = q t , i C k j , i C + q t , i R k j , i R
这样让位置编码自己一边玩去
而在完成了latent和rope的协调之后,mla成功完成了减少cache的目的;
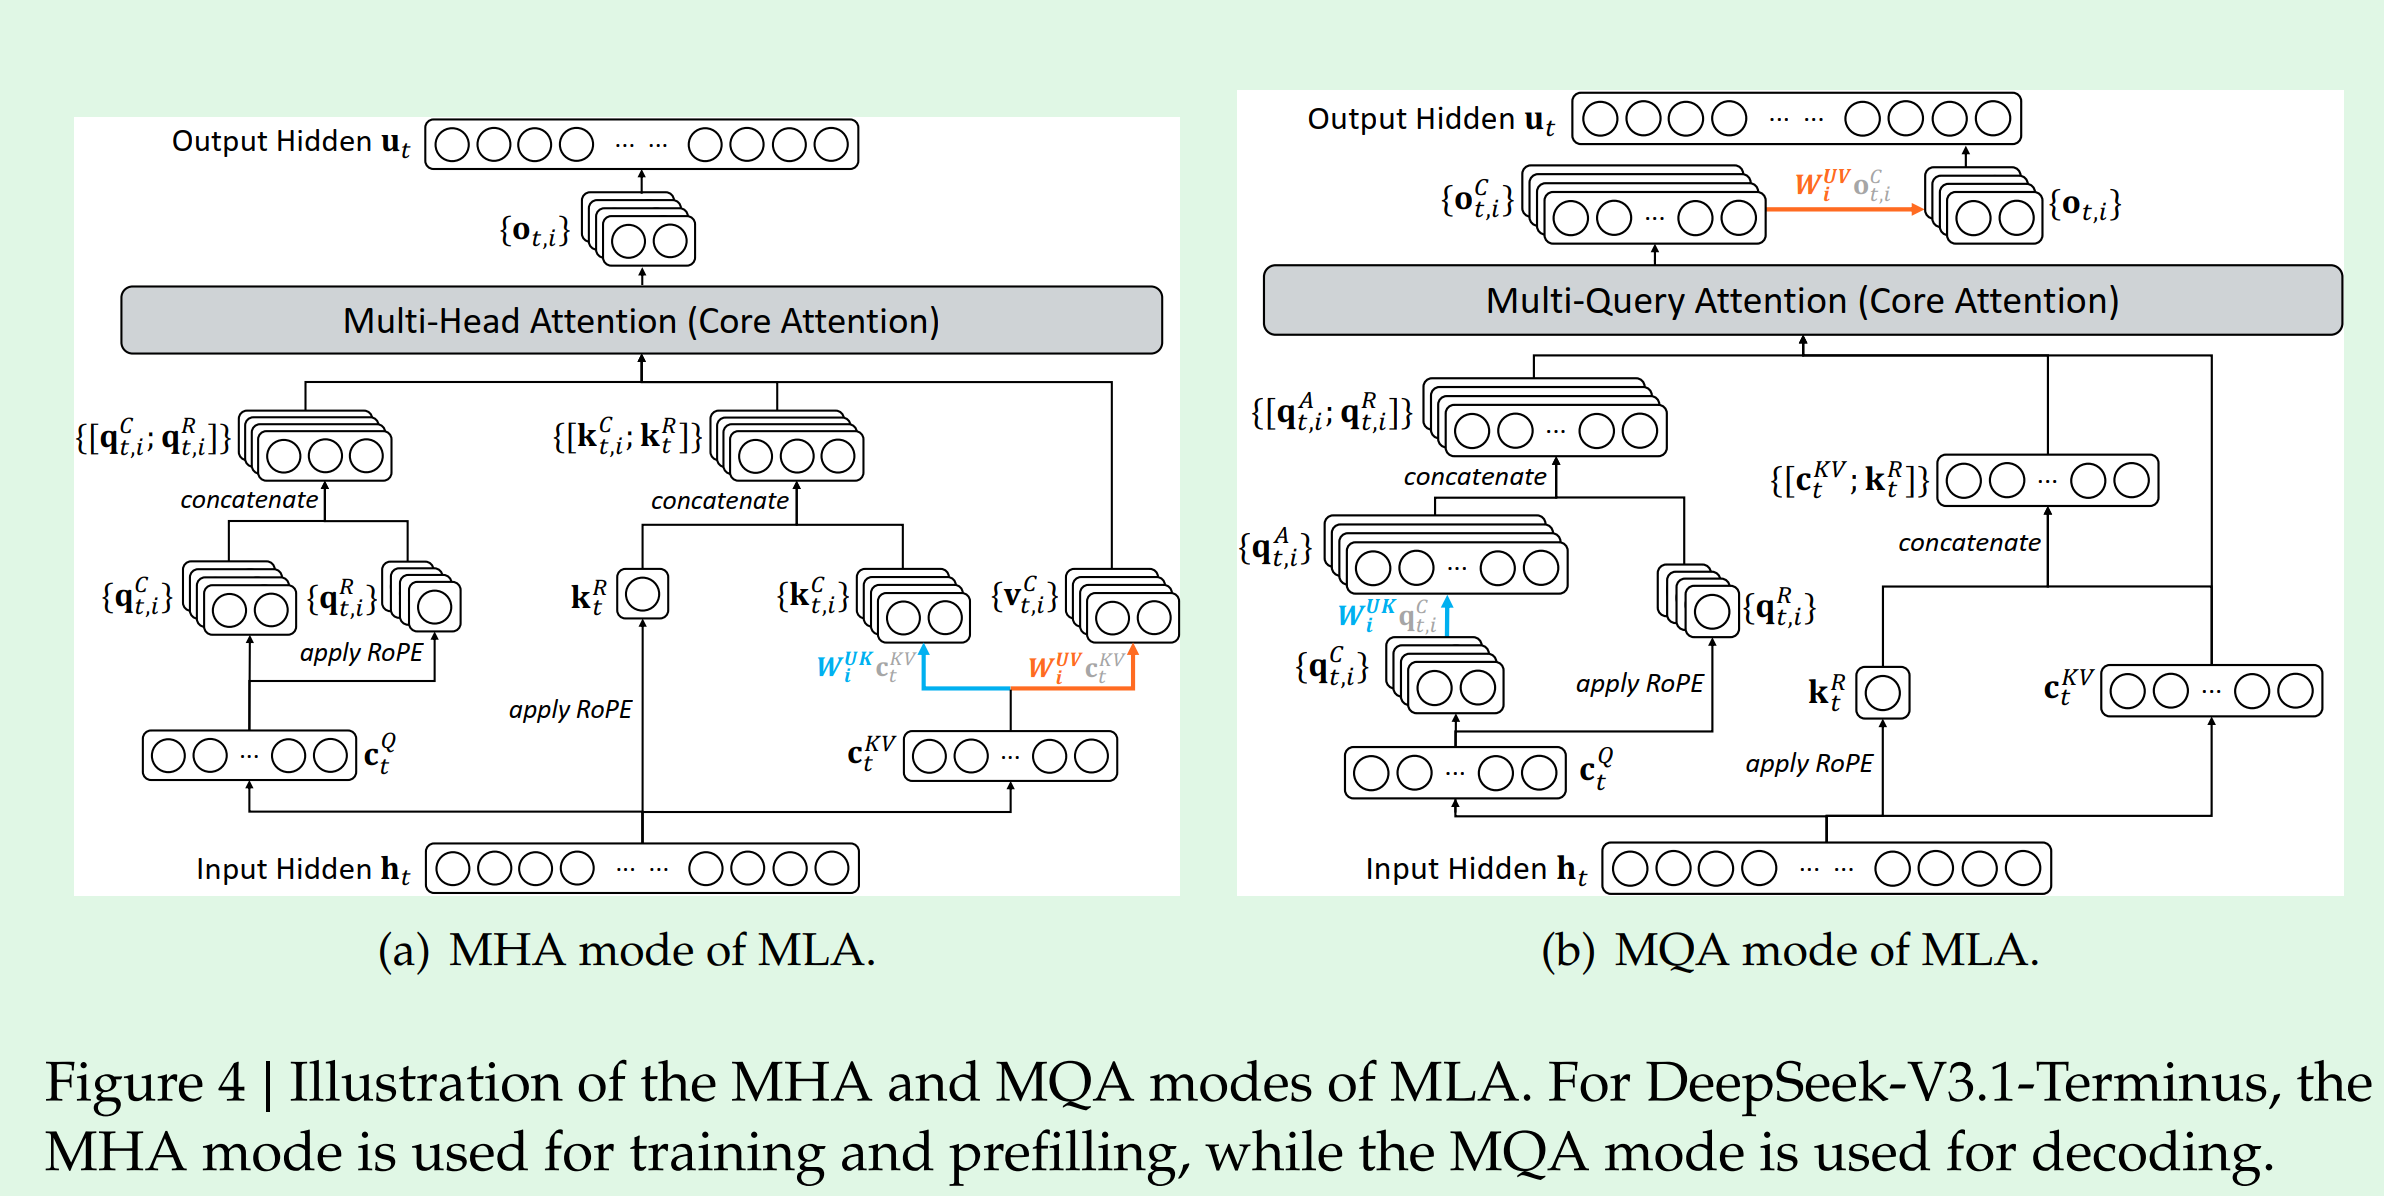
与此同时解耦rope还带来了一个礼物–LoRA的结合律:当mla把中间的投影矩阵等等利用结合律吸收到q的时候,形成了一种“变体”的mqa,面向了memory bound的情境;而如果不进行这个结合,先对KV进行还原再计算,计算量大概是mqa mode的1/4左右,但是还原之后会占更多的显存,可以面向compute bound
这样就可以在面向compute/memory bound去更好的利用计算的模式
刚刚所说的把RoPE单独提取出来,就是为了能把上投影矩阵吸收到前面q的还原中进行一个q c W U q W U K T q_cW_{Uq}W_{UK}^T q c W U q W U K T c t K V c_t^{KV} c t K V
训练/prefill的时候不用吸收。
废稿:因为mla是计算和空间的trade-off,decode的时候对空间要求多,但是训练/prefill的bound是算力。开启吸收会额外增加3-4倍的计算
参考知乎博客1 ,非吸收:
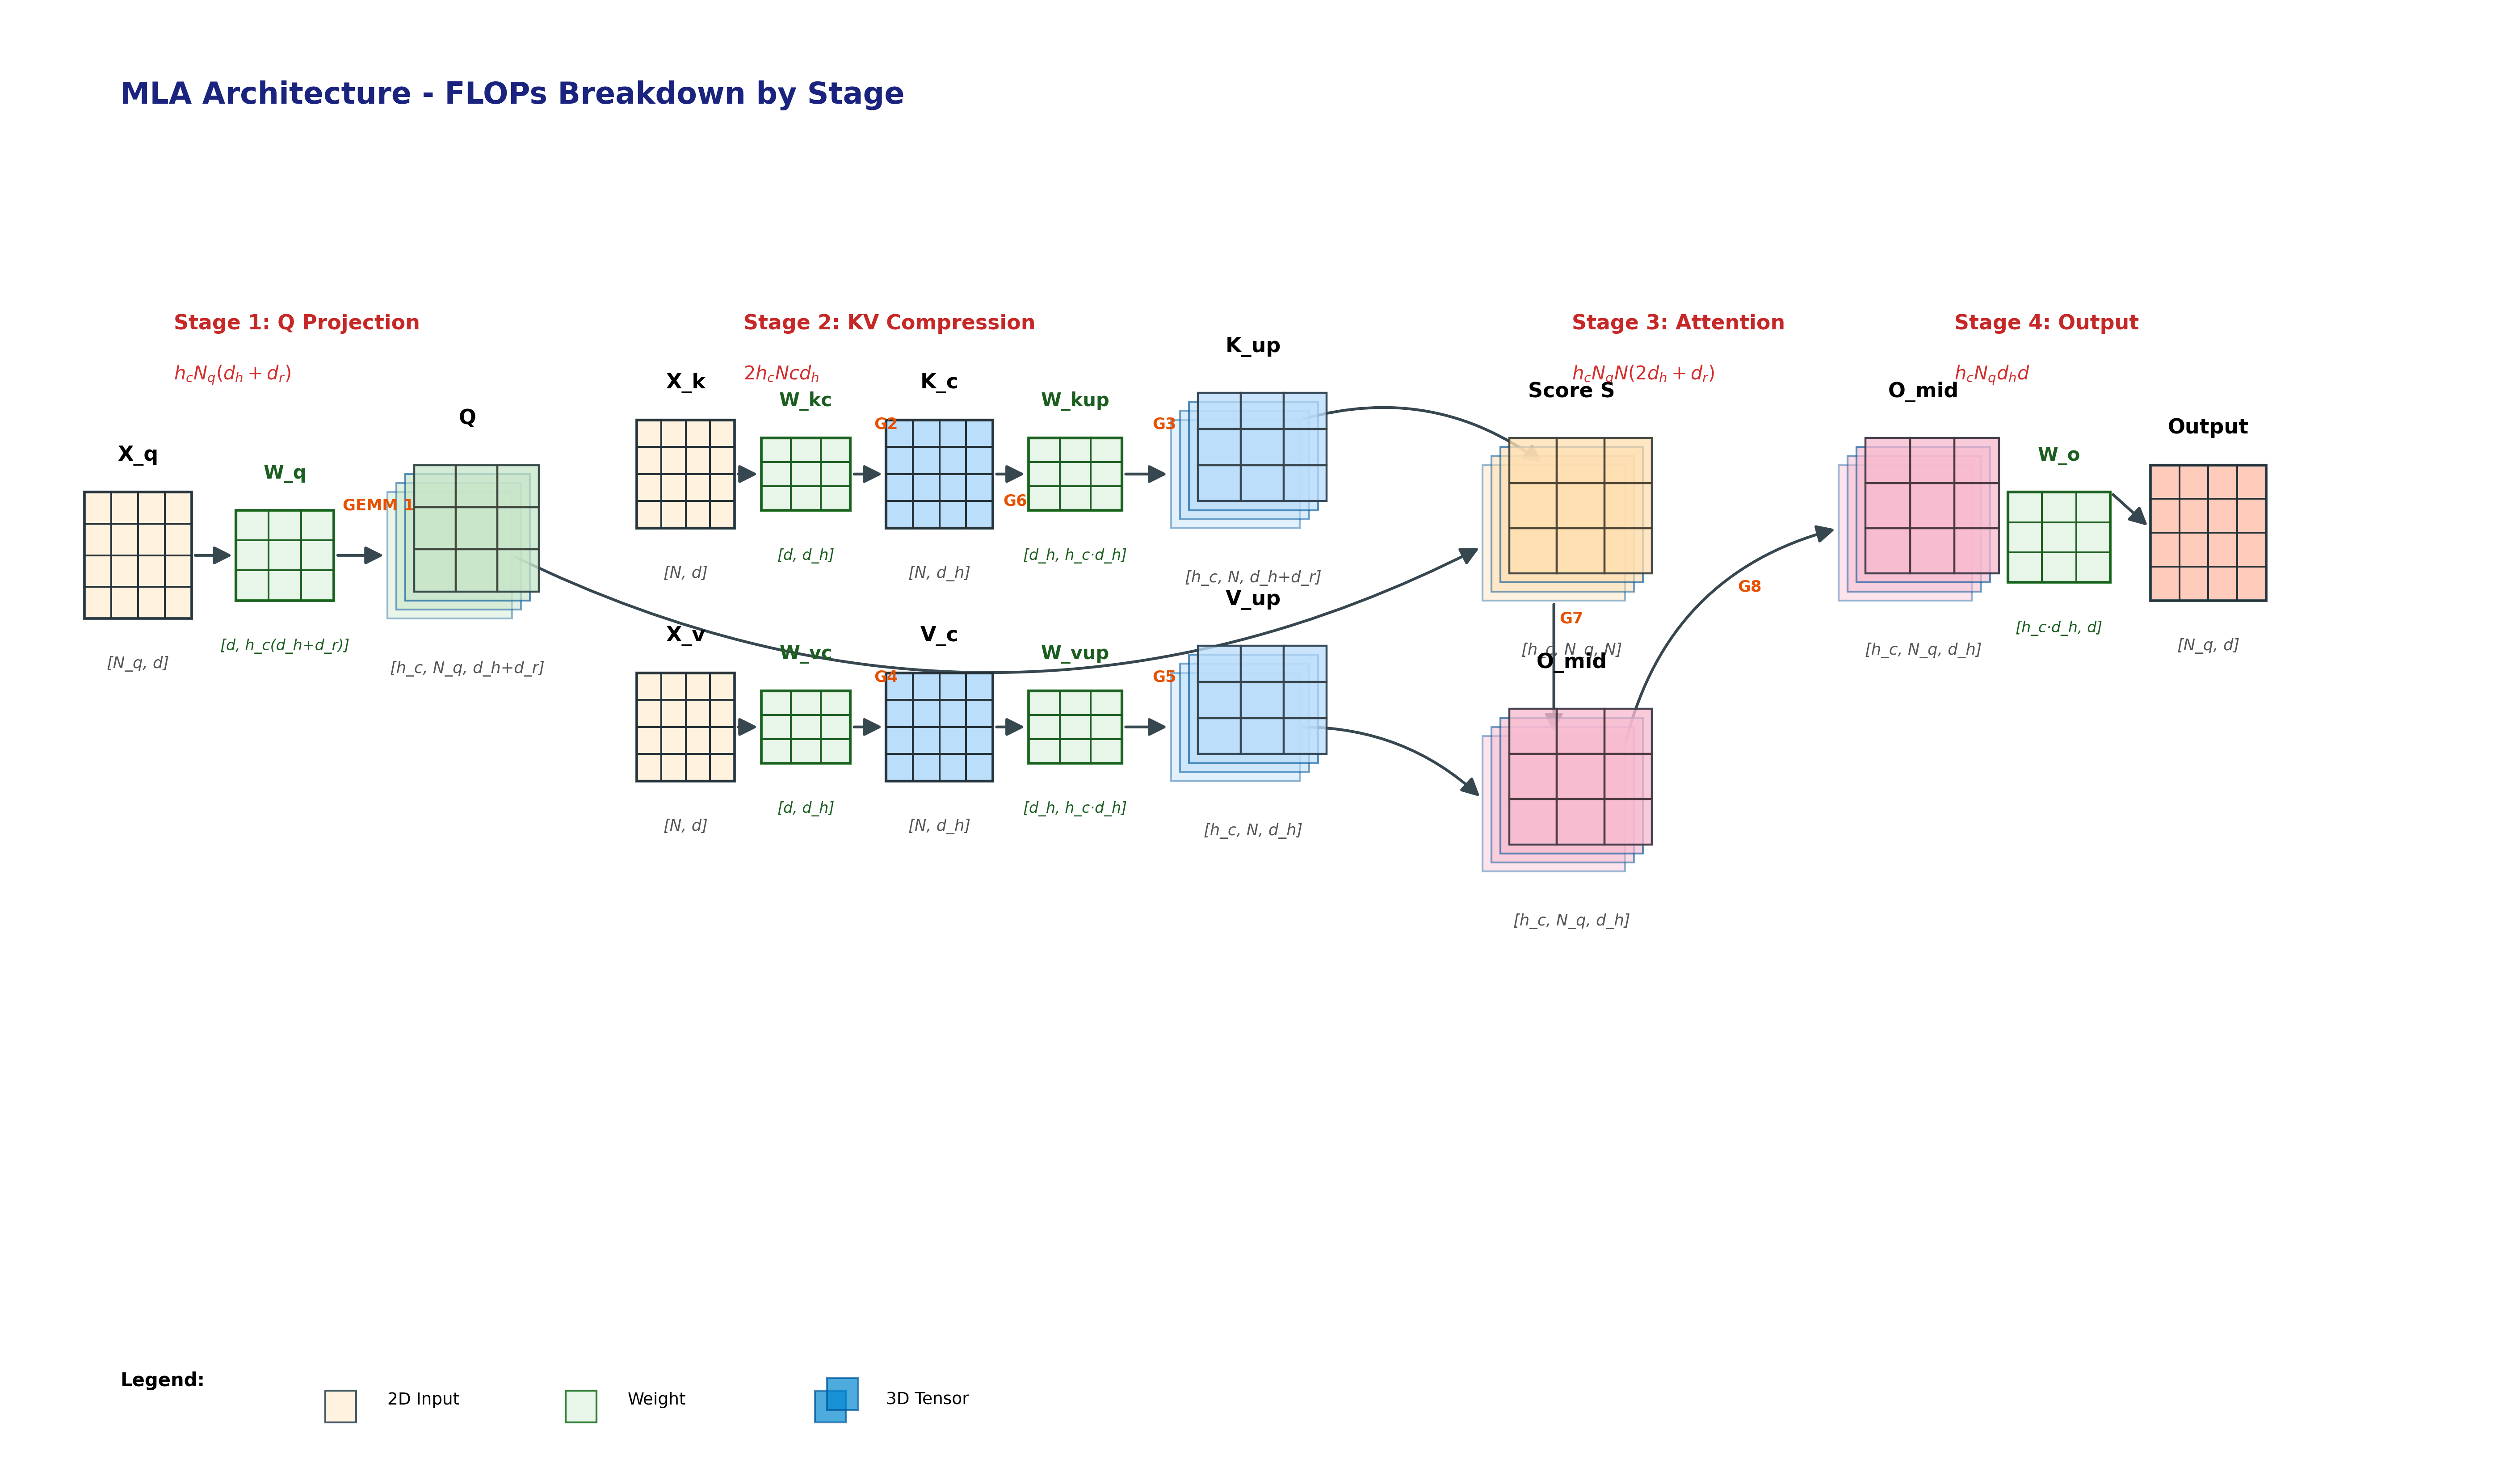
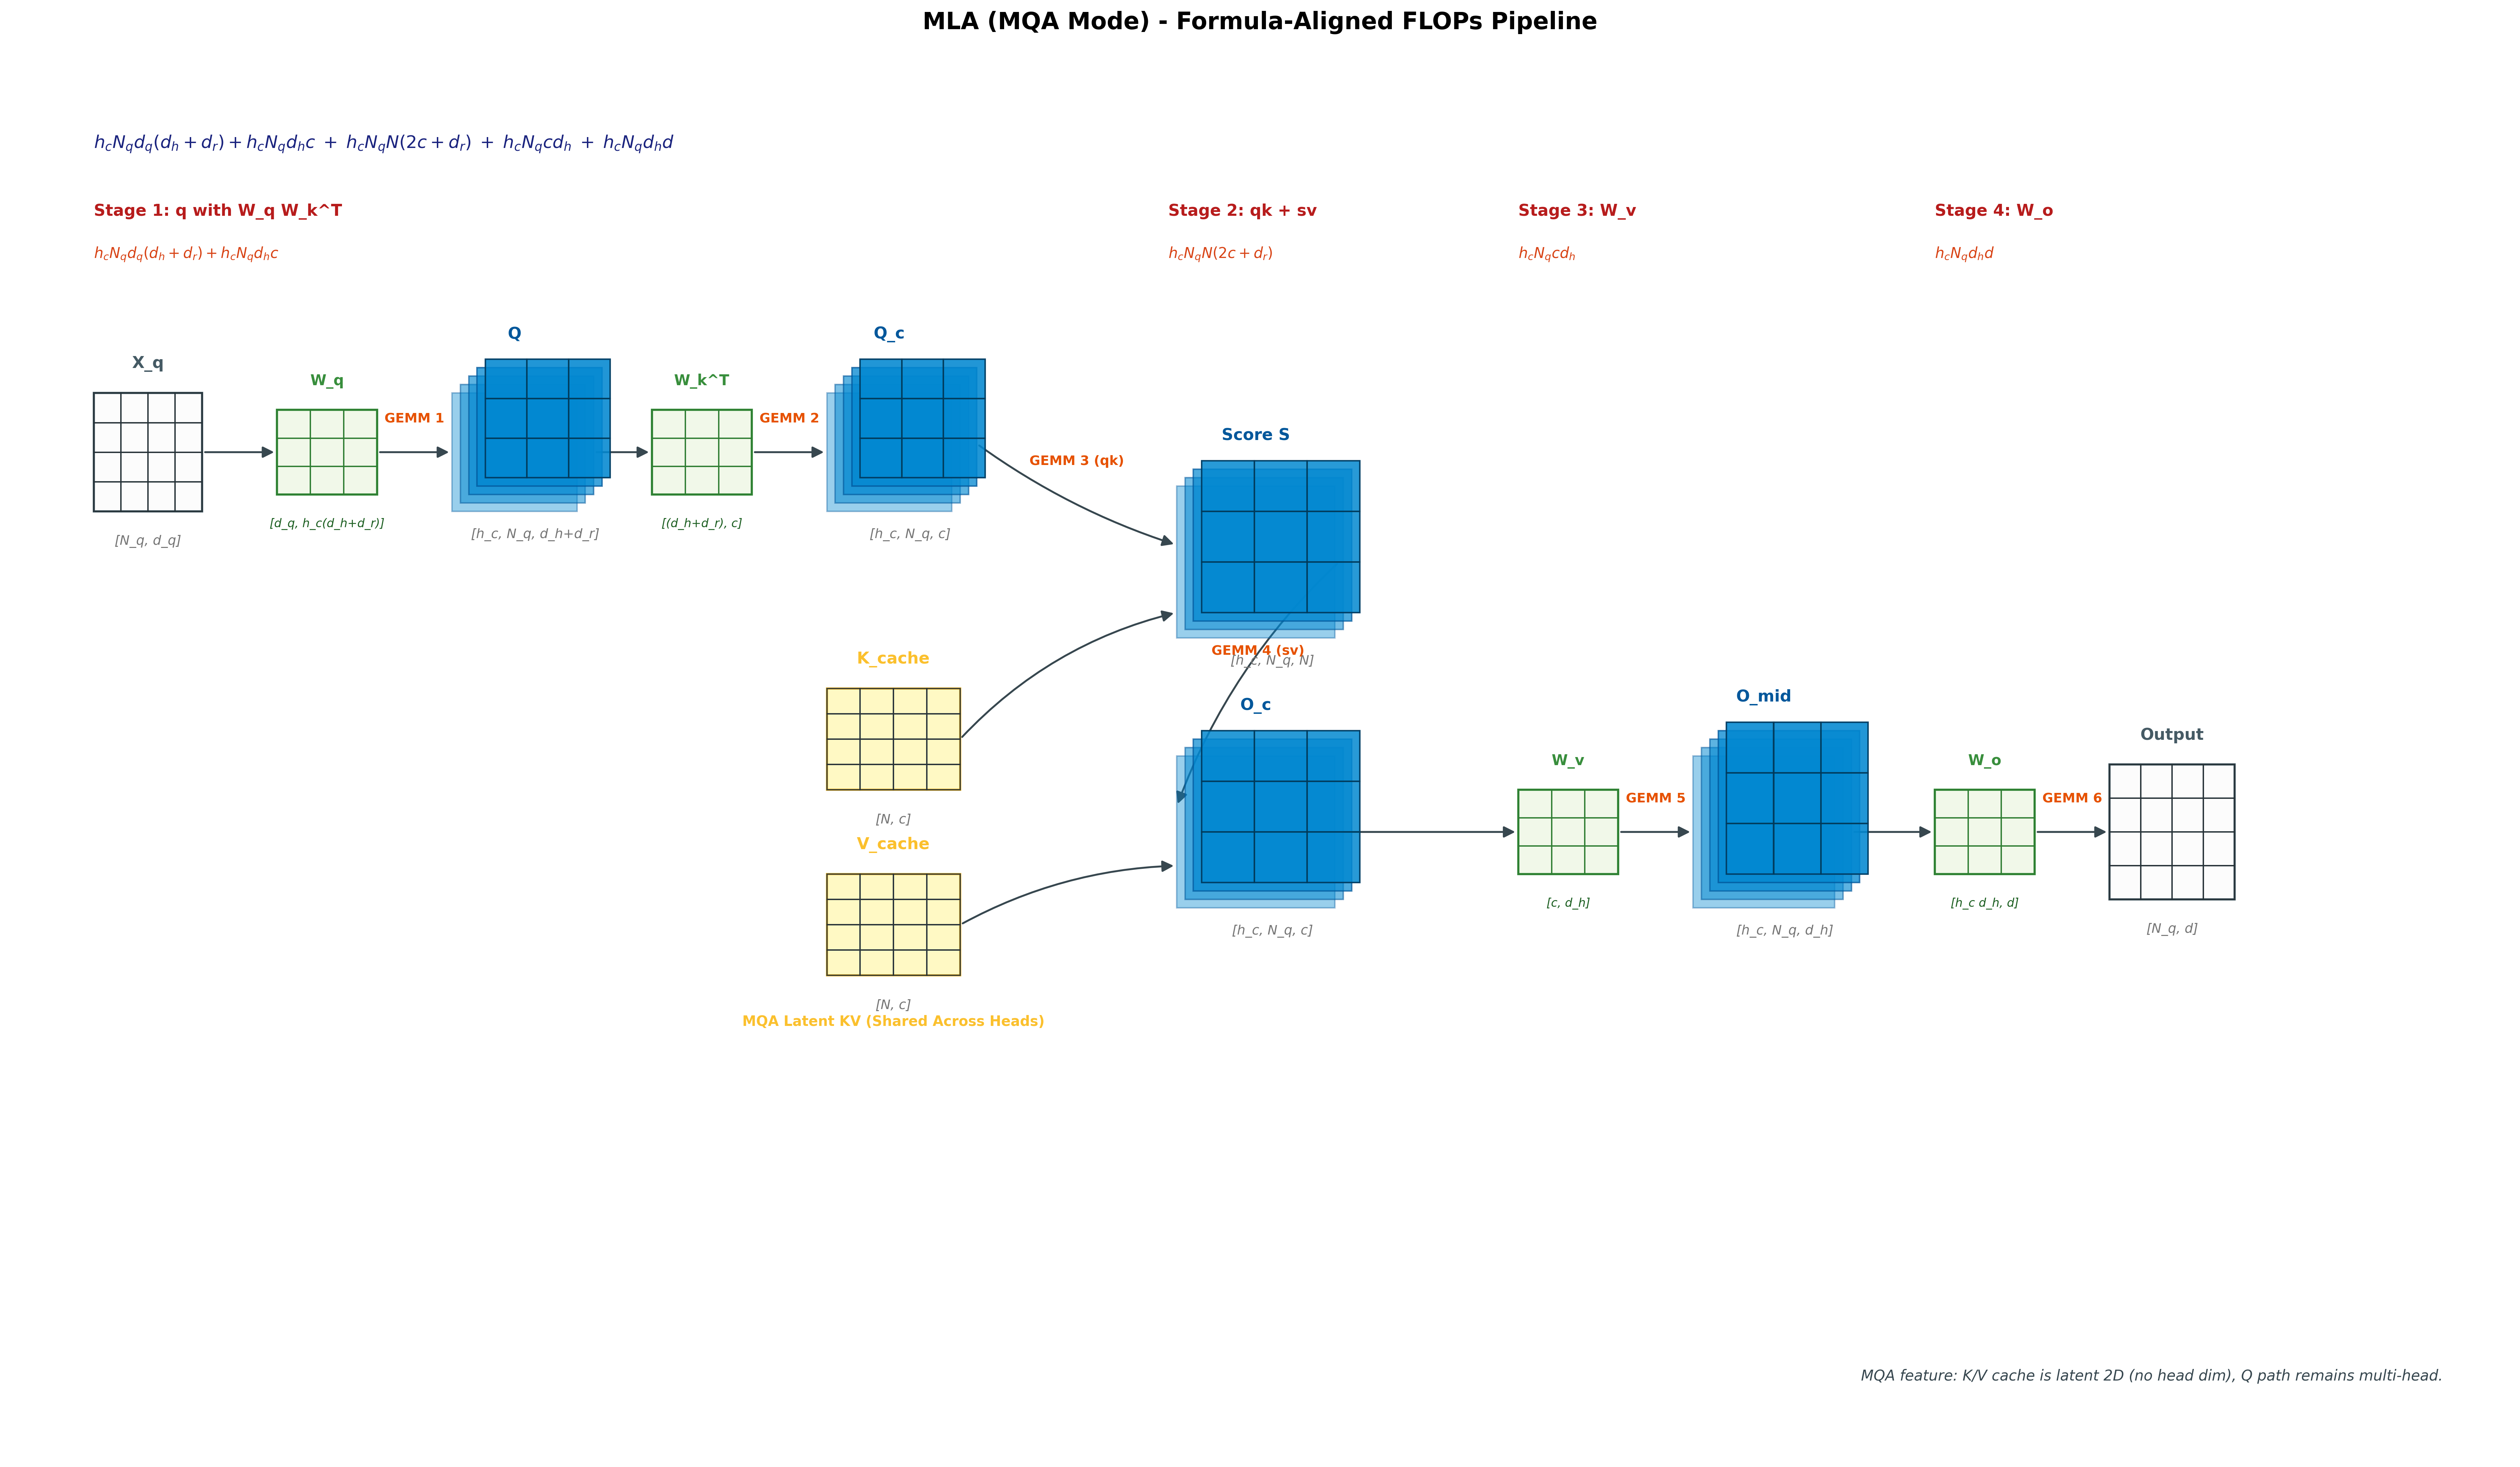
h c N q d q ( d h + d r ) ⏟ q to 128 heads + 2 h c N c d h ⏟ c to k 128 heads + h c N q N ( 2 d h + d r ) ⏟ q k ⊤ + s v + h c N q d h d ⏟ o \underbrace{h_c N_q d_q (d_h + d_r)}_{\text{q to 128 heads}} + \underbrace{2h_c N c d_h}_{\text{c to k 128 heads}} + \underbrace{h_c N_q N (2d_h + d_r)}_{qk^\top + sv} + \underbrace{h_c N_q d_h d}_{o}
q to 128 heads h c N q d q ( d h + d r ) + c to k 128 heads 2 h c N c d h + q k ⊤ + s v h c N q N ( 2 d h + d r ) + o h c N q d h d
吸收:
h c N q d q ( d h + d r ) + h c N q d h c ⏟ q with W q W k ⊤ + h c N q N ( 2 c + d r ) ⏟ q k + s v + h c N q c d h ⏟ W v + h c N q d h d ⏟ W o \underbrace{h_c N_q d_q (d_h + d_r) + h_c N_q d_h c}_{\text{q with } W_q W_k^\top} + \underbrace{h_c N_q N (2c + d_r)}_{qk + sv} + \underbrace{h_c N_q c d_h}_{W_v} + \underbrace{h_c N_q d_h d}_{W_o}
q with W q W k ⊤ h c N q d q ( d h + d r ) + h c N q d h c + q k + s v h c N q N ( 2 c + d r ) + W v h c N q c d h + W o h c N q d h d
这里d r d_r d r N q N_q N q 2 h c N q N ( d h − c ) + 2 h c d h c ( N − N q ) 2 h_c N_q N (d_h - c) + 2 h_c d_h c ( N - N_q) 2 h c N q N ( d h − c ) + 2 h c d h c ( N − N q )
prefill阶段的N = N q N=N_q N = N q ≈ O ( N 2 ( 2 d h + d r ) ) \approx O(N^2(2d_h + d_r)) ≈ O ( N 2 ( 2 d h + d r ) ) ≈ O ( N 2 ( 2 c + d r ) ) \approx O(N^2(2c + d_r)) ≈ O ( N 2 ( 2 c + d r ) )
decode阶段则是N q = 1 N_q = 1 N q = 1 ≈ O ( N ( 2 c d h + 2 d h + d r ) ) \approx O(N(2 c d_h + 2d_h + d_r)) ≈ O ( N ( 2 c d h + 2 d h + d r ) ) ≈ O ( N ( 2 c + d r ) ) \approx O(N(2c + d_r)) ≈ O ( N ( 2 c + d r ) )
到这里我对mla的理解就已经基本结束了,但是这只是在数学公式的基础上加上自己的理解
因为公式是死的,只要在不违背公式的基础上进行解释都是没有错的,但是这个“故事”是否就是mla本来的含义,在这篇MLA为什么好 的评论里也有讨论,其实两种理解思路我都挺赞同的,无论是“从mqa的角度”还是从“latent的角度”,都是对这个故事的一种解读,只是从设计理念 上来说,哪个是更贴近ds团队原本的想法
但是解读免不了是从某个角度出发的一个连续性的叙事 ,而mla诞生的故事就像苏老师博客里说的在处理rope的时候是有过一些“挣扎”的。这个故事不是一蹴而就的,而是在探索中去找到了解耦rope和利用lora压缩cache的一个平衡
前两天我一直在思考这个故事性的问题,因为我感觉只有理清楚这个故事才能真正学习到算法设计的思维。但是算法不是一气呵成浑然天成写出来的;如果这种故事都是后天解释的,那么也几乎不可以去寻求到一个根本的方法论
能做到最好的就是去还原 paper 里ds团队展示出来的故事,至于这种“方法论”,需要在对矛盾的观察、解决方案的思考、遇到矛盾怎么权衡 这个的具体的实践中学习到
[x] 对于权重矩阵结合之后能节省多少的计算量还是没什么量化的概念,有空来补齐一下
[x] 而且降维之后的效果如何,为什么能够进行降维,这部分还没研究
与其说是为什么能降维,不如说是降维之后为什么还能媲美mha的效果?
[x] 更新一下几个点
原始版本的官方demo里,prefill 是 MHA,decode是 MQA huggingface
据说因为是DSA demo直接从 MLA 的代码改过来的,所以直接沿用了
但是在SGLang的实现 里似乎有所不同,prefill阶段根据seq_len的不同,短的使用 standard MHA 并补全 latent cache,长的则使用的是 MLA(MQA mode)
引出了一个问题 :短序列直接使用 standard MHA 是可以理解的,但是再长一点为什么不使用 MHA mode 的 MLA,而是使用MQA mode 的 MLA? 也就是说 prefill / training 的限制仍然不是算力,而是访存的瓶颈?
还是说是MQA能更好的利用硬件?
[ ] DSA的两种模式从数学上是等价的,但是在浮点运算中使用结合律,精度上的损失是不可避免的,这是否会产生影响?
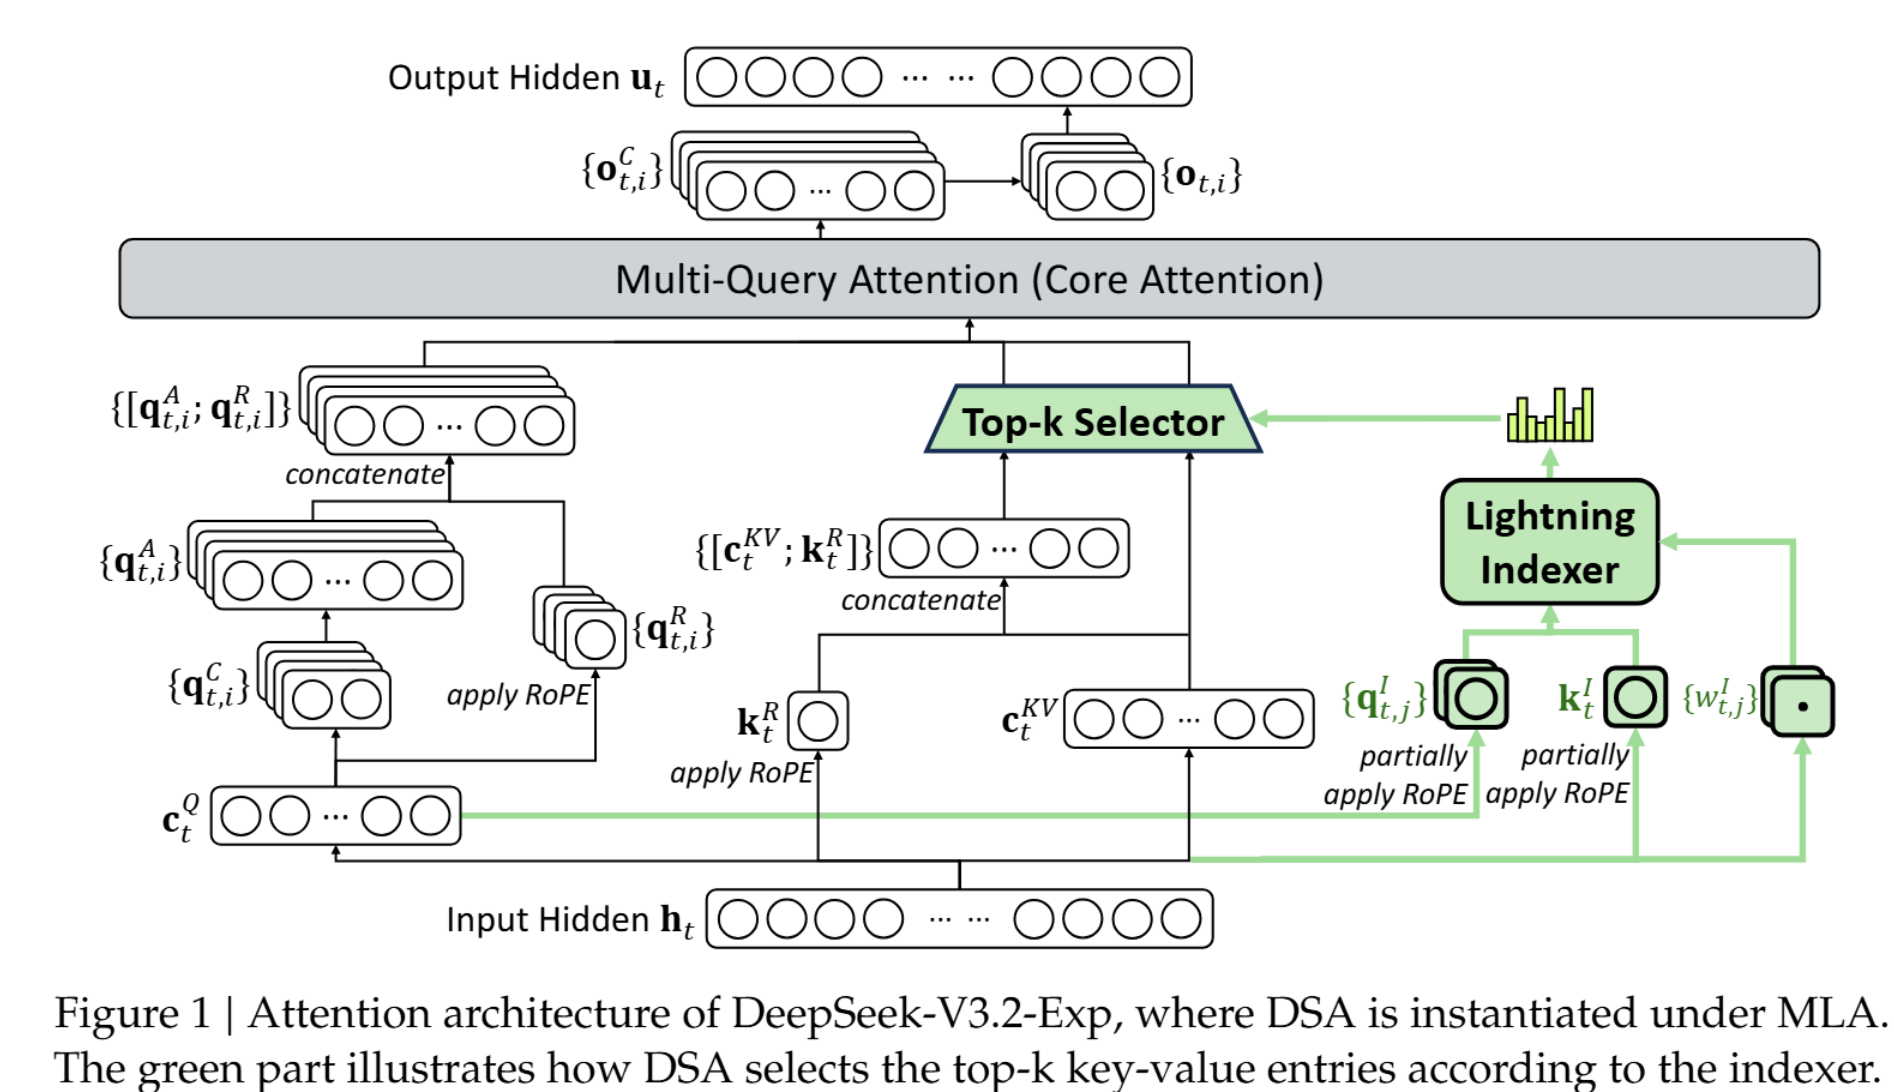
如图,DSA就是在MQA模式的MLA 的基础上再应用了一个sparse attention,要想获得这个attn,需要两个功能部件:
给所有的 K/V 进行相关性的排名
选取分数高的进行注意力计算
对应到图中的两个模块分别是:
Lightning Indexer
Top-k Selector
获得 k/v 的相关性本来就是attention的工作,这个信息在进行attn计算之前是未知的。因此这里本质上就是要用更小的cost,做一个更轻量 的 attention 去提前获得 tokens 之间的信息,计算公式如下
I t , s = ∑ j = 1 H I w i , j I ⋅ ReLU ( q i , j I ⋅ k s I ) I_{t,s} = \sum_{j=1}^{H^I} w_{i,j}^I \cdot \text{ReLU}(q_{i,j}^I \cdot k_s^I)
I t , s = j = 1 ∑ H I w i , j I ⋅ ReLU ( q i , j I ⋅ k s I )
其中I t , s I_{t,s} I t , s t t t s s s q i , j I q_{i,j}^I q i , j I w i , j I w_{i,j}^I w i , j I k s I k_s^I k s I
其实将R e L U ReLU R e L U s o f t m a x softmax s o f t m a x w i , j I w_{i,j}^I w i , j I
这里的计算和MLA一样采用了RoPE的分离的方法
TODO 计算量的估计:
根据分数做了一个动态的稀疏,理想情况下是和mask的设置为 -inf 不同,这里直接不计算特定的kv,节省计算。为此就需要设计一些特定的稀疏算子,而它的主要难点就是在于这里跳过一些kv造成的内存访问的不规则性
Memory Bandwidth 的限制:传统的算子(直接引入掩码)主要是稠密计算,可以很好地利用数据的局部性,而稀疏访问可能导致大量的非连续内存读取,降低缓存命中率
Load Balance :如果一张卡里不同线程处理的稀疏块的大小不同,会造成 Warp Divergence,导致计算效率的下降
Indexing Overhead:需要额外的索引信息
在 DSA 中,采用 MQA-mode MLA 而非 MHA 的核心原因是否在于硬件执行效率?
MHA 中每个 Q 查询头对应独立 的 KV 键值头,不同注意力头会选出不同的 top-K 键值下标,所以最终没有办法把多个 Q 查询头打包为适合 TensorCore 的大块送到 GEMM 进行计算。这种情况下只能通过 mask 屏蔽非 top-K 位置,或执行大量低效小尺寸 GEMM,使得 TensorCore 利用率极低,通常仅能达到理论峰值的几十分之一
而 MQA-mode MLA 让所有 Q 查询头共享同一组键值,所有头的 top-K 下标完全一致,支持全局统一的稀疏键值读取,无需分头加载或使用 mask 过滤,能够构造规整的大尺寸计算块,充分发挥 TensorCore 算力,在长序列场景下可逼近硬件理论性能上限;换句话说就是可以把多个 Q 打包到一块变成一个大块的,和 KV 进行 GEMM 的时候能打满 TensorCore 的算力
尽管 MQA-mode MLA 在 prefill 阶段的浮点计算量(FLOPs)高于标准 MHA,但长序列推理的瓶颈并非算力,而是显存带宽与计算单元利用率。MQA 通过稀疏访问仅加载实际需要的 top-K 键值,大幅降低访存量;同时规整的计算形状使算力利用率显著提升。这些优势带来的速度增益,远超过其额外 FLOPs 带来的开销,因此在长序列下 MQA-mode MLA 实际运行速度远快于 MHA
TODO·······
这是可以研究的一个地方?
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 def forward (self, x: torch.Tensor, start_pos: int , freqs_cis: torch.Tensor, mask: Optional [torch.Tensor] ): bsz, seqlen, _ = x.size() end_pos = start_pos + seqlen qr = self .q_norm(self .wq_a(x)) q = self .wq_b(qr) q = q.view(bsz, seqlen, self .n_local_heads, self .qk_head_dim) q_nope, q_pe = torch.split(q, [self .qk_nope_head_dim, self .qk_rope_head_dim], dim=-1 ) q_pe = apply_rotary_emb(q_pe, freqs_cis) kv = self .wkv_a(x) kv, k_pe = torch.split(kv, [self .kv_lora_rank, self .qk_rope_head_dim], dim=-1 ) kv = self .kv_norm(kv) k_pe = apply_rotary_emb(k_pe.unsqueeze(2 ), freqs_cis) self .kv_cache[:bsz, start_pos:end_pos] = kv self .pe_cache[:bsz, start_pos:end_pos] = k_pe.squeeze(2 ) if mask is not None : q = torch.cat([q_nope, q_pe], dim=-1 ) kv = self .wkv_b(kv) kv = kv.view(bsz, seqlen, self .n_local_heads, self .qk_nope_head_dim + self .v_head_dim) k_nope, v = torch.split(kv, [self .qk_nope_head_dim, self .v_head_dim], dim=-1 ) k = torch.cat([k_nope, k_pe.expand(-1 , -1 , self .n_local_heads, -1 )], dim=-1 ) scores = torch.einsum("bshd,bthd->bsht" , q.float (), k.float ()) * self .softmax_scale topk_indices = self .indexer(x, qr, start_pos, freqs_cis, mask) index_mask = torch.full((bsz, seqlen, seqlen), float ("-inf" ), device=x.device).scatter_(-1 , topk_indices, 0 ) index_mask += mask scores += index_mask.unsqueeze(2 ) scores = scores.softmax(dim=-1 , dtype=torch.float32) x = torch.einsum("bsht,bthd->bshd" , scores.type_as(x), v)
这个demo这里应该只是演示了一下逻辑,就是纯粹进行了额外的 0/1 掩码,并没有高效的使用算力
这里大概要写四个算子:
Q 生成融合算子:把wq_a → norm → wq_b → split → rope → cat融合成一个算子减少读写
KV 升维融合算子:把wkv_a → split → norm → wkv_b → split融合
QK^T + TopK 联合稀疏算子 :原生 PyTorch算完整 QK^T → 找 TopK → mask;定制算子:只计算 TopK 需要的 QK 对 → 不做无用计算
Softmax + Weighted Sum 融合算子softmax + dropout + scale + bmm融合成一个算子,避免多次读写
这里最重要的就是这个“稀疏”的算子的设计,目前应该是有两个方案:
使用真正的稀疏来节省算力
需要克服不连续访存带来的影响
或者使用 Gather,但是这个过程的overhead未知
和demo一样使用mask
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
else : if self .dequant_wkv_b is None and self .wkv_b.scale is not None : self .dequant_wkv_b = weight_dequant(self .wkv_b.weight, self .wkv_b.scale) wkv_b = self .wkv_b.weight if self .dequant_wkv_b is None else self .dequant_wkv_b wkv_b = wkv_b.view(self .n_local_heads, -1 , self .kv_lora_rank) q_nope = torch.einsum("bshd,hdc->bshc" , q_nope, wkv_b[:, :self .qk_nope_head_dim]) scores = (torch.einsum("bshc,btc->bsht" , q_nope, self .kv_cache[:bsz, :end_pos]) + torch.einsum("bshr,btr->bsht" , q_pe, self .pe_cache[:bsz, :end_pos])) * self .softmax_scale topk_indices = self .indexer(x, qr, start_pos, freqs_cis, mask) index_mask = torch.full((bsz, 1 , end_pos), float ("-inf" ), device=x.device).scatter_(-1 , topk_indices, 0 ) scores += index_mask.unsqueeze(2 ) scores = scores.softmax(dim=-1 ) x = torch.einsum("bsht,btc->bshc" , scores, self .kv_cache[:bsz, :end_pos]) x = torch.einsum("bshc,hdc->bshd" , x, wkv_b[:, -self .v_head_dim:]) x = self .wo(x.flatten(2 )) return x
Sparse KV Load
CTA 级 Tile 稀疏注意力算子
一个 CTA(线程块)干:
一批 Q(128 个)
低秩 Absorb 融合 算子
RoPE 位置编码融合算子
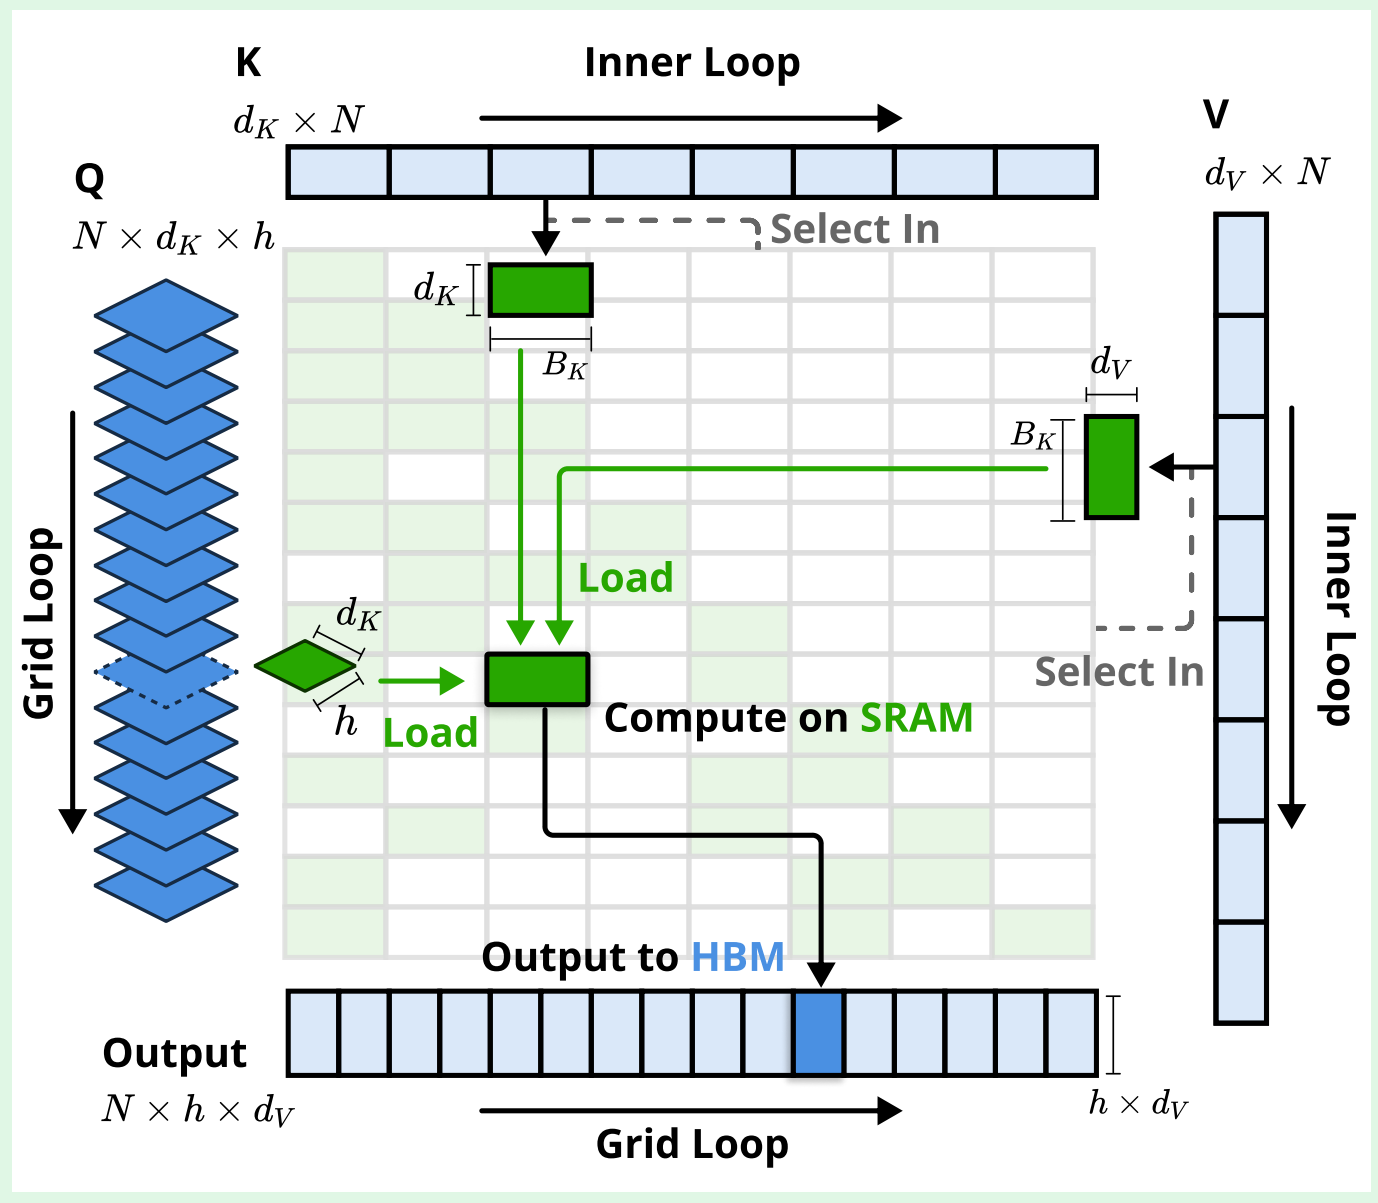
下图是 NSA (native sparse attention) 里设计的算子,下面可能会单独开一个章节去研究一下
目前看着就是在FA的基础上去做一个sparse的ignore?
未完待续
本篇只到算力分析层面,具体 kernel 和其他的分析比如compute bound 和 memory bound 的 trade off 单独开一篇SGLang中DSA的实现和相关分析
有关MLA的故事性让我思考了